Explorando el diseño de Super-agent: hacia sistemas de agentes más autónomos
Este artículo explora ideas de arquitectura desde una perspectiva de ingeniería. No es una introducción a las funciones actuales del producto DeepSeek Harness.
1. Super-agent
Durante el último año, los agentes centrados en una sola tarea, especialmente los de programación, han demostrado que los modelos pueden utilizar herramientas para resolver problemas complejos con cada vez menos supervisión humana continua e intervención paso a paso. Al mismo tiempo, los modelos coordinan mejor a varios agentes, lo que hace viable organizar y planificar el trabajo entre sesiones. A medida que disminuye la participación humana en los detalles de ejecución, el papel de las personas se desplaza hacia las decisiones de mayor nivel y la aceptación de los resultados.
Esta mejora de las capacidades de los modelos también está dando lugar a nuevas formas de aplicación. Últimamente han aparecido numerosos agentes personales. Se conectan directamente a la mensajería, los calendarios, el correo y las plataformas de trabajo cotidianas, observan continuamente los flujos de información y ayudan a gestionar tareas. Este funcionamiento continuo y basado en eventos no se limita al uso personal: los asistentes personales son solo una aplicación. También tiene valor en entornos profesionales como el desarrollo de software.
Sin embargo, los diseños de agentes predominantes todavía tienen dificultades para admitir este funcionamiento a la escala de varias tareas y de la colaboración en equipo. Los agentes siguen utilizando una única sesión (Session) como unidad básica de trabajo, y las sesiones permanecen independientes entre sí. Cuando los usuarios trabajan en varias cosas a la vez, deben cambiar manualmente de sesión y recordar el contexto de cada una. Según nuestras observaciones, una persona suele poder seguir solo entre tres y cinco sesiones activas a la vez. Con este diseño, la capacidad del modelo fija el límite de una tarea; la atención humana fija el de varias tareas.
Ampliar un agente local de sesión única mediante una CLI, MCP o conectores externos puede permitirle recibir mensajes externos, pero sigue limitado por el bloqueo síncrono de una sola sesión, la mezcla de contextos entre tareas y la interrupción de la ejecución cuando el dispositivo local se desconecta. Sigue siendo necesario mucho mantenimiento manual.
Para superar estas limitaciones, debemos romper la vinculación entre el agente y una única sesión iniciada manualmente. El agente debe convertirse en una entidad continua, capaz de conservar contexto entre sesiones y avanzar en varias tareas complejas a la vez sin interferencias. Llamamos Super-agent a esta forma de agente y a su arquitectura de sistema.
Por ejemplo, en una instancia de Super-agent que ejecutamos internamente sobre DeepSeek Harness, la misma tarea de desarrollo puede continuar entre la mensajería instantánea y GitHub. La instancia también supervisa continuamente los comentarios de los chats de grupos públicos, identifica causas de problemas de forma proactiva y envía Pull Requests con correcciones aunque nadie la mencione con @.
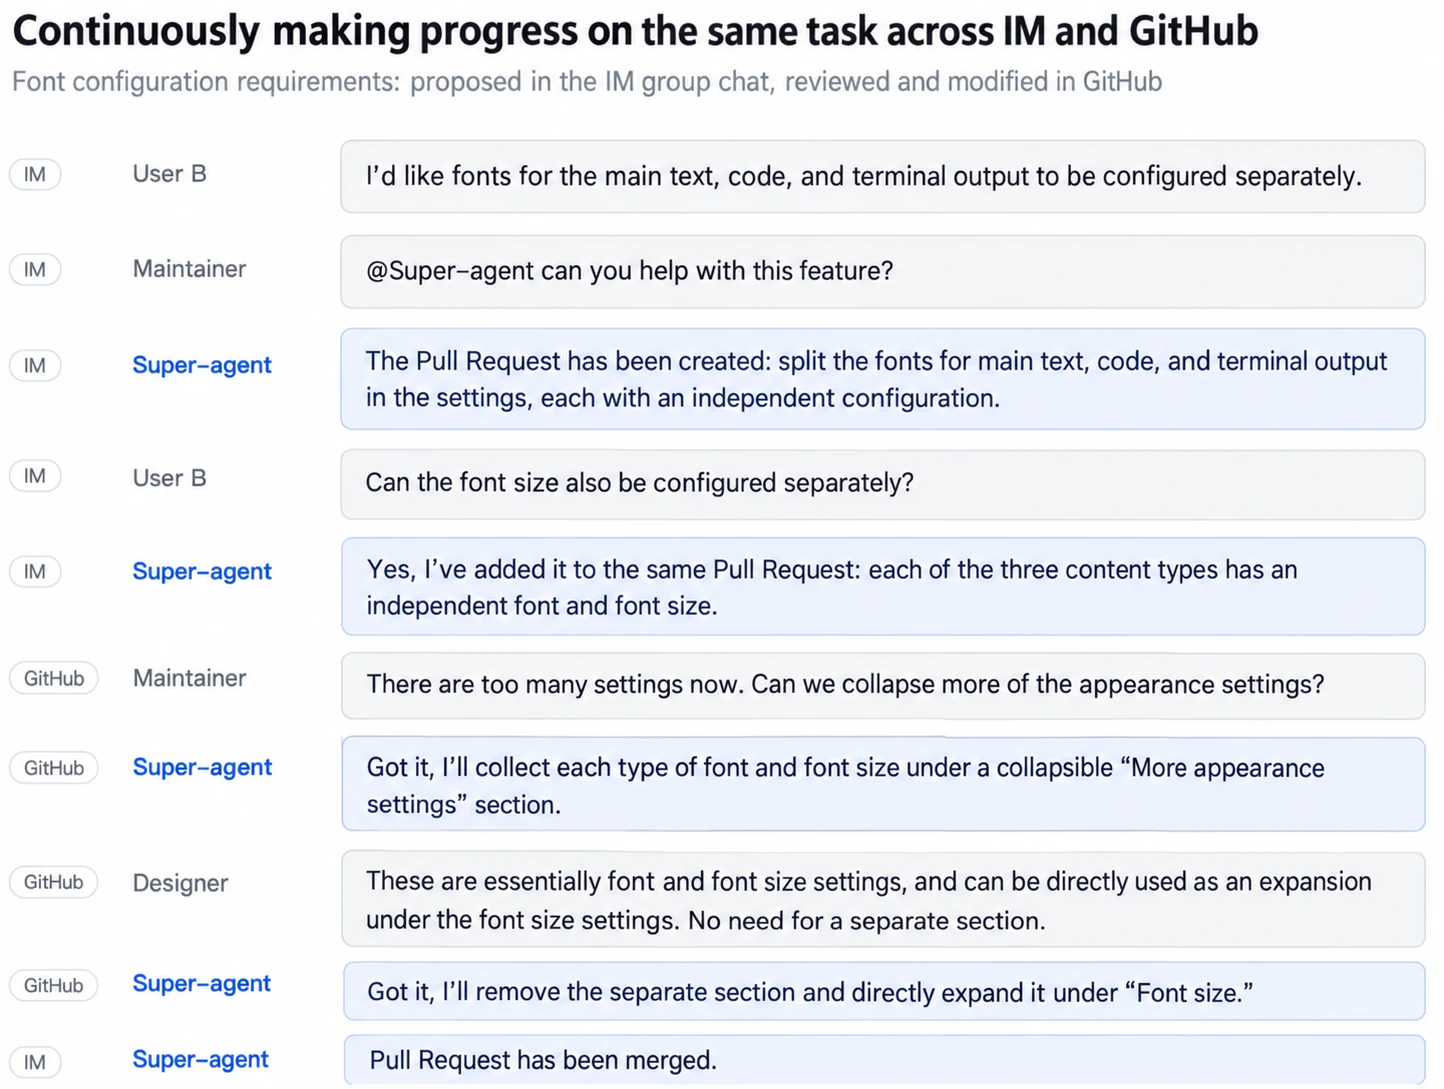
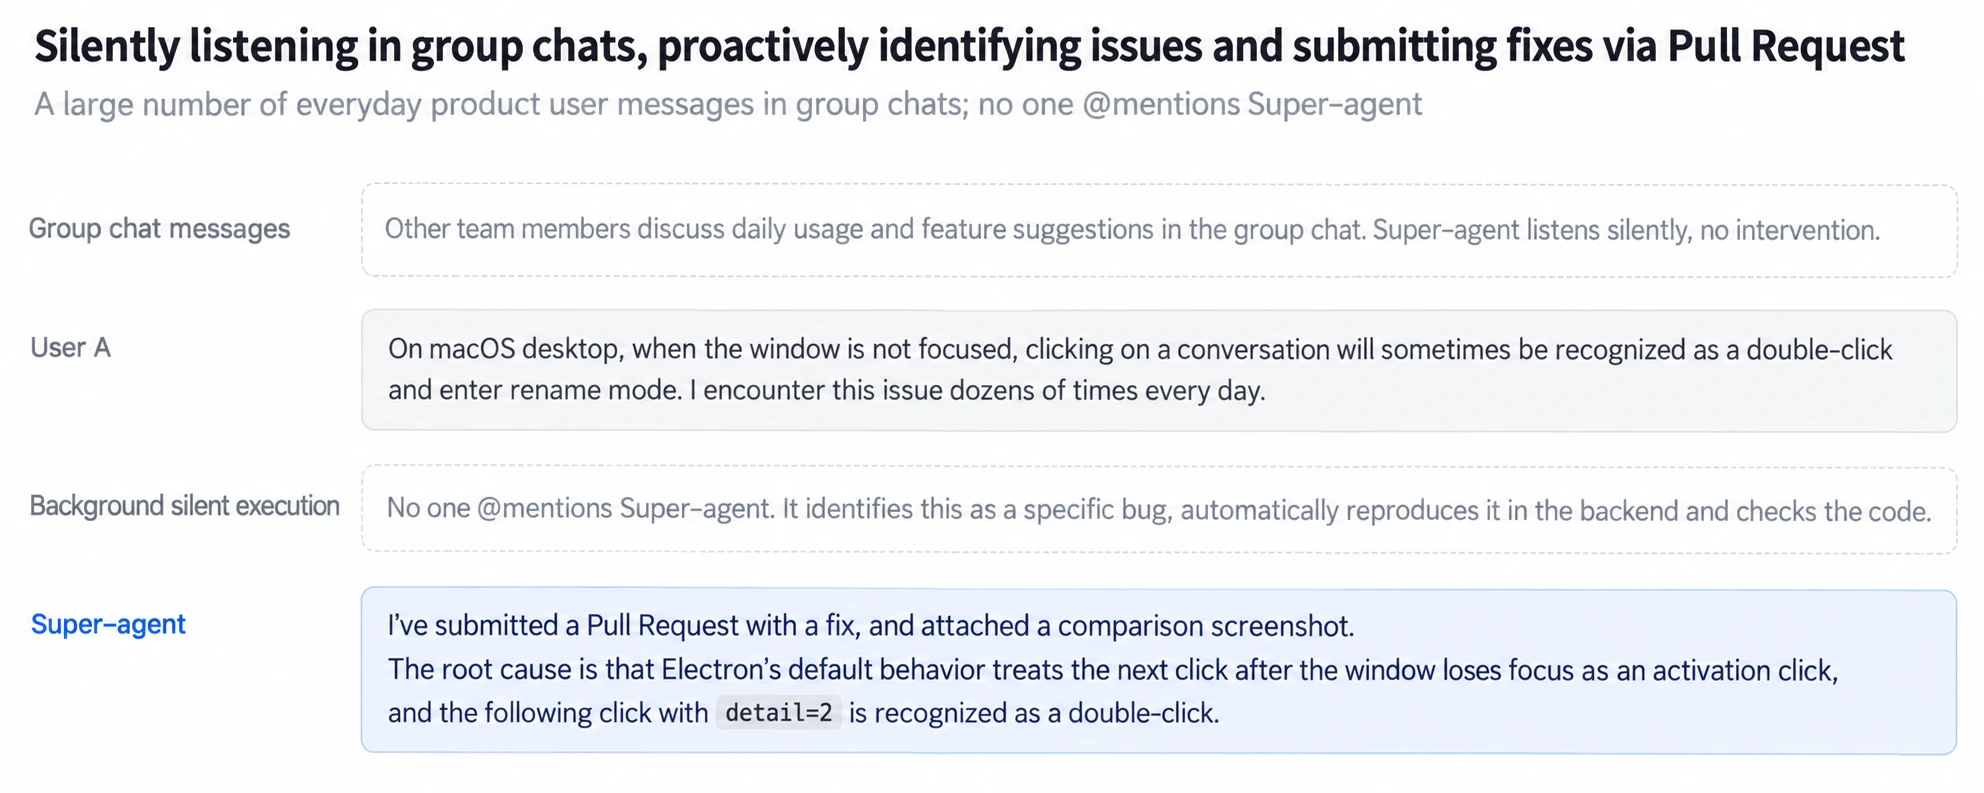
En concreto, creemos que un Super-agent tiene cuatro características fundamentales:
- Continuidad: los usuarios pueden interactuar directamente con él en sus interfaces de trabajo habituales, como los chats de mensajería y los comentarios de GitHub. Da la sensación de que siempre hay un único agente, sin tener que preguntarse: «¿El contexto de la sesión X contiene la información Y?». Por ejemplo, si el usuario propone primero el enfoque A por mensajería y después cambia al B en un comentario de una Pull Request de GitHub, el agente puede entender el cambio y ajustar su trabajo.
- Eficiencia: responde con rapidez mientras completa varias tareas complejas en paralelo y con un alto nivel de calidad. Puede aceptar la siguiente instrucción sin esperar a que termine el comando o la tarea anterior.
- Proactividad: observa continuamente los eventos de su entorno y actúa sobre los asuntos que merecen atención, sin esperar a que el usuario dé cada instrucción. Cuando no hace falta intervenir, permanece en silencio.
- Persistencia: permanece conectado, se integra directamente con los entornos de trabajo reales del usuario y se recupera automáticamente de las incidencias que aparecen durante un funcionamiento prolongado.
Un único ReAct Loop no puede ofrecer las cuatro características a la vez. Hace falta una arquitectura de base adecuada. Unas restricciones de diseño similares conducen a decisiones arquitectónicas similares. Creemos que, tanto para un asistente personal como para un agente aplicado al desarrollo de software, construir un sistema siempre disponible que responda simultáneamente a los eventos del entorno puede conducir a arquitecturas de base parecidas. Muchos de los problemas que aparecen también se parecen a los que los sistemas informáticos tradicionales llevan décadas estudiando, por lo que son aplicables numerosas ideas clásicas de diseño de sistemas.
Las implementaciones de esta arquitectura variarán. Aun así, creemos que los siguientes cinco módulos constituyen el marco básico que sustenta esas cuatro características: una arquitectura de dos capas equilibra la interacción continua con la concurrencia eficiente (sección 2); el funcionamiento por eventos permite respuestas proactivas (sección 3); la interacción centrada en las personas aporta continuidad y eficiencia a la comunicación (sección 4); y la separación del cómputo, el estado y los entornos (sección 5), junto con un Watchdog (sección 6), permite el funcionamiento persistente entre dispositivos y la recuperación automática de incidencias.
El siguiente diagrama muestra la arquitectura general del sistema Super-agent. Las etiquetas [2] a [6] corresponden a las secciones 2 a 6 que aparecen a continuación.
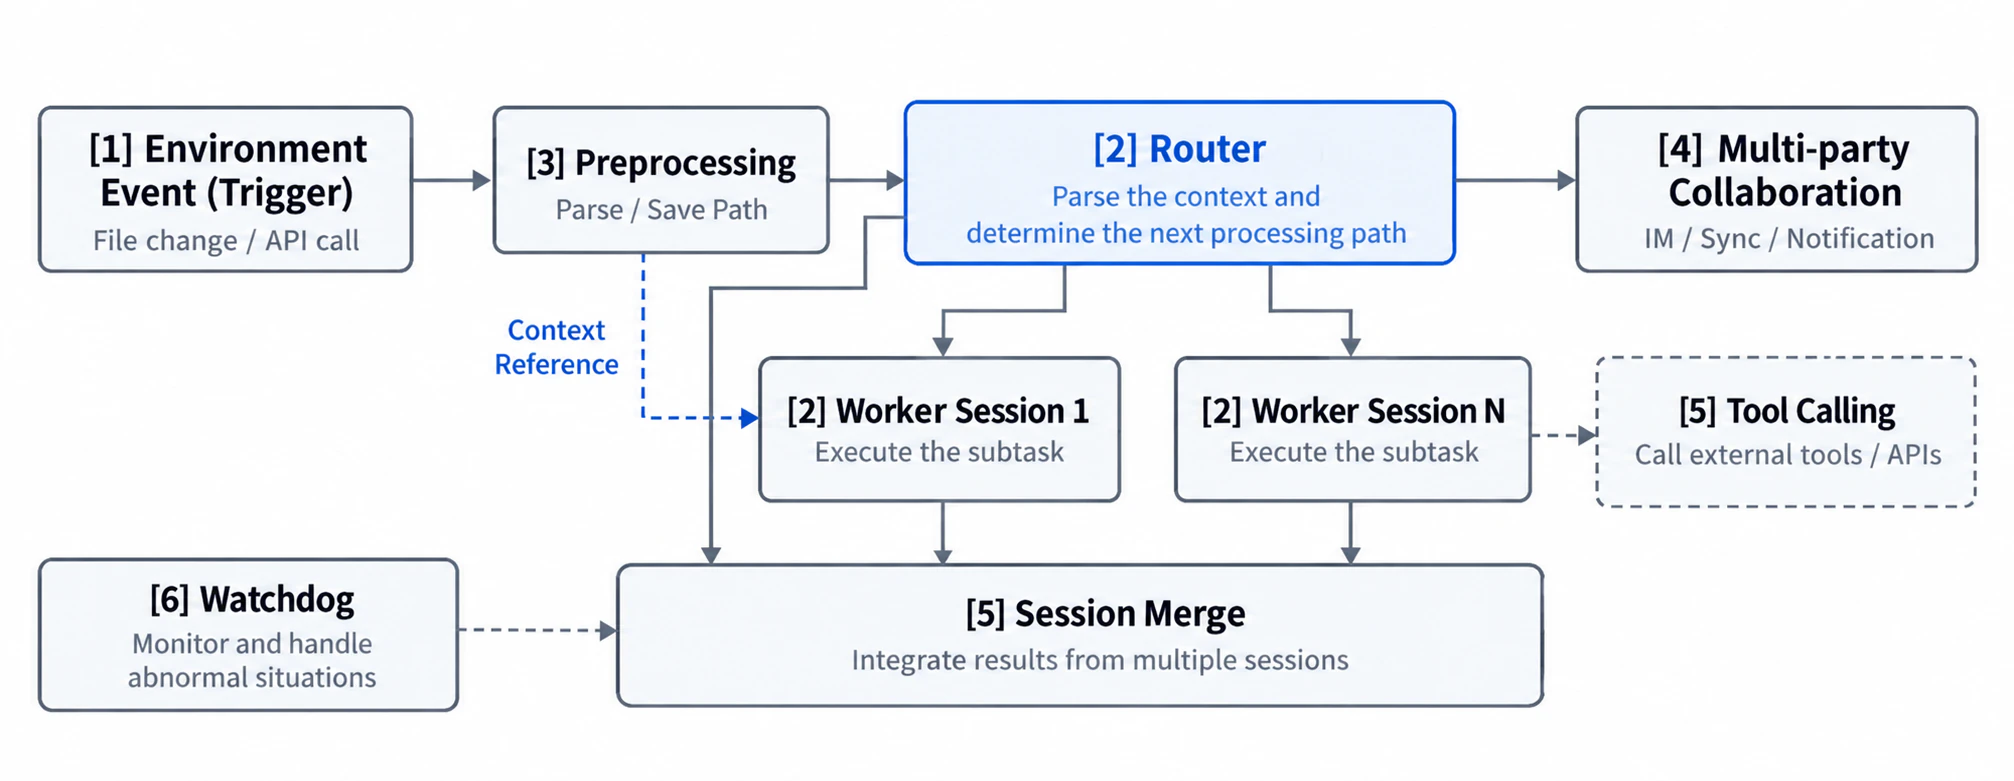
2. Una arquitectura de dos capas
Para ofrecer interacción continua entre canales y concurrencia eficiente entre tareas, el sistema afronta una disyuntiva fundamental entre continuidad y capacidad de procesamiento al organizar sus sesiones internas.
Enviar todos los eventos a la misma sesión ofrece la mayor continuidad del contexto. Sin embargo, queda limitado por la velocidad de un único ReAct Loop que se ejecuta en serie, lo que alarga los tiempos de finalización y reduce la capacidad de procesamiento. Mezclar los detalles intermedios de varias tareas también puede perjudicar la calidad de los resultados.
Por el contrario, abrir una sesión independiente para cada evento maximiza la capacidad de procesamiento concurrente. Pero, cuando las tareas no son totalmente independientes, la falta de contexto global deja los resultados desconectados. Que varias sesiones respondan al usuario por separado también genera confusión.
Para equilibrar continuidad y capacidad de procesamiento, podemos separar «mantener la continuidad global» y «ejecutar con alta concurrencia» en dos capas: una capa Router persistente atiende la interacción humana y la coordinación global (sección 2.1), mientras una capa Worker ejecuta tareas concretas simultáneamente en contextos aislados (sección 2.2), como se muestra a continuación.
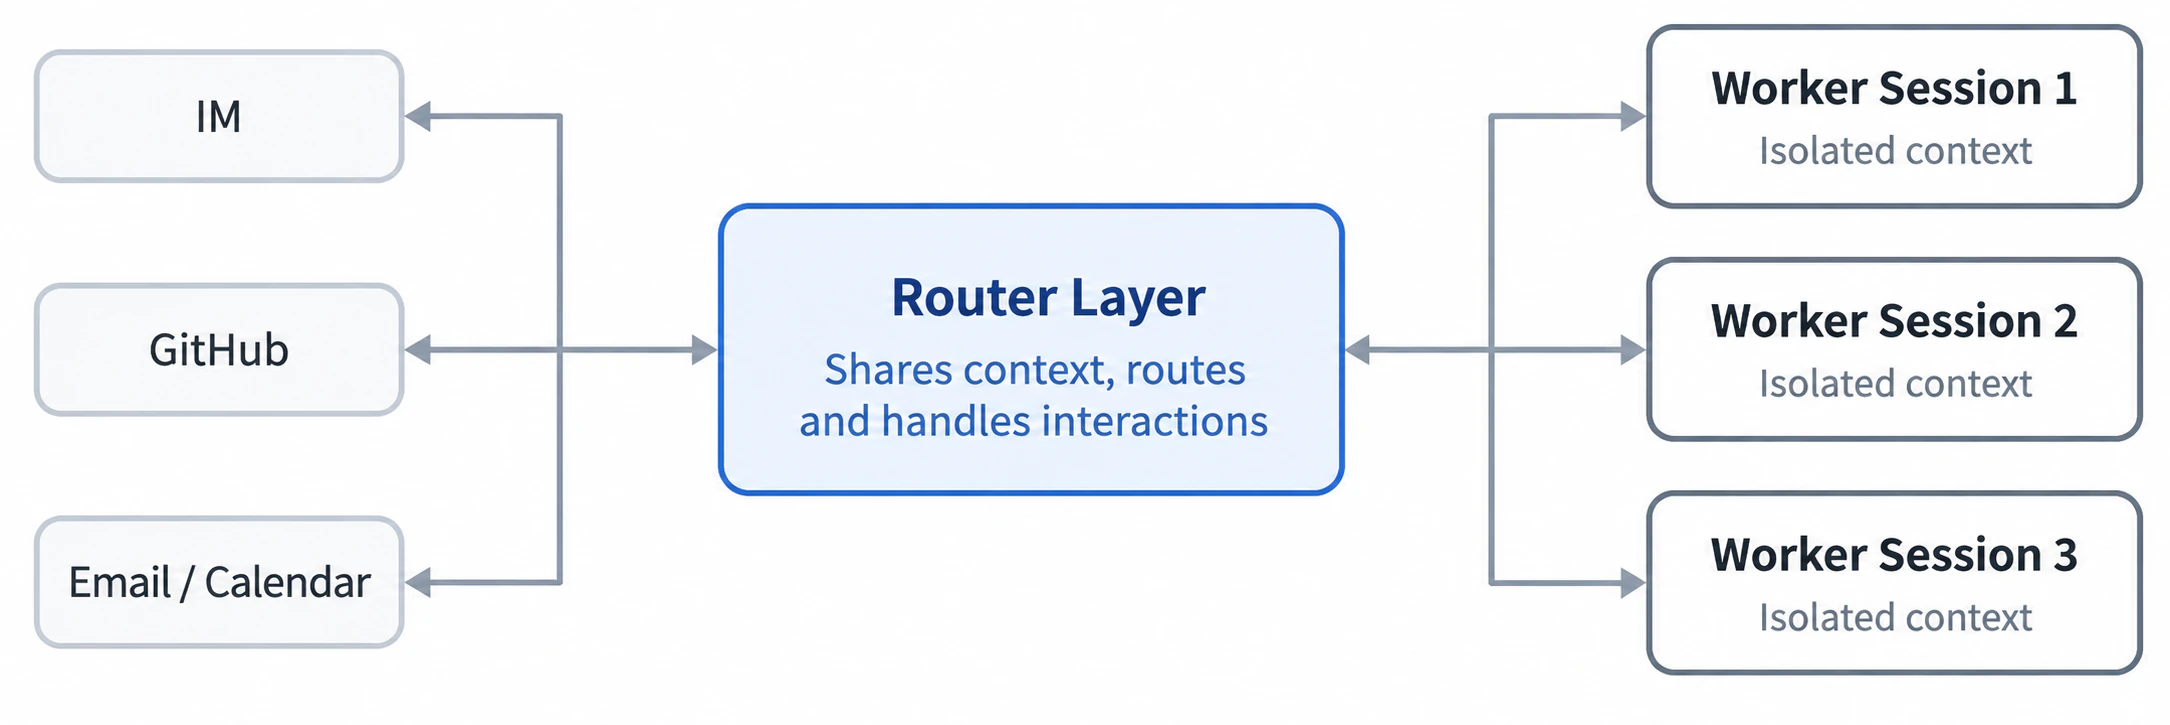
Con esta arquitectura de dos capas, el sistema de base asume la gestión del contexto y la ejecución concurrente. Las sesiones pierden visibilidad para los usuarios, que siempre interactúan con el mismo Super-agent. Desde esta perspectiva, hacer que los usuarios gestionen manualmente las sesiones es, en gran medida, una costumbre de diseño heredada de las API de LLM subyacentes. Las sesiones deberían ser un detalle de implementación del sistema, no una carga cognitiva para el usuario.
En los diseños existentes, una sesión sirve tanto para la gestión técnica del contexto como para la gestión de proyectos de cara al usuario. Al separar la experiencia del producto de la sesión subyacente, la gestión de proyectos deja de estar limitada por ella. Decidir qué experiencia de interacción y gestión de tareas ofrecer se convierte en una cuestión de producto independiente. Volveremos sobre ella más adelante.
Las «dos capas» describen una división lógica de responsabilidades. Ninguna tiene que implementarse como una única sesión; cada una puede tener su propia estructura interna. A continuación describimos las capas Router y Worker.
2.1 La capa Router
La capa Router es una capa global y persistente de enrutamiento que atiende la interacción humana desde todos los puntos de entrada. Aquí se reúnen la información y las decisiones que abarcan varias tareas, por lo que actúa como punto global de ordenación, coordinación y memoria. Para evitar que este nodo global se convierta en un cuello de botella, la capa Router se diseña para no ejecutar tareas concretas. Solo gestiona la interacción humana y la asignación del trabajo; incluso puede carecer de una herramienta Bash.
Esta estructura, donde un nodo central asigna trabajo a varios nodos de ejecución, puede parecer un Agent Team típico, pero el énfasis es distinto. Un Agent Team suele utilizarse para descomponer los pasos y coordinar los papeles dentro de una única tarea compleja. Como esos pasos suelen estar estrechamente relacionados, el Team Lead necesita entender bien la tarea, planificar subtareas y coordinar con frecuencia a sus miembros, lo que supone una carga importante de razonamiento. En un Super-agent, la capa Router solo gestiona las relaciones generales y las asignaciones entre tareas; no necesita descomponer internamente cada una. A la inversa, si se restringe mediante prompts la sesión principal de un Agent Team para que no ejecute trabajo concreto y solo atienda la interacción externa y asigne tareas independientes a sus miembros, también puede considerarse una arquitectura de dos capas de este tipo. Según nuestra experiencia, el trabajo de la capa Router suele ser menos complejo de lo que parece. Un modelo más ligero puede ofrecer a menudo rapidez y buenos resultados.
Internamente, la capa Router tampoco tiene que ser una única sesión, y parte de su lógica puede no necesitar un LLM. Elegimos la implementación más sencilla: una única sesión de LLM persistente como núcleo. Comprobamos que era menos propensa de lo que parecía a convertirse en un cuello de botella. Los eventos del entorno que llegan durante una ronda de inferencia —los Triggers de la sección 3— se acumulan y se procesan juntos en la siguiente. Esto genera procesamiento por lotes, con poca sobrecarga adicional por agrupar eventos:
- Cuando el flujo externo de eventos es estable, los Triggers entran uno a uno en la sesión del Router y la latencia de cada respuesta es baja.
- Cuando los eventos llegan en ráfagas y empieza a crecer la cola de la sesión del Router, los Triggers acumulados durante la ronda anterior de inferencia se agrupan automáticamente y se inyectan juntos en la siguiente llamada al LLM. La sesión del Router solo realiza interacción y asignación ligeras; cada paso suele tener una entrada larga y una salida corta. Agrupar los Triggers pendientes en una llamada a la API permite calcularlos en paralelo durante el prefill. Por ello, la duración de una solicitud crece mucho más despacio que el tamaño del lote. Dentro de cierto margen, cuanto mayor es la cola, menor es el tiempo de inferencia repartido entre cada decisión. El límite depende de la longitud del contexto y del número de Triggers que el modelo pueda manejar con precisión en una ronda.
La sección 7.2 cuantifica experimentalmente el efecto de este procesamiento por lotes. Combinado con las suscripciones, la entrega directa y la Chain of Recall que presentamos después (secciones 3.2 y 3.3), una única sesión del Router persistente ha sido suficiente para nuestra escala actual de equipo, manteniendo la continuidad del contexto.
Si el tamaño del sistema aumenta y una sola sesión deja de ser suficiente, la capa Router podría adoptar una estructura de filtrado multinivel o dividirse horizontalmente —mediante sharding— entre varias sesiones. Entonces, su diseño interno sería fundamentalmente un equilibrio entre continuidad y capacidad de procesamiento. Una división más fina aumenta la concurrencia de la capa Router, pero reduce la continuidad de memoria y contexto entre particiones. Esta disyuntiva persistirá hasta resolver el problema de la memoria global.
2.2 La capa Worker
La capa Worker está formada por sesiones responsables de la ejecución. Cada Worker tiene un contexto aislado del de los demás y todas las herramientas de ejecución necesarias, por lo que puede concentrarse en una tarea dentro de su propio contexto. Como las sesiones de Worker determinan directamente los resultados de las tareas y la calidad del código, suelen necesitar el modelo más capaz disponible.
Los Workers no interactúan directamente con las personas. Su razonamiento y sus llamadas a herramientas no se envían a los canales externos. Informan de su estado a la capa Router, que responde al usuario en su nombre. Así se mantiene la concurrencia y la calidad de los resultados, sin la confusión de varias sesiones que responden por separado.
Cuando se ejecutan varias tareas a la vez, cada Worker avanza de forma independiente. Los Workers de la misma capa normalmente no necesitan comunicarse directamente. Los conflictos suelen surgir en entornos de trabajo compartidos, como una misma Pull Request. Si los Workers se suscriben al Thread correspondiente, reciben las mismas notificaciones de eventos (sección 3.2), lo que les permite detectar y resolver los conflictos por sí mismos. La capa Router transmite la coordinación limitada que hace falta entre tareas.
Como ocurre con la capa Router, cada sesión de Worker puede contener internamente más de una sesión. Para ejecutar una tarea individual compleja, un Worker puede crear subagentes o ser a su vez un Agent Team. Estos detalles son transparentes para la capa Router superior. La estructura sirve tanto para el desarrollo colaborativo —donde la reproducción de Issues independientes, la revisión de Pull Requests y el desarrollo de funciones pueden avanzar sin bloquearse— como para asistentes personales. Aunque la interfaz de estos últimos suele mostrar un chat de una sola sesión, el usuario puede tratar varios temas en la misma conversación. Un único chat mantiene la continuidad de la interacción, mientras el sistema asigna por debajo un Worker distinto a cada tema para avanzar las tareas y preparar respuestas en paralelo.
3. Funcionamiento por eventos
Para que un Super-agent sea proactivo, primero debemos cambiar qué lo impulsa. Las entradas principales que mueven al agente ya no son prompts que las personas escriben uno a uno en una sesión, sino eventos semiestructurados de su entorno. En un Super-agent, los eventos del entorno, como mensajes de grupos, correos y recordatorios del calendario, comentarios de revisión de código y resultados de CI, se denominan Triggers. Al escuchar y responder a los Triggers, el agente deja de tener que esperar pasivamente una instrucción humana para ejecutar una vez, como ocurre en el modelo de sesión única.
Siguiendo el ciclo de un evento desde su llegada hasta su procesamiento, abordamos cuatro preguntas sucesivas: cómo filtrar grandes cantidades de ruido con una estrategia de dos etapas que combine código y modelos (sección 3.1); cómo enrutar los eventos a los Workers mediante suscripciones y entrega directa (sección 3.2); cómo utilizar Inline & Spill y Chain of Recall para inyectar contexto con alta densidad de información y recuperarlo cuando haga falta (sección 3.3); y cómo utilizar la ejecución especulativa para actuar por adelantado en segundo plano a partir de señales del entorno (sección 3.4).
3.1 Filtrado de eventos
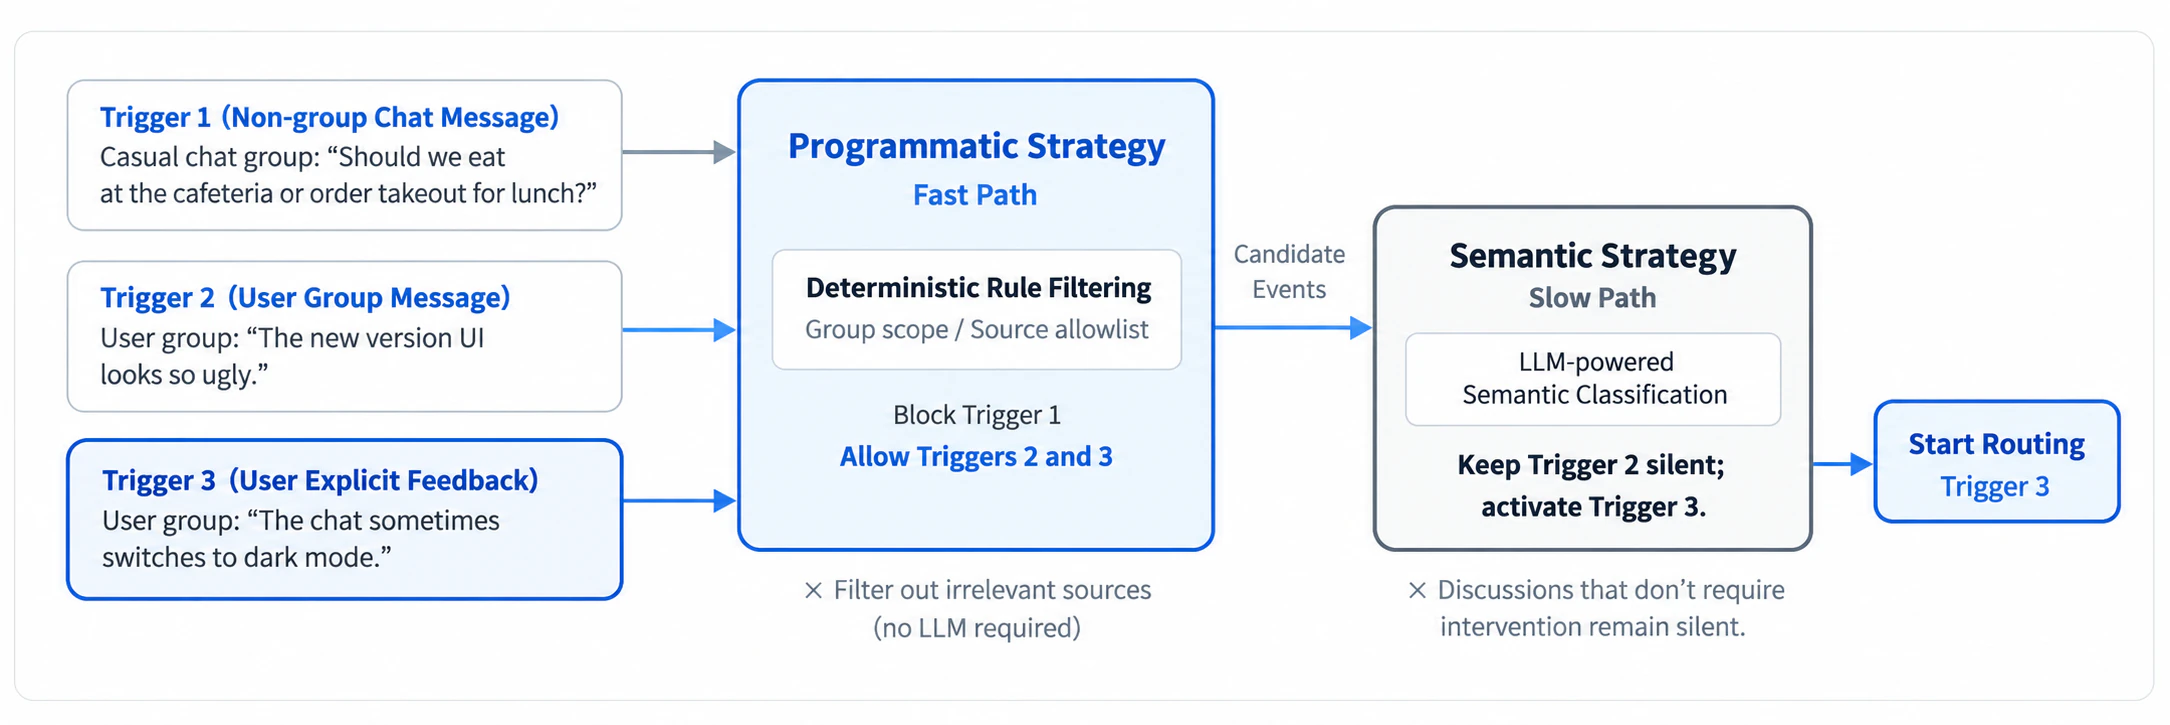
Al conectarse a chats de grupos y plataformas de código reales, el flujo de eventos presenta claramente «mucho ruido y pocas ocasiones de actuar»: la inmensa mayoría de los mensajes cotidianos no requiere la intervención del agente. Invocar un modelo grande para evaluar cada evento desde cero haría difíciles de sostener tanto la latencia como los costes de cómputo. Siguiendo el concepto Fast Path / Slow Path de los sistemas informáticos, podemos considerar la inferencia de un modelo grande como una vía flexible pero costosa, el Slow Path. Codificar en reglas deterministas las decisiones estables, frecuentes y bien comprendidas proporciona una vía rápida y económica, el Fast Path.
Por tanto, el primer paso al recibir eventos es filtrarlos. El objetivo es eliminar ruido mediante políticas deterministas antes de invocar un modelo grande y enviarle solo los eventos candidatos que requieren comprensión semántica. Utilizamos un mecanismo de filtrado de dos etapas que combina políticas programadas con un modelo grande:
- Políticas programadas — Fast Path: el código comprueba rápidamente condiciones deterministas como la fuente del evento, el ámbito del grupo o las listas de usuarios y bots permitidos. Por ejemplo, se puede configurar cada fuente para «responder solo a solicitudes explícitas», «considerar como eventos candidatos» o «ignorar directamente», descartando la mayoría de los mensajes irrelevantes antes de invocar el modelo.
- Políticas semánticas — Slow Path: los eventos candidatos admitidos por la capa de código llegan al LLM, que decide si debe actuar según el contexto y las políticas escritas en los prompts. La capa semántica también ofrece a las personas un punto de extensión en lenguaje natural, de modo que puedan activar, desactivar o añadir políticas mediante prompts, como se muestra a continuación.
3.2 Enrutamiento de eventos
La capa Router global de la sección 2 mantiene la continuidad entre canales. Pero, si todos los eventos posteriores de una tarea asignada siguen pasando por ella, este nodo global continuará soportando una carga elevada y aumentará la latencia de respuesta. Por eso, el enfoque Fast Path / Slow Path también se aplica al enrutamiento de los eventos filtrados. La capa Router global solo inicia tareas nuevas y coordina entre tareas. Una vez establecido quién se encarga de ellas, el código envía los eventos posteriores directamente a la sesión de Worker correspondiente, sin que pasen de nuevo por la capa Router.
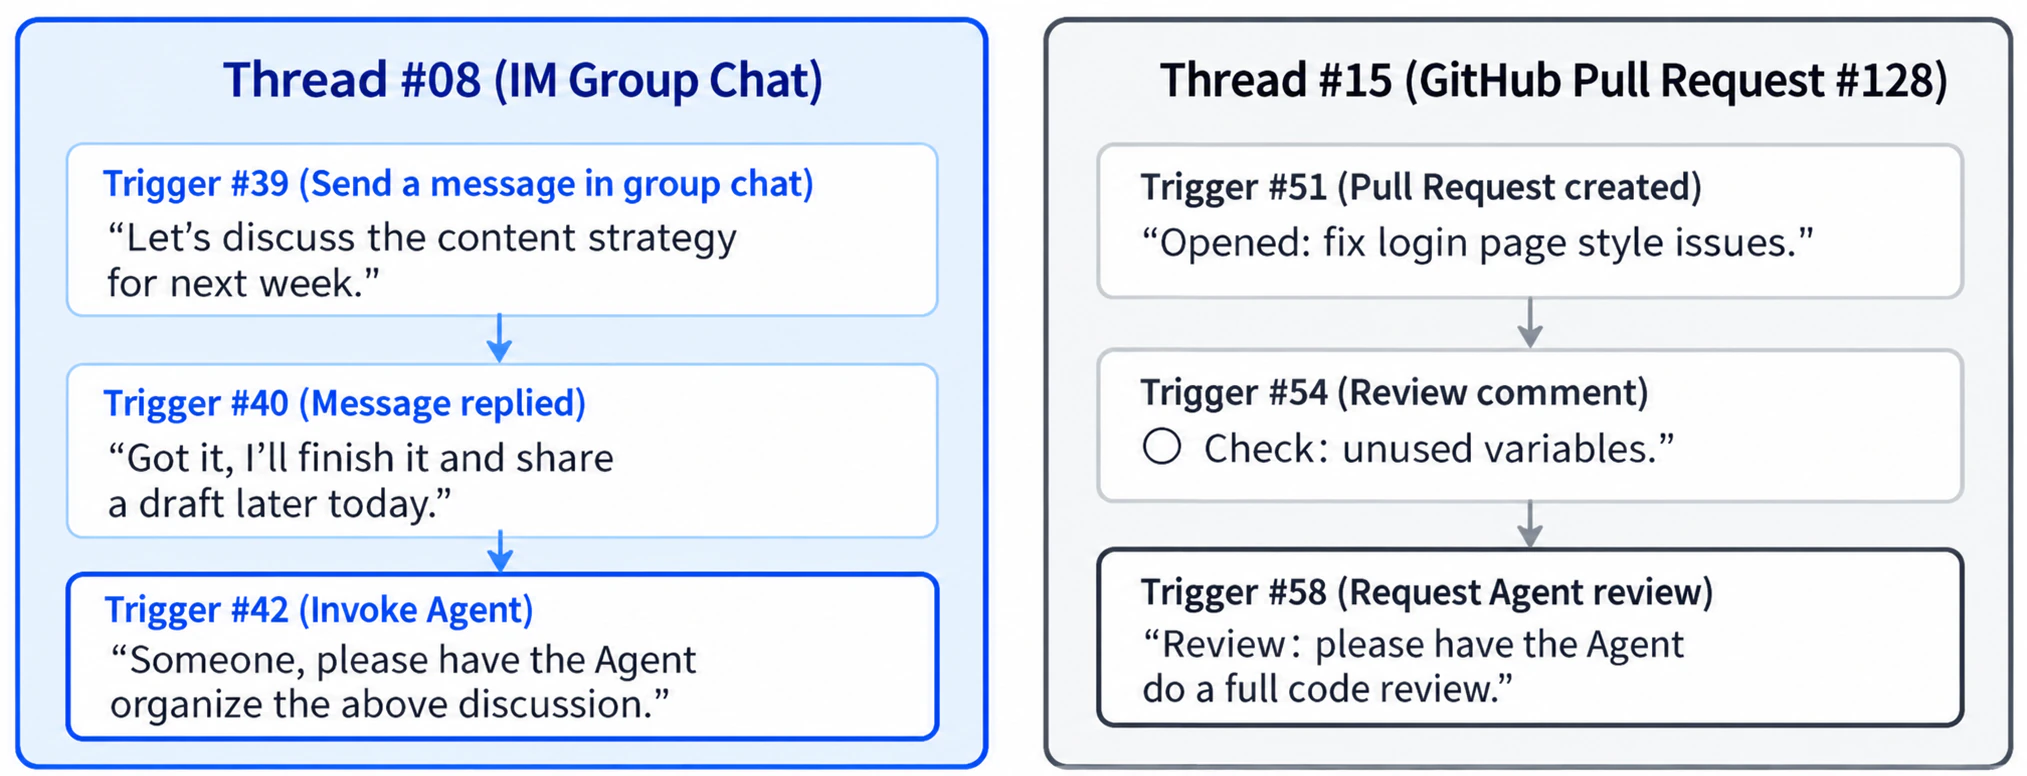
En los flujos reales, los eventos sucesivos de una misma Pull Request de GitHub, un tema de mensajería o una conversación de correo forman un flujo de eventos: un Thread.
Cuando la capa Router crea una sesión de Worker a partir del primer evento de un Thread, ese Worker se suscribe directamente al Thread. El enrutamiento queda dividido en las dos vías que se muestran a continuación:
- Con suscripción — Fast Path: el código entrega los eventos posteriores del mismo Thread directamente al Worker suscrito. La capa Router no necesita invocar una herramienta para reenviarlos. Si un nuevo evento queda fuera del alcance de la tarea actual, el Worker puede cancelar la suscripción o devolverlo a la capa Router para que lo reasigne.
- Sin suscripción — Slow Path: la capa Router puede seguir observando todos los eventos para mantener una visión global, pero solo necesita evaluar y asignar los nuevos eventos que todavía no tienen suscripción.
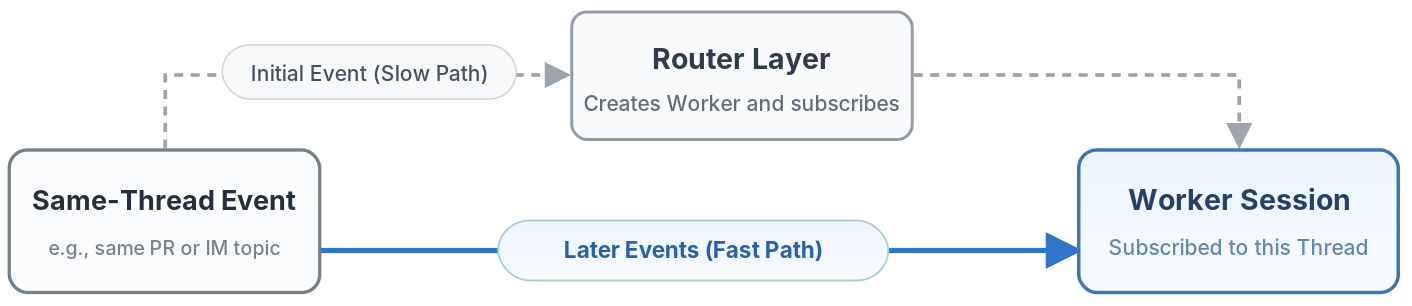
La relación de suscripción entre Threads y Workers es de muchos a muchos. Un Worker puede suscribirse a varios Threads relacionados, y un Thread puede tener varios Workers suscritos. Cuando los Workers coinciden en un mismo entorno o debate, los eventos nuevos de ese Thread se entregan directamente a todos los suscriptores. Sin comunicación punto a punto, pueden conocer las acciones de los demás y tener la oportunidad de resolver los conflictos por sí mismos. En la salida, los Workers siguen comunicando sus conclusiones principales a la capa Router, que responde a los usuarios y actualiza la memoria global.
3.3 Organización del contexto
Tras filtrar un evento y enviarlo a su sesión de destino, la siguiente pregunta es cuánta información inyectar en la ventana de contexto del modelo. A medida que las entradas pasan de un conjunto limitado de prompts humanos a un flujo continuo de eventos semiestructurados, cobra más importancia la estructura de las llamadas a herramientas y de la inyección de eventos. Inyectar demasiado consume la ventana y dispersa la atención del modelo. Inyectar poco obliga a repetir llamadas para recuperar información y aumenta los pasos de ejecución. Desperdiciar la ventana de contexto equivale a desperdiciar la inteligencia del modelo.
Podemos gestionar esa ventana limitada como una caché. Tomando ideas de la optimización de compiladores y de los sistemas informáticos, la inyección de contexto se puede describir con dos operaciones básicas. Inline consiste en colocar directamente en la ventana actual la información que probablemente se necesite pronto, evitando viajes adicionales de llamadas a herramientas. Spill consiste en mantener fuera de la ventana la información completa que supera su presupuesto o se usa poco, conservando dentro solo referencias o resúmenes para que el modelo la lea cuando la necesite.
Al combinar Inline & Spill con el principio clásico de localidad, podemos optimizar gradualmente la inyección de eventos y las llamadas a herramientas:
- Empezar con la información mínima: proporcionar inicialmente solo el ID del objeto actual y un resumen de su contenido.
- Aplicar Inline progresivamente usando la localidad: incluir información que probablemente se necesite pronto. Primero se adjuntan los ID de objetos estrechamente relacionados y, después, contenido próximo en el tiempo o en la estructura: por ejemplo, los primeros 50 caracteres, los mensajes anteriores y posteriores a uno de mensajería y aquel al que responde, o los comentarios vecinos del debate de revisión al que pertenece un comentario de código.
- Aplicar Spill al superar el límite: establecer un límite de longitud pequeño para el contenido extenso que no se puede incluir por completo con Inline y dejar el resto fuera de la ventana. Una implementación sencilla recorta lo que sobra, pero conserva una vía para seguir leyendo. El modelo puede invocar una herramienta para recuperar todo el contenido cuando lo necesite.
Además, cuando muchos eventos posteriores se entregan directamente a los Workers y se acumula un historial largo, la capa Router no puede conservar el historial completo de todas las tareas en su ventana de contexto. Aun así, debe recuperar el contexto si el usuario se refiere a una tarea antigua desde otro canal. Aplicar Inline & Spill de forma coherente a los distintos tipos de objetos da lugar a Chain of Recall: un mecanismo de recuperación bajo demanda que recorre varios enlaces. Este proceso ayuda a resolver la pérdida de información anterior de la capa Router durante periodos largos, como se ilustra a continuación.
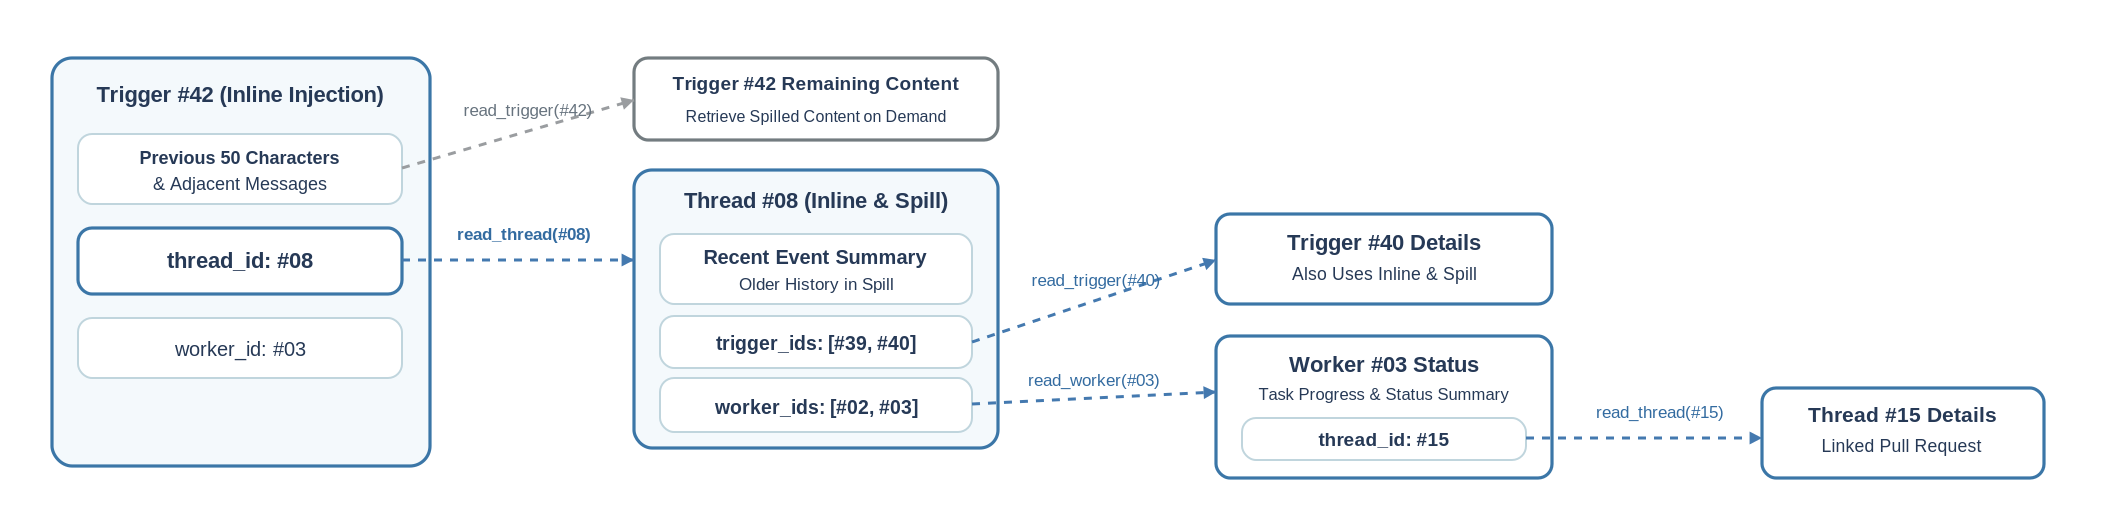
En concreto, el sistema asigna ID únicos a objetos como Triggers, Threads y sesiones de Worker. Al inyectar un objeto, incluye mediante Inline los ID de los objetos más relacionados, formando un grafo de referencias subyacente. Cada objeto recuperado mediante una herramienta sigue el mismo enfoque Inline & Spill: los datos que devuelve incluyen resúmenes e ID de objetos relacionados para el siguiente salto. Partiendo del evento actual, el modelo puede recorrer estas referencias para recuperar progresivamente el contexto que necesite.
Por ejemplo, puede leer el Thread que contiene el mensaje actual, seguir un ID incluido en el Thread hasta la sesión de Worker asociada y encontrar después otro Thread de revisión de código vinculado a ese Worker.
3.4 Actuar por adelantado
Inspirándose en la ejecución especulativa de los sistemas informáticos, un agente puede actuar en segundo plano a partir de señales del entorno antes de saber con certeza si se utilizará el resultado. Emplea cómputo adicional en segundo plano para reducir la espera y la intervención humanas. Si el resultado es valioso, lo entrega; si no, lo descarta.
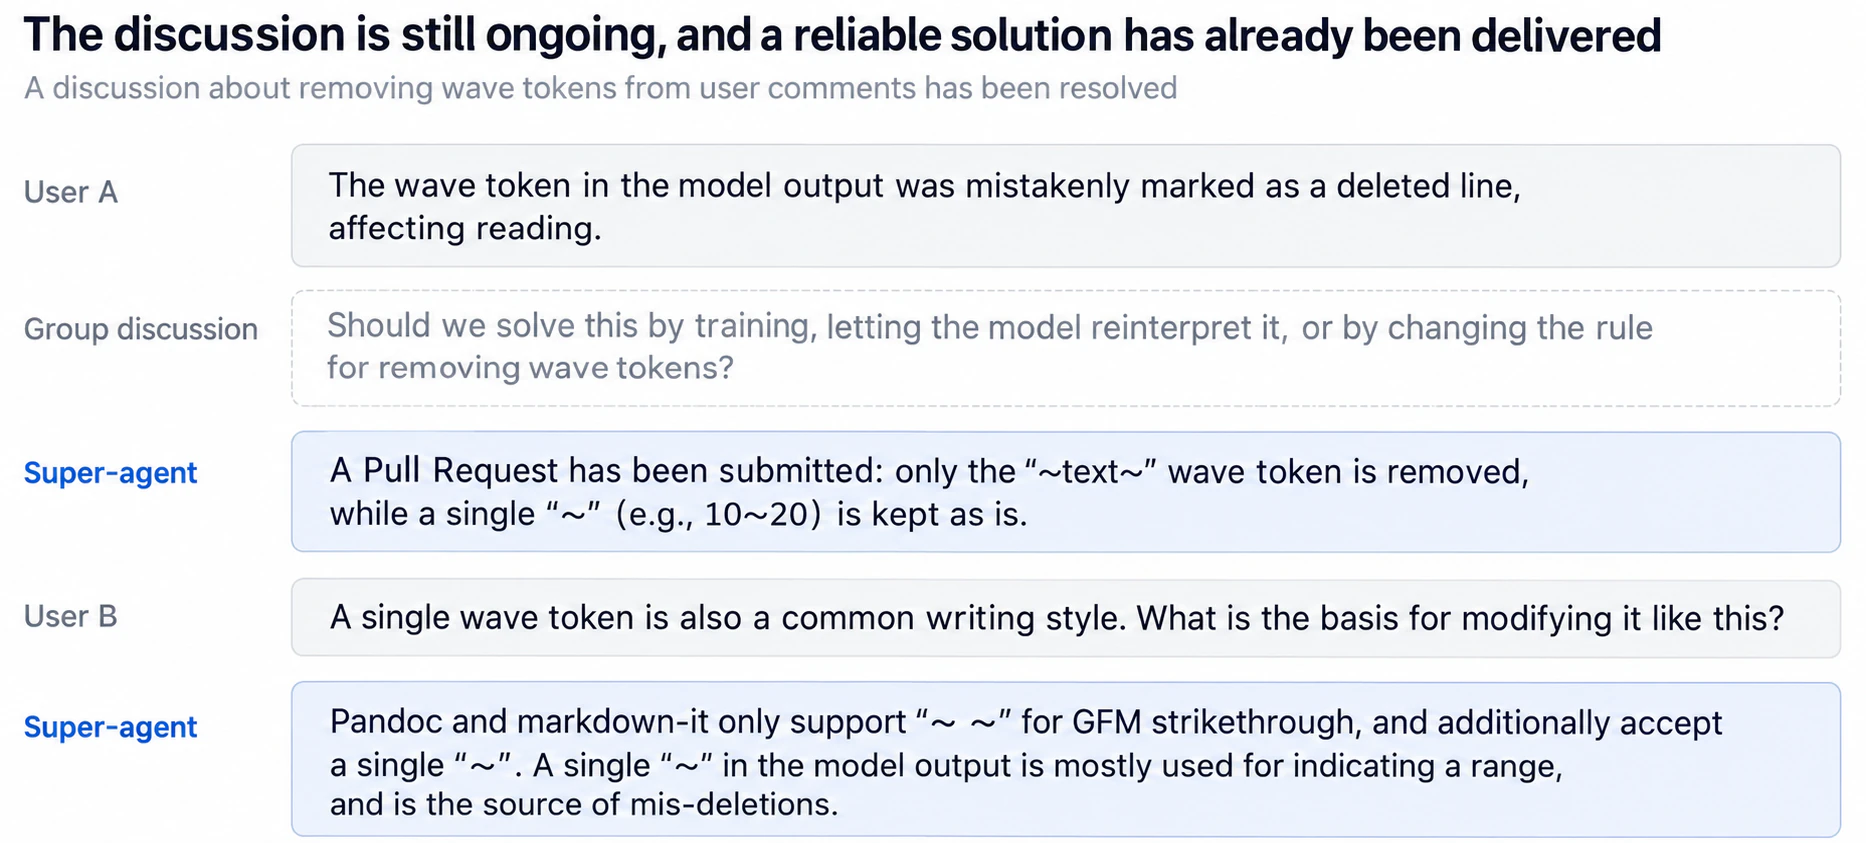
En un asistente personal, recibir una invitación a una reunión o un mensaje con una tarea podría activar comprobaciones de conflictos en el calendario, recopilación de información de contexto y preparación de un borrador de respuesta. Tras revisarlo, el usuario puede confirmarlo y enviarlo de inmediato. Lo mismo se aplica al desarrollo colaborativo. Por ejemplo, configuramos una política de «reproducir y corregir en silencio» en el grupo interno de usuarios de DeepSeek Harness de nuestra empresa. Cuando alguien informa de un problema o debate un cambio, el agente primero intenta reproducirlo y buscar una solución en segundo plano. Solo entrega el resultado si confirma el problema y encuentra una corrección sencilla; de lo contrario, permanece en silencio durante todo el proceso.
4. Interacción centrada en las personas
La arquitectura de dos capas de la sección 2 garantiza la continuidad del contexto entre canales. Pero lograr continuidad y eficiencia en la interacción real entre personas y agentes requiere resolver otros dos problemas relacionados con los métodos y los canales de interacción. Primero, un ReAct Loop asíncrono debe eliminar el bloqueo que las operaciones lentas en segundo plano producen en la conversación en primer plano, para que una sesión acepte nuevas instrucciones sin esperar a que termine el comando o la tarea anterior (sección 4.1). Segundo, cuando la interacción se realiza en los canales de trabajo habituales, la salida del sistema debe ajustarse al volumen de información que admite cada canal y a los hábitos de las personas (sección 4.2).
4.1 Interacción dúplex completa
En un ReAct Loop clásico, cuando el modelo realiza una llamada síncrona a la herramienta run(), el bucle se bloquea hasta que la herramienta termina y devuelve su resultado final. Mientras tanto, la sesión no puede responder a nuevas entradas del usuario. Para eliminar este bloqueo, la conversación debe pasar de un modo semidúplex de preguntas y respuestas a uno dúplex completo, como muestra la figura.
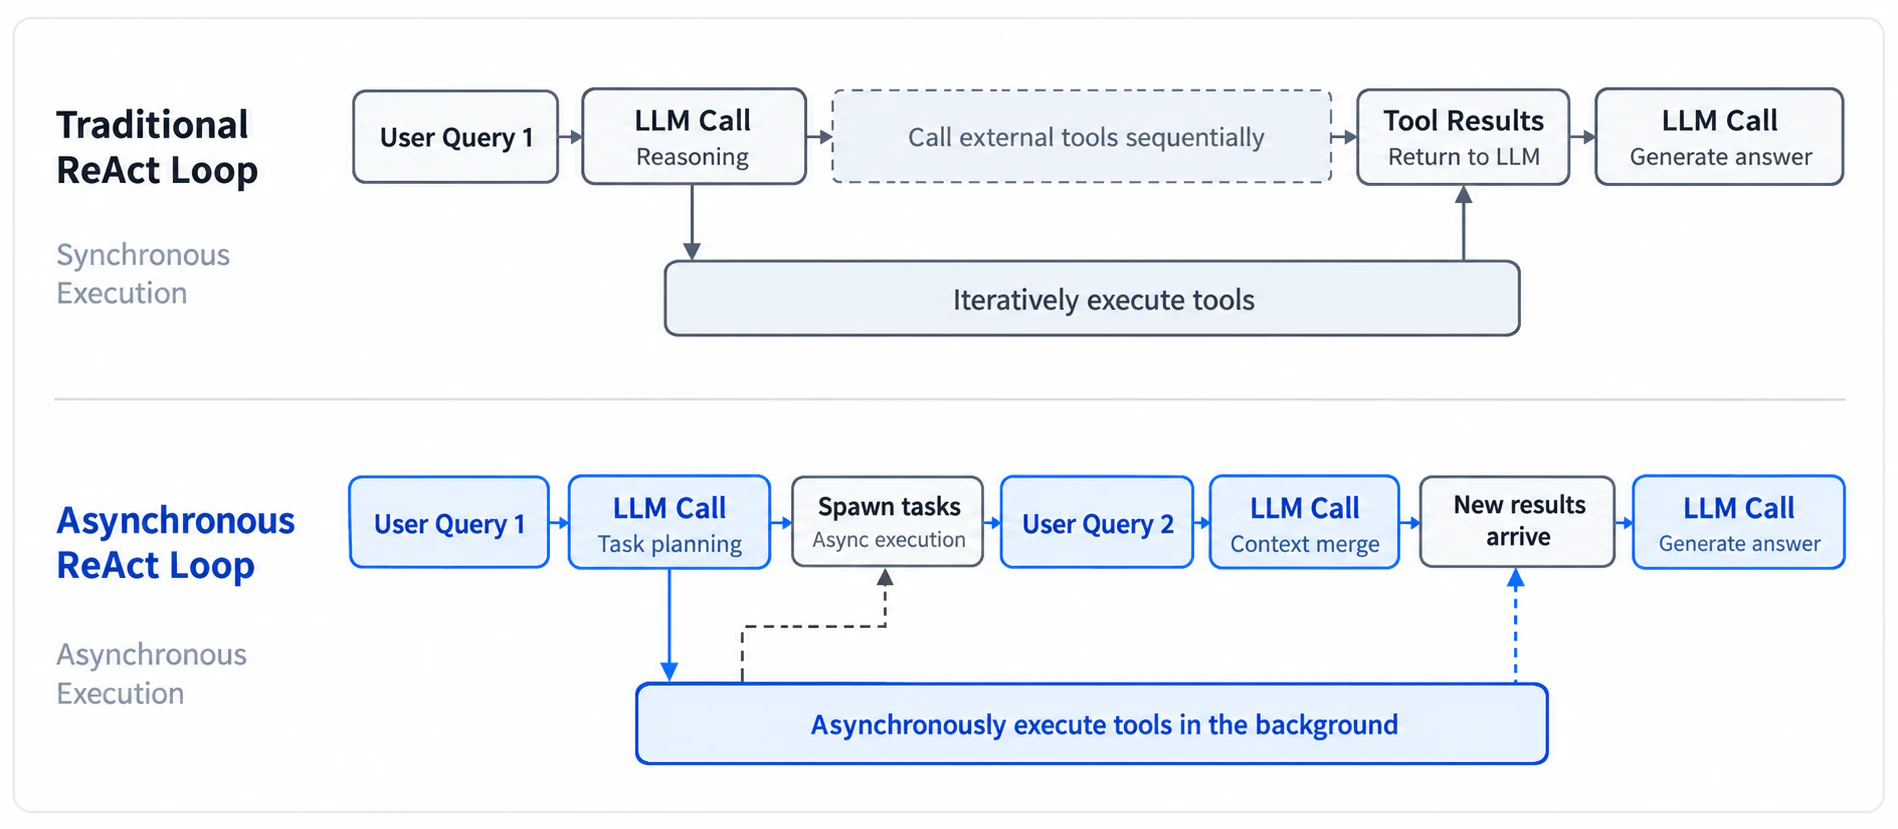
Para lograrlo, sustituimos las llamadas a herramientas para comandos y subtareas largos por operaciones asíncronas start() y stop(), formando un ReAct Loop asíncrono. Tras invocar start(), el modelo recibe inmediatamente la respuesta «Started» y el bucle deja de esperar a la herramienta. Cuando esta termina en segundo plano, el sistema entrega su resultado final a la sesión como un nuevo mensaje de evento. El modelo también puede invocar stop(), según el contexto, para terminar comandos que llevan demasiado tiempo ejecutándose en segundo plano.
Esto separa la conversación en primer plano de la ejecución de tareas en segundo plano. El agente puede responder a las personas mientras ejecuta tareas largas. Las nuevas entradas se atienden en cuanto termina el paso actual de inferencia, sin esperar a que acaben las herramientas en segundo plano.
Este mecanismo de tareas asíncronas ya está implementado en DeepSeek Harness, pero aún no está activado por defecto.
4.2 Interacción entre canales
Cada canal de trabajo tiene una densidad de información y unas convenciones de interacción distintas, y la salida del sistema debe adaptarse a ellas. Llevar directamente a un chat de grupo una interfaz pensada para un terminal individual, reproduciendo íntegramente razonamientos largos y llamadas frecuentes a herramientas, puede saturar a quienes colaboran allí.
En un Super-agent, la arquitectura de dos capas ya resuelve parte del problema. Los razonamientos largos y las llamadas frecuentes de tareas concretas permanecen en las sesiones de Worker, sin enviarse directamente a los canales externos. La capa Router centraliza la interacción externa. Sobre esta base, el sistema debe conectarse a los entornos de trabajo cotidianos y ajustar mediante prompts las convenciones de interacción de cada canal:
- Canales de mensajería instantánea: priorizar una comunicación ligera con la mínima interrupción. Como un compañero humano, notificar solo cuando se necesite una decisión o la aceptación de resultados, hacer preguntas directas y ofrecer conclusiones breves. Una regla estricta, sencilla y eficaz que hemos probado es limitar cada respuesta a un máximo de 100 palabras.
- Canales asíncronos como GitHub, correo y documentos: priorizar entregas estructuradas con alta densidad de información. Por ejemplo, al crear o actualizar una Pull Request, describir completamente el problema, los cambios y los resultados de validación según las convenciones del proyecto. En un asistente personal, redactar directamente correos estructurados y resúmenes de documentos.
5. Separar cómputo, estado y entornos
Los agentes locales existentes vinculan en un mismo dispositivo el cómputo que hace avanzar el Agent Loop, el estado de sesión que debe persistir y el entorno de ejecución, como el repositorio de código y las herramientas locales. Cuando el dispositivo entra en suspensión o se desconecta, el agente deja de funcionar y no puede acceder a los entornos de otros dispositivos. Para que un Super-agent esté disponible de forma persistente y se conecte con flexibilidad a distintos entornos reales, podemos tomar de los sistemas informáticos la idea de separar cómputo y almacenamiento y desvincular estos tres elementos en dos pasos. Primero se separa el cómputo del Agent Loop del estado persistente de la sesión, liberando al agente del ciclo de vida de una máquina y permitiendo su funcionamiento continuo en la nube (sección 5.1). Después se separa el Agent Loop en la nube de los entornos de ejecución que contienen mucho estado, manteniendo los entornos reales donde están y permitiendo el acceso entre dispositivos (sección 5.2).
5.1 Separar el cómputo del estado
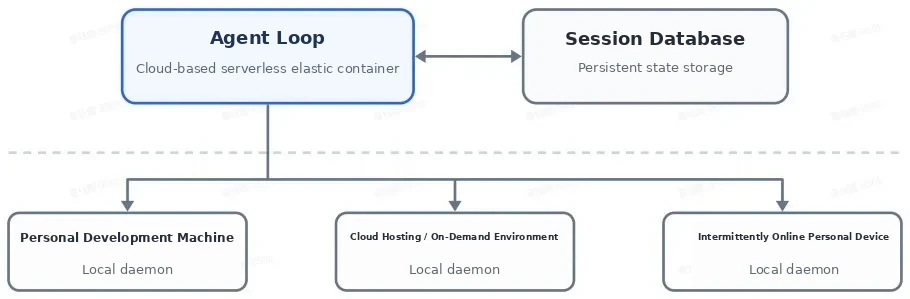
El cómputo que hace avanzar el Agent Loop puede ser sin estado; lo que necesita persistir es el estado de sesión. Por tanto, el primer nivel de separación coloca el cómputo en contenedores elásticos y sin estado en la nube, mientras guarda el estado persistente, como las sesiones, en una base de datos. Los contenedores de cómputo pueden ampliarse horizontalmente, reiniciarse o sustituirse. El almacenamiento persistente mantiene la continuidad de sesiones y tareas, libera al agente del ciclo de vida de un dispositivo local concreto y permite que permanezca conectado en la nube.
5.2 Separar el cómputo de los entornos de ejecución
Una vez que el Agent Loop y el estado de sesión residen de forma persistente en la nube, la siguiente pregunta es cómo acceder a los entornos que requieren las tareas. Gran parte del contexto que necesita el modelo debe obtenerse mediante herramientas que acceden a repositorios, archivos locales, servicios dependientes y otras partes del entorno de ejecución. En este sentido amplio, el contexto incluye el propio entorno de ejecución.
Hay dos enfoques habituales. Uno consiste en iniciar un sandbox en la nube, descargar el código e intentar reconstruir y sincronizar el entorno. Sin embargo, los entornos reales suelen contener cambios locales sin confirmar, credenciales privadas, dependencias de servicios de la red interna y hardware o herramientas específicos. Sincronizarlos es técnicamente costoso y propenso a omitir información. El otro enfoque pide a los usuarios abandonar sus entornos locales y trasladar el trabajo a la nube, pero el coste de migración es demasiado alto para muchos.
Si lo difícil de copiar y sincronizar es el propio entorno, no hace falta trasladarlo a la nube junto con el Agent Loop. El segundo nivel de separación ejecuta el Agent Loop en la nube y mantiene en su lugar los entornos con mucho estado. Un demonio ligero en el dispositivo no guarda estado de sesión y solo ejecuta comandos y devuelve resultados. En la práctica, el entorno permanece fuera de la nube y el agente lee su contexto cuando lo necesita.
Esto coincide con la idea de Anthropic de «separar el cerebro de las manos»: mantener el harness sin estado, almacenar fuera los registros de sesión y conectarse a los entornos de ejecución bajo demanda mediante una interfaz unificada. La diferencia está en el escenario. Aquel artículo describe un servicio gestionado y se centra en los sandboxes creados bajo demanda y los recursos en las VPC de los clientes. Aquí, los primeros entornos que se conectan son los ordenadores personales que se usan a diario, que pueden estar conectados solo de forma intermitente y contener cambios sin confirmar y credenciales locales. Por eso, el diseño admite tanto BYOM —Bring Your Own Machine: conectar el ordenador habitual de desarrollo o personal a un agente en la nube— como máquinas alojadas en la nube o entornos de cómputo creados bajo demanda.
Así, un agente deja de estar limitado a una máquina. Puede cambiar de dispositivo de ejecución y elegir el entorno en función de la tarea para ejecutar comandos y recuperar contexto. Incluso puede trabajar con dispositivos que se conectan de forma intermitente: cuando el dispositivo personal vuelve a estar disponible, el agente en la nube puede activar y completar automáticamente las tareas que necesitan ejecutarse allí. El siguiente diagrama muestra los dos niveles de separación entre cómputo, estado persistente y distintos entornos de ejecución.
6. Watchdog
El funcionamiento persistente exige más que la separación de cómputo y almacenamiento de la sección 5. El sistema también debe recuperarse automáticamente de las incidencias durante periodos largos. Es difícil mantener la fiabilidad de un sistema distribuido siempre activo usando solo su lógica interna. Hace falta un bucle de control externo e independiente del sistema principal.
En un sistema de agentes no bastan las comprobaciones tradicionales de que los procesos siguen activos ni los scripts de supervisión. Muchos fallos no implican que un proceso se cierre: el modelo puede quedarse atrapado en un bucle improductivo o desviarse del objetivo. Por ello, un sistema de agentes de larga duración debe supervisar el progreso de las propias tareas, no solo la disponibilidad de la infraestructura.
Configuramos una sesión Watchdog independiente, fuera del sistema principal, activada por mensajes programados para formar un bucle de control externo. Además de atender fallos de infraestructura, como errores de API y restauraciones fallidas del estado, el Watchdog utiliza un modelo para evaluar si los Workers avanzan realmente y si se han desviado del objetivo general. Cuando detecta una incidencia, interviene con rapidez para repararla. Ante fallos externos intermitentes, sigue comprobando hasta que se reanuda el funcionamiento normal.
Como el propio Watchdog es una sesión de agente con todas las herramientas, los responsables del mantenimiento pueden preguntarle por los fallos en lenguaje natural. También pueden pedirle que cambie el comportamiento del sistema principal mientras funciona, por ejemplo añadiendo o quitando prompts o ajustando las reglas de activación.
7. Experimentos preliminares
Para evaluar los principales diseños de planificación y enrutamiento, realizamos experimentos preliminares a dos niveles. Primero comparamos, de extremo a extremo, la arquitectura de dos capas y la entrega directa por suscripción con enfoques de sesión única (sección 7.1). Después probamos por separado el procesamiento por lotes de la capa Router (sección 7.2). Como se utilizan cargas sintéticas y entornos simplificados, y algunos aspectos de la configuración podrían ser más rigurosos, los resultados siguientes deben considerarse solo referencias preliminares.
7.1 Estudio de ablación
Probamos cuatro enfoques de extremo a extremo con flujos de mensajes de grupos y de CI de GitHub. Cada experimento contenía unos 300 mensajes, aproximadamente 20 de ellos solicitudes de trabajo; el resto eran conversación informal, seguimientos, solicitudes de parada y mensajes de CI. La programación se sustituyó por una herramienta que solo consumía tiempo, por lo que se midieron la planificación y la coordinación del sistema, no la capacidad de ejecutar tareas individuales. Cada enfoque se ejecutó cinco veces.
Los cuatro enfoques fueron Super-agent, Super-agent sin entrega directa y una sesión única con una herramienta Subagent bajo dos configuraciones distintas de prompt.
El prompt neutro decía, en inglés: «Use a subagent for a piece of work when appropriate...».
El prompt que priorizaba la delegación decía, en inglés: «Every message of the chat reaches you, so work you run yourself keeps stopping for new messages. Prefer handing each piece of work to a subagent of its own, and do only small things yourself...».
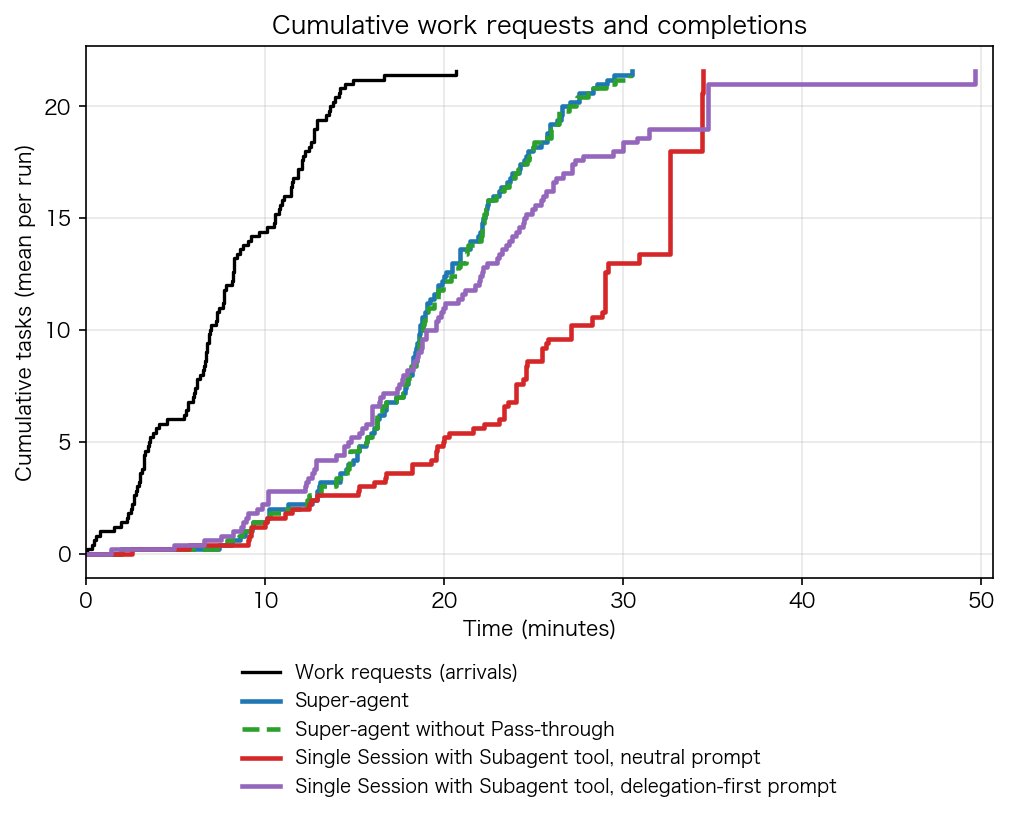
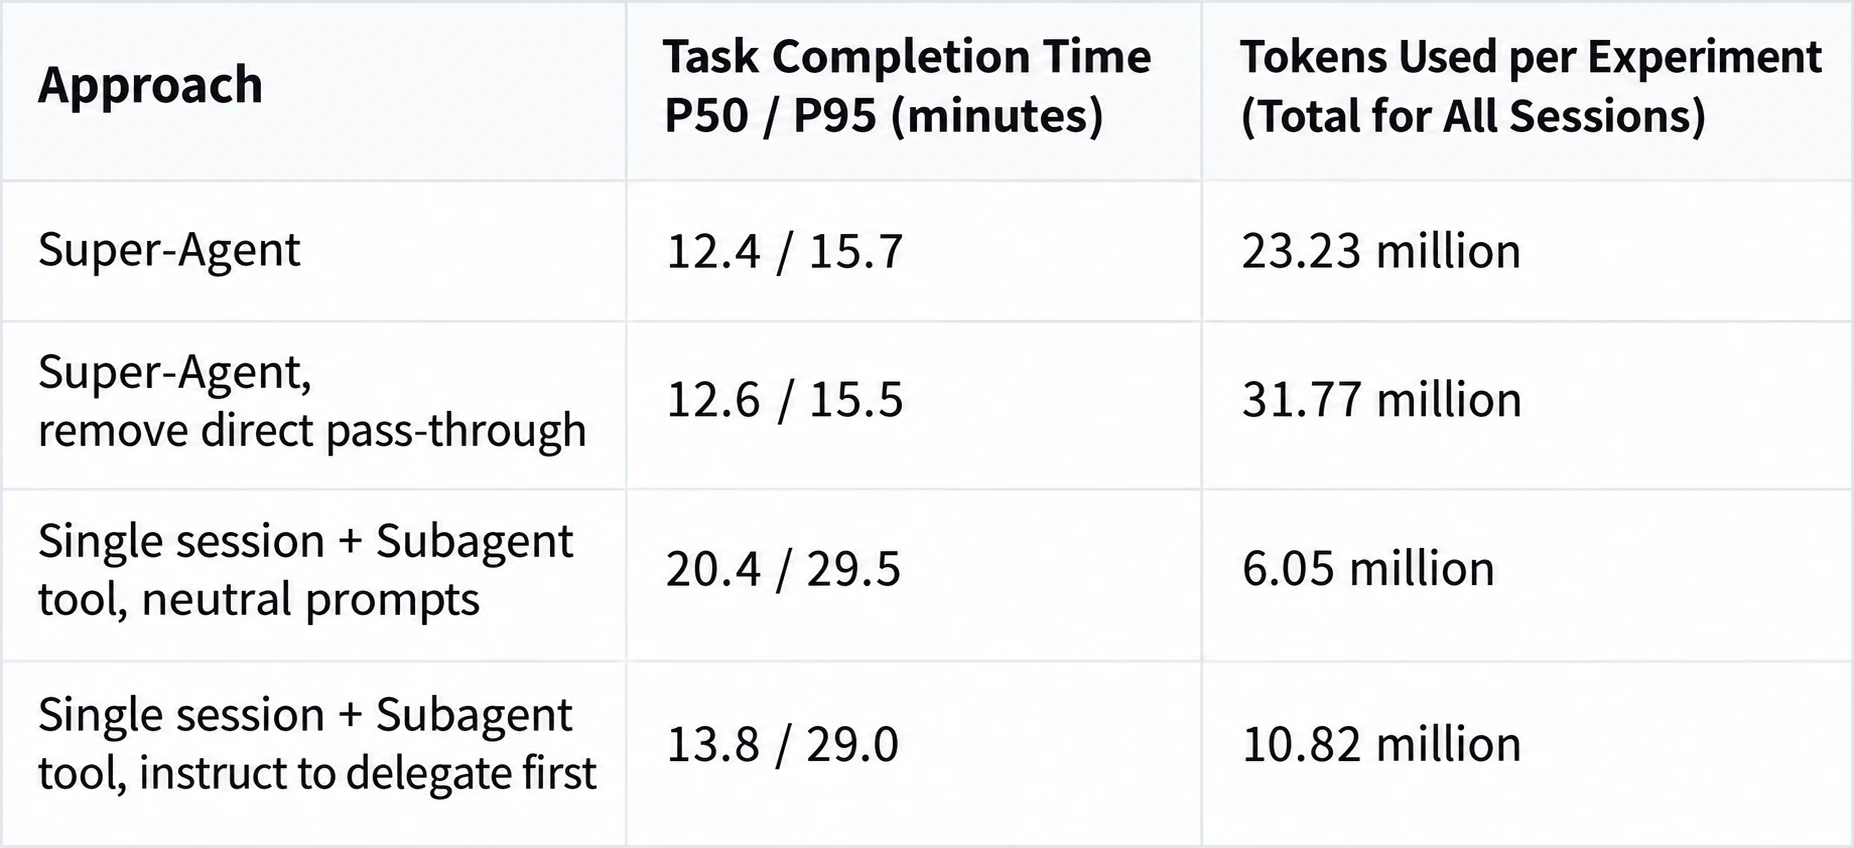
Nota: cada enfoque se ejecutó cinco veces. El tiempo de finalización es el transcurrido entre la solicitud de trabajo y el mensaje con el resultado.
En cuanto al tiempo de finalización, Super-agent logró un p50 de 12,4 minutos y un p95 de 15,7 minutos, resultados sustancialmente mejores que los de la sesión única con una herramienta Subagent. En este entorno experimental, la sesión única con subagentes se vio muy afectada por el prompt. La sesión principal optaba con frecuencia por ejecutar las tareas por sí misma, lo que alargaba los tiempos y producía resultados inestables. Con el prompt neutro, el modelo no invocó ningún Subagent en las cinco ejecuciones. Todo el trabajo se realizó en la sesión principal y quedó interrumpido repetidamente por los nuevos mensajes, hasta alcanzar un p95 de 29,5 minutos. Con el prompt que priorizaba la delegación, el modelo delegó en cuatro de las cinco ejecuciones y redujo los tiempos, aunque siguió siendo más lento en conjunto que Super-agent. En la ejecución restante, consideró que el trabajo era «pequeño» y lo ejecutó por sí mismo, produciendo la larga cola morada de la figura. Frente a depender del diseño del prompt y de las decisiones puntuales del modelo sobre la delegación en una sola sesión, la arquitectura de dos capas alivia el problema en el sistema: el Router no ejecuta trabajo concreto y los Workers solo reciben mensajes de los Threads a los que se suscriben.
En cuanto a la sobrecarga del sistema, mantener varias sesiones independientes hizo que Super-agent utilizara más tokens de lectura de caché por experimento que el enfoque de sesión única. Intercambió un mayor consumo por tiempos de finalización más cortos y estables. Eliminar la entrega directa dejó los tiempos prácticamente iguales, pero aumentó aproximadamente un 30 % el número de decisiones del Router. Los tokens totales de lectura de caché por experimento pasaron de 23,23 a 31,77 millones, un aumento aproximado del 37 %. Con esta carga, la entrega directa no mejoró la calidad ni la velocidad de finalización, pero ahorró una cantidad considerable de tokens y sobrecarga de inferencia a la sesión del Router.
7.2 Procesamiento por lotes en la capa Router
Para evaluar el límite de capacidad y el mecanismo de lotes de la única sesión persistente de Router de la sección 2.1, realizamos una prueba de carga específica de esa capa. El Router invocaba un modelo real, mientras los Workers utilizaban uno simulado. Aumentamos gradualmente la llegada de Triggers que requerían una decisión, desde aproximadamente uno hasta unos 40 por minuto, observando el tamaño medio del lote, la duración de cada solicitud y el tiempo de inferencia repartido entre cada decisión.
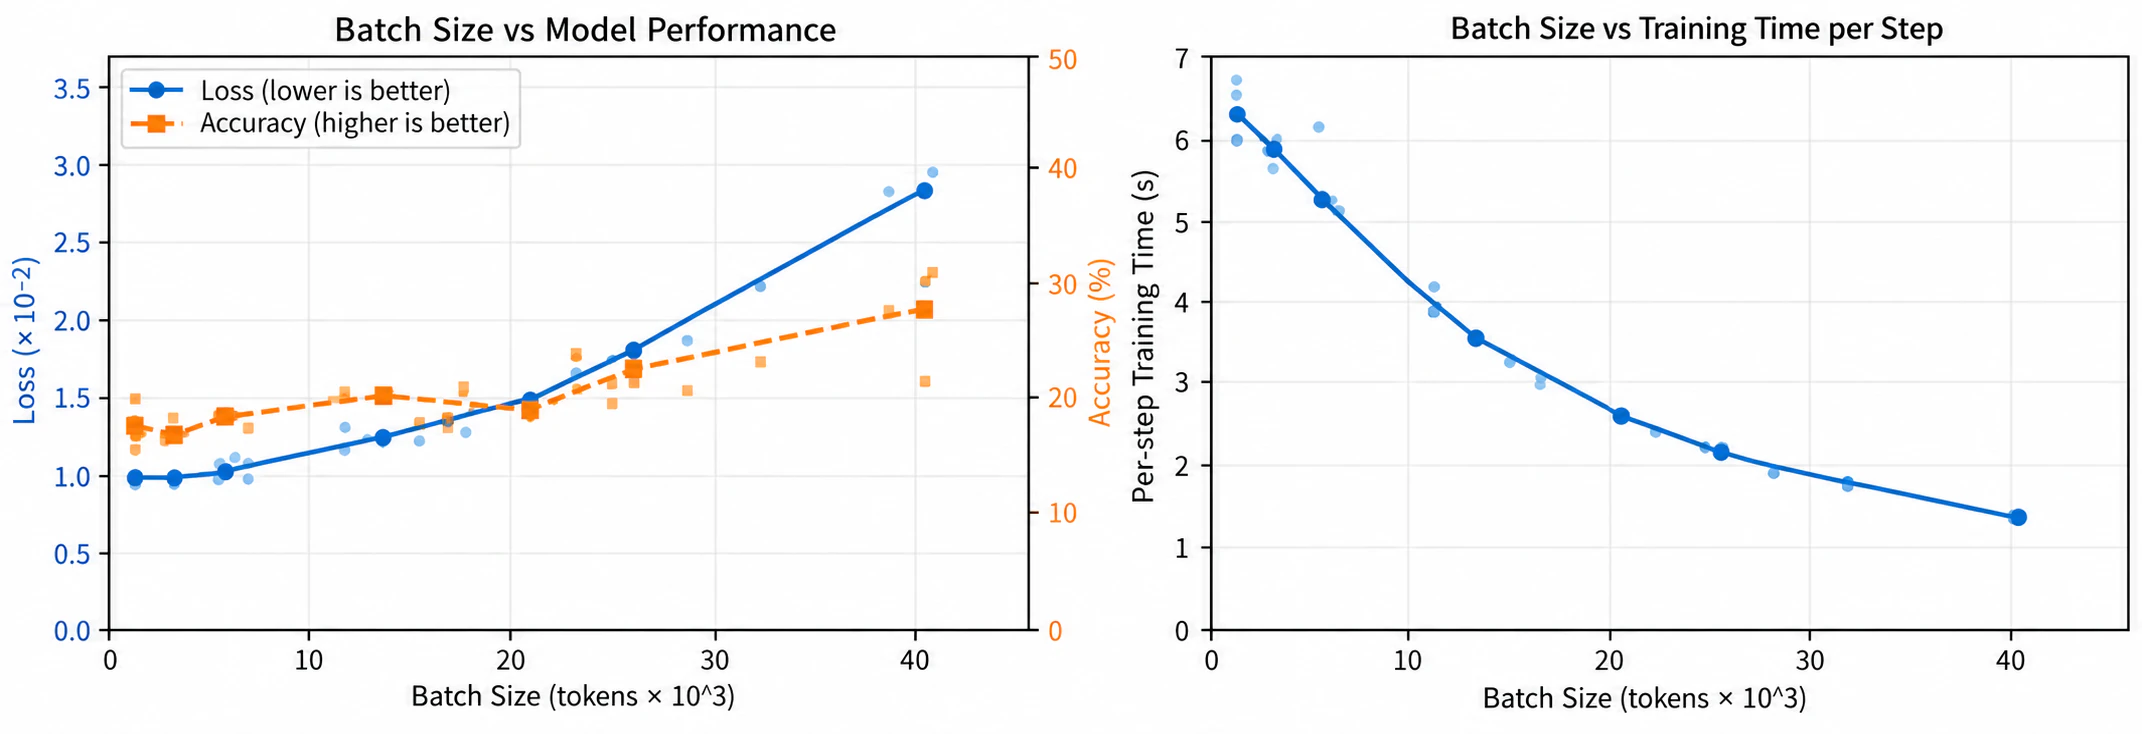
Como muestra la figura, al aumentar de aproximadamente uno a unos 40 por minuto la llegada de Triggers que requerían una decisión, el tamaño medio del lote pasó de 1,0 a 2,8. La duración de cada solicitud solo aumentó de 2,5 a 3,9 segundos, más despacio que el tamaño del lote. Así, el tiempo de inferencia repartido entre cada decisión bajó de 6,4 a 1,6 segundos. Esto significa que, cuando los eventos externos llegan en ráfagas y se acumulan colas, la capa Router puede mejorar la capacidad efectiva agrupando automáticamente los eventos pendientes. También explica por qué eliminar la entrega directa en la sección 7.1 aumentó la carga máxima del Router sin alcanzar el límite de una única instancia. Por tanto, a nuestra escala actual no hace falta dividir prematuramente la capa Router en particiones a costa de la continuidad global del contexto.
8. Cuestiones abiertas
Los cinco módulos de las secciones 2 a 6 constituyen la arquitectura básica de Super-agent. Los experimentos de la sección 7 también mostraron el efecto de los mecanismos centrales de planificación y enrutamiento con varias tareas concurrentes. El sistema funciona con una complejidad relativamente baja gracias, en buena medida, a varias simplificaciones de ingeniería y de escenarios que hemos adoptado en esta fase. Fuera de esos supuestos siguen abiertas cuestiones sobre la ampliación de la arquitectura de dos capas (sección 8.1), la colaboración más allá de las sesiones (sección 8.2), los límites del contexto y A2A (sección 8.3), y la seguridad y la privacidad (sección 8.4).
8.1 ¿Cómo ampliar la arquitectura de dos capas?
La combinación simplificada de «una sesión persistente de Router + entrega directa por suscripción + ausencia de comunicación directa entre Workers» cubre la mayoría de nuestras tareas cotidianas actuales con un coste de ingeniería relativamente bajo. Pero, a medida que aumentan las tareas y sus dependencias mutuas, pueden superar la capacidad de una única sesión del Router. No hay una respuesta definitiva para la estructura interna de cada capa: cuándo dividir el Router, con qué granularidad, cuándo introducir comunicación directa entre Workers de la misma capa y qué topología de colaboración utilizar son cuestiones que deben probarse en más escenarios. También merece explorarse el diseño conjunto del sistema y el modelo. Un entrenamiento específico para evaluar eventos, asignar lotes de trabajo o recuperar contexto en la capa Router podría mejorar aún más su capacidad de procesamiento y de decisión.
Por otro lado, la capa Router persistente y la Chain of Recall basada en un grafo de referencias resuelven principalmente la recuperación bajo demanda de tareas recientes y del historial de sesiones. Cuando el funcionamiento se prolonga durante meses o más, la memoria a largo plazo pasa a ser el principal cuello de botella de la capacidad de crecimiento.
8.2 ¿Cómo colaborar con agentes más allá de las sesiones?
La arquitectura de dos capas oculta a los usuarios la gestión interna de varias sesiones, por lo que estas dejan de tener que ser la consideración principal del diseño del producto. Pero, cuando las sesiones de ejecución ya no corresponden directamente a conversaciones de la interfaz, surge otra pregunta: ¿cómo presentar las tareas y qué experiencia de interacción y gestión de proyectos resultaría natural? Creemos que la interacción centrada en un chat es, en cierta medida, consecuencia de las decisiones de diseño heredadas. Podría haber más interacción en interfaces específicas del ámbito de trabajo: por ejemplo, un Super-agent puede trabajar directamente en Issues y Pull Requests de GitHub, como en los ejemplos de este artículo. Las sesiones también pueden seguir apareciendo en la interfaz para respetar los hábitos del usuario, pero una conversación visible no tiene que corresponder a una sola sesión interna.
Hasta ahora hemos tratado sobre todo la interacción humana al iniciar tareas y aceptar resultados. Sin embargo, en este periodo de transición en el que las capacidades de los modelos cambian rápidamente, muchas tareas siguen necesitando participación humana durante el proceso. También merece explorarse cómo equilibrar, desde el diseño de producto, la intervención gradual en detalles importantes con la eficiencia del trabajo autónomo en segundo plano. Por ejemplo, permitir que el usuario intervenga, tome el control o colabore con el agente en tiempo real mientras este trabaja en segundo plano.
En general, las experiencias necesarias de gestión de proyectos e interacción están muy vinculadas al ámbito de trabajo y al estilo personal. Su forma final probablemente será muy personalizada. La arquitectura abierta de DeepSeek Harness también facilita este tipo de adaptación.
8.3 ¿Cómo definir los límites del contexto y la colaboración A2A?
Hasta aquí hemos tratado el diseño interno de una única instancia de Super-agent, suponiendo que toda la información de su ámbito se reúne en un contexto global. Pero, cuando el uso pasa de una persona o un equipo pequeño a una organización mayor, decidir cómo desplegar Super-agents equivale a decidir los límites para compartir y aislar contexto. Los ámbitos que necesitan compartirlo usan la misma instancia; los que necesitan aislamiento, instancias distintas.
Si avanzamos un paso más, cuando existen varias instancias aisladas dentro de una organización o entre organizaciones —por ejemplo, los asistentes personales de los miembros junto a un Super-agent compartido del equipo—, colaborar a través de esos límites se convierte en comunicación entre agentes, o A2A, sin referirnos a un protocolo concreto. Sigue abierta la cuestión de cómo lograr comunicación y colaboración A2A seguras y fiables entre agentes que no comparten su contexto interno y representan límites de permisos distintos.
8.4 ¿Cómo proteger la seguridad y la privacidad?
El diseño por eventos de la sección 3 permite que el agente reciba estímulos de entornos más diversos, pero también aumenta su exposición a entradas no fiables. Si no se resuelven adecuadamente los problemas de seguridad y privacidad, un Super-agent solo podrá operar en un ámbito pequeño y de confianza.
Por ejemplo, desplegar el Agent Loop en la nube e instalar demonios ligeros en los dispositivos de ejecución, como plantea la sección 5, supone confianza mutua entre la nube y los entornos de los dispositivos. Pero, cuando el Agent Loop recibe continuamente eventos externos y los dispositivos conectados contienen código privado, datos sensibles y credenciales locales, estas conexiones introducen riesgos importantes de seguridad y privacidad. Si el Agent Loop en la nube se ve comprometido por una intrusión en el servidor o una inyección de prompts, todos los dispositivos conectados podrían quedar bajo control del atacante.
Además, aunque la nube no se haya visto comprometida, pueden filtrarse credenciales durante la ejecución normal si las de los dispositivos pueden entrar en el contexto del modelo. Por eso hacen falta mecanismos que permitan al agente utilizar credenciales sin llegar a conocerlas directamente. Para que esta arquitectura se adopte de forma más amplia, debe resolver estos problemas de seguridad y privacidad sin perder la capacidad de recuperar contexto de entornos diversos.
9. Conclusión
Si revisamos el diseño completo, no hemos propuesto una teoría nueva. Hemos aplicado ideas clásicas de ingeniería de sistemas informáticos a la construcción de sistemas de agentes. Las implementaciones concretas evolucionarán con la tecnología, pero creemos que las ideas de diseño subyacentes seguirán siendo útiles durante más tiempo. La instancia interna de Super-agent que construimos con estas ideas y DeepSeek Harness ya funciona de manera continua. Participa en la reproducción y corrección cotidiana de incidencias, las respuestas a revisiones de código y el desarrollo del propio DeepSeek Harness.
Como señalamos al principio, los modelos grandes necesitan cada vez menos intervención humana para ejecutar tareas individuales, y el cuello de botella de las siguientes mejoras de productividad se desplaza hacia la atención humana. Mediante una arquitectura de dos capas, el funcionamiento por eventos, la interacción asíncrona entre canales, la separación de cómputo y almacenamiento y un Watchdog externo, el sistema asume la tediosa gestión de sesiones y sincronización del contexto. Así las personas pueden alejarse de los detalles de ejecución y centrarse en decisiones de mayor nivel y en la aceptación de resultados.
Con esta forma, un agente deja de ser una simple ventana de chat que espera instrucciones de manera pasiva. Evoluciona hacia un colaborador autónomo, siempre conectado al entorno digital. Para una persona puede ser un asistente que ayuda a gestionar asuntos cotidianos entre dispositivos. Para un equipo se integra en el desarrollo, asumiendo y haciendo avanzar tareas concretas. Creemos que, al evolucionar conjuntamente las capacidades de los modelos y las arquitecturas de los sistemas, esta manera más autónoma de trabajar podría convertirse en la norma de colaboración entre personas y agentes.
Algunos de los diseños del artículo están implementados en dsh-superagent-prototype. Puedes consultar el repositorio en GitHub. Este plugin es solo un prototipo para validar el enfoque técnico; no es un producto oficial de DeepSeek.
Autor y agradecimientos
Este artículo surgió de la práctica compartida del equipo de DeepSeek Harness. Yujia Qiao implementó el sistema y escribió el artículo. Huanqi Cao, Zui Chen, Xieting Chu, Tianyi Cui, Shiyuan Feng, Yudong Han, Kexin Liu, Shichun Liu, Gesi Luo, Yifan Shi, Tongrui Xiong, Hanxiang Xu, C.C. Yu, Ziya Zhang, F. Zhou y otras personas participaron en las revisiones y los debates y aportaron comentarios. Tanto la implementación del sistema como la elaboración del artículo dependieron de los intercambios cotidianos y la experiencia acumulada del equipo.