DeepSeek Super Agent 是一个运行在 DeepSeek Harness 之上的开源研究原型,探索的是团队中的多 Agent 协作:多个人提出任务、补充信息,由系统组织多个 AI Agent 推进工作。
DeepSeek Harness 团队已经公开了系统设计和 GitHub 上的可运行原型。我们认为,以研究原型的形式发布,可能反映出团队仍在探索不同的架构和应用方向。随着这些方向继续发展,我们预计还会看到更多开源原型。
DeepSeek Super Agent 的原始技术文章以中文发布。我们整理了全文和配图,可以阅读完整中文原文,了解完整设计和实验结果。
TL;DR
| 问题 | 简要回答 |
|---|---|
| 它是什么? | 一套协调多个人、多个任务和多个 AI Agent 的系统设计,同时提供基于 DeepSeek Harness、采用 MIT 许可证的研究原型。 |
| 能做什么? | 让团队成员交办和跟进不同任务,由系统协调 Agent,减少人工分配任务、传递上下文和追踪进度的工作。 |
| 核心架构是什么? | Router 负责关联请求与任务、分派工作;Worker 执行具体任务;任务记录和线程订阅把后续事件连接到正在进行的工作。 |
| 公开原型实现了什么? | 面向单个 GitHub 仓库中的编码任务,支持 GitHub 和可选的飞书接入。 |
| 运行需要什么? | 兼容的 DeepSeek Harness、模型服务、运行机器、目标仓库,以及 Agent 专用的 GitHub 账号。 |
| 实验表现如何? | 在模拟工作负载下,相对中性提示词基线,任务完成时间中位数减少约 39%;相对优先委派基线,减少约 10%,同时增加了缓存读取 Token 用量。 |
| 主要限制是什么? | 公开代码仍是研究原型,需要配置运行环境和权限。实验使用模拟延迟代替实际编码,测量的是调度行为,没有测量代码质量、人工审核和长期维护成本。 |
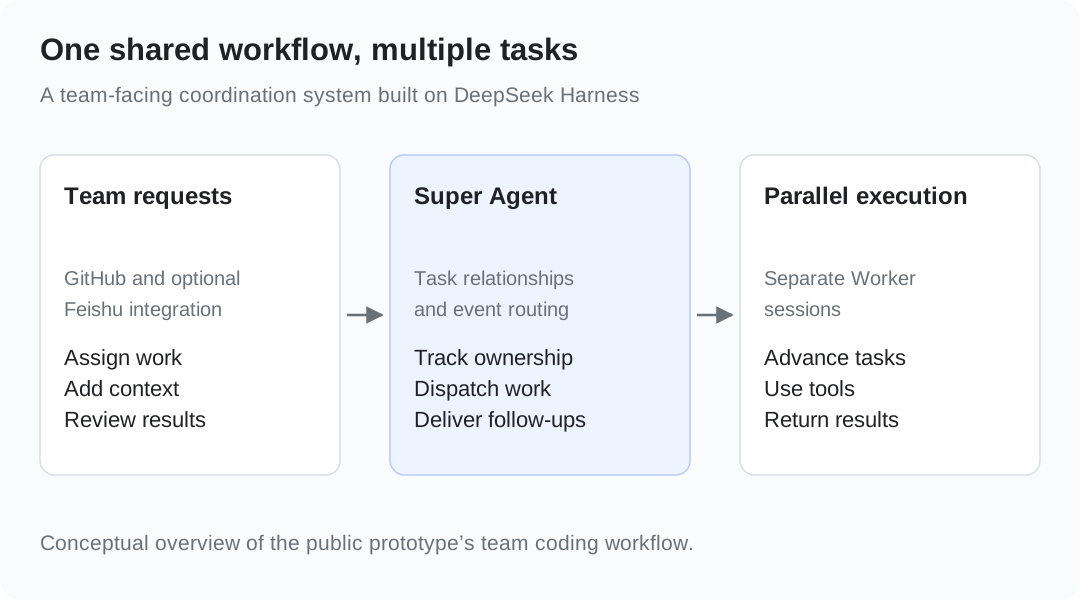
我们怎么看:整合价值与设计取舍
我们认为,这套设计的整合价值大于架构创新。 Router–Worker 分工、事件驱动、持久化任务记录和后台任务,都建立在已有的工程思路上。很多类似机制和设计模式,已经在 Offloop 中使用了超过六个月。Super Agent 值得研究的地方,是把这些部分整合成一个开发者可以查看、运行和讨论的开源系统。
我们尤其看重它对任务管理的处理。多个人交办工作、补充上下文和审核结果时,明确的记录与程序规则负责追踪任务归属、授权和执行状态。线程订阅把后续消息送到对应的 Worker。这些机制比单纯增加 Agent 数量更有工程参考价值。
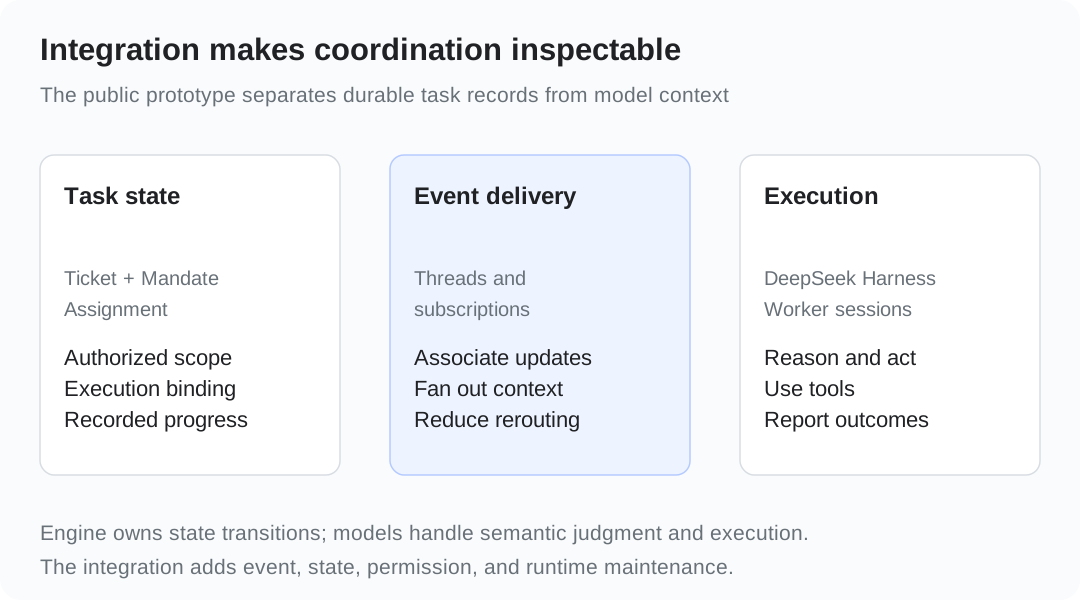
现有实验每种配置只有五次运行。相对优先委派基线,Super Agent 的任务完成时间中位数减少约 10%,缓存读取 Token 用量约为其 2.1 倍。基于我们开发 Offloop 的经验,我们认为,在多人参与、多个任务并行的工作流中,这套设计具有理论上的效率优势:明确的任务归属和事件路由,可以减少重复协调、上下文交接和执行中断。我们会在真实团队工作负载中测试这种优势,衡量任务验收、审核与返工时间、协调投入和总成本。
DeepSeek Super Agent 是什么?
DeepSeek Super Agent 是一套面向持续协作的系统设计。团队成员提交请求、补充上下文、审核结果;系统把这些输入关联到正在进行的任务,并协调多个执行会话完成工作。
它要解决的核心问题是:多个人如何与多个 AI Agent 一起工作。
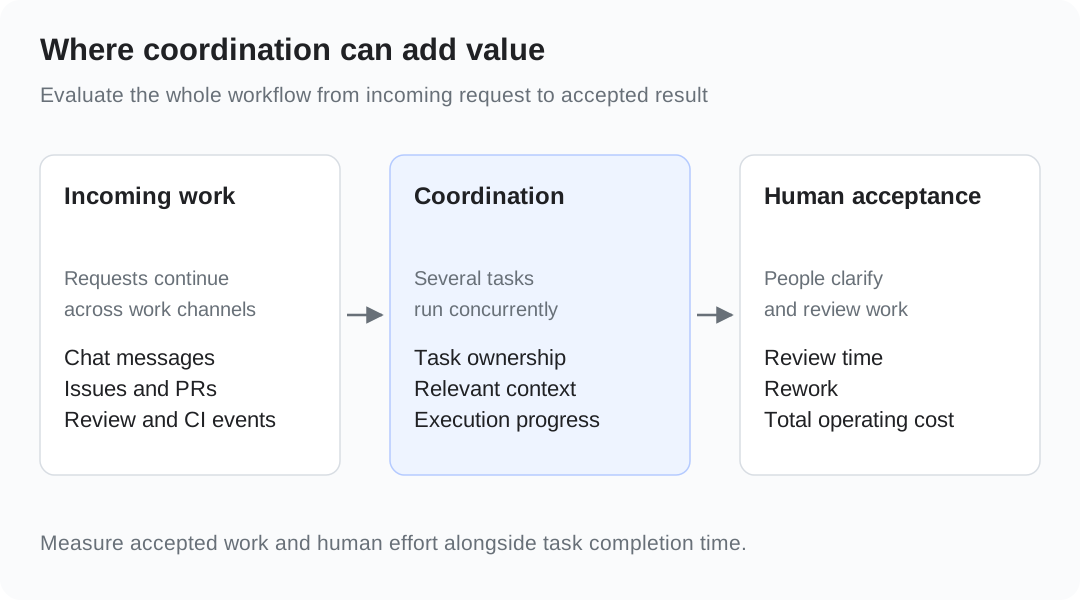
例如,一位同事在聊天中提出需求,开发者在 GitHub Issue 中补充复现步骤,审核者随后在 PR 中要求修改。这些输入发生在不同渠道、不同时间,却属于同一项工作。系统需要识别这种关系,把信息送到对应的执行者,并保留任务进度和范围。
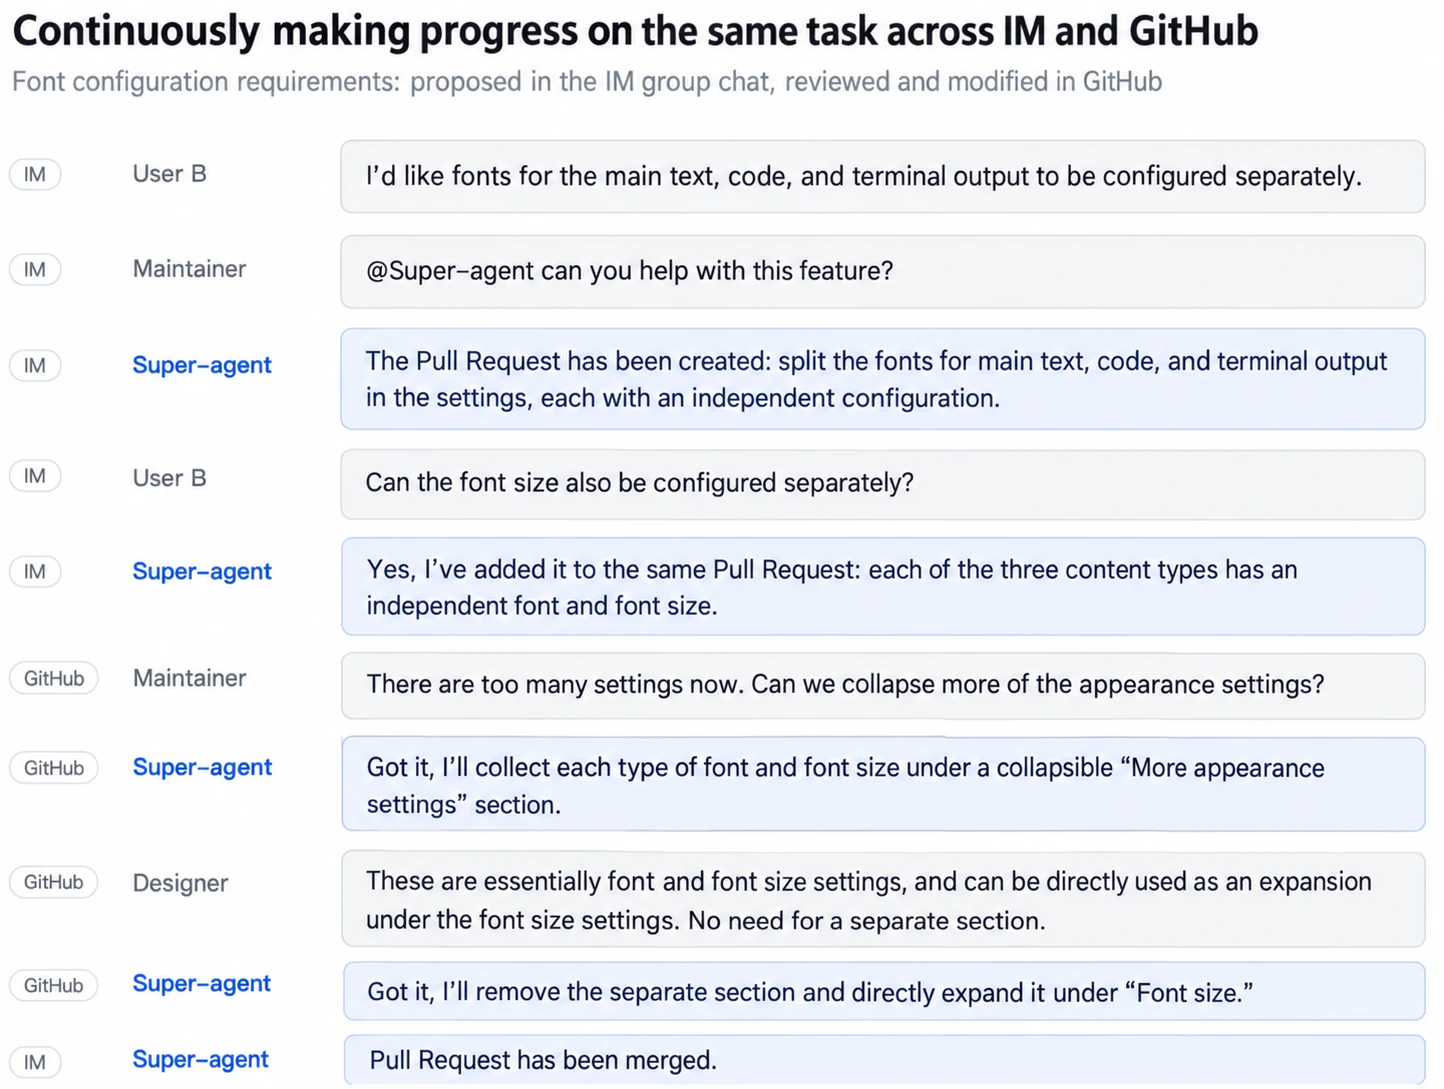
Super Agent 运行在 DeepSeek Harness 上。Harness 提供工具执行、Agent 会话等基础能力,Super Agent 在此基础上协调任务、事件和多个 Agent。
为什么要设计 DeepSeek Super Agent?
模型越来越能独立完成单项任务,但团队仍然需要在人和并行任务之间协调请求、上下文和进度。DeepSeek Super Agent 希望把更多协调工作交给系统。
假设一个团队同时处理三个请求:
- 产品经理在飞书中提出一个功能需求。
- 开发者在 GitHub 上报告测试失败。
- 审核者要求修改一个已有 PR。
与此同时,不同 Agent 可能正在执行任务、等待外部结果,或者等待人做决定。
系统需要持续回答一些实际问题:新消息属于已有任务,还是应该创建新任务?任务由谁负责?是否已经有其他 Agent 在处理?补充信息应该送到哪里?下一步需要谁澄清、授权或审核?
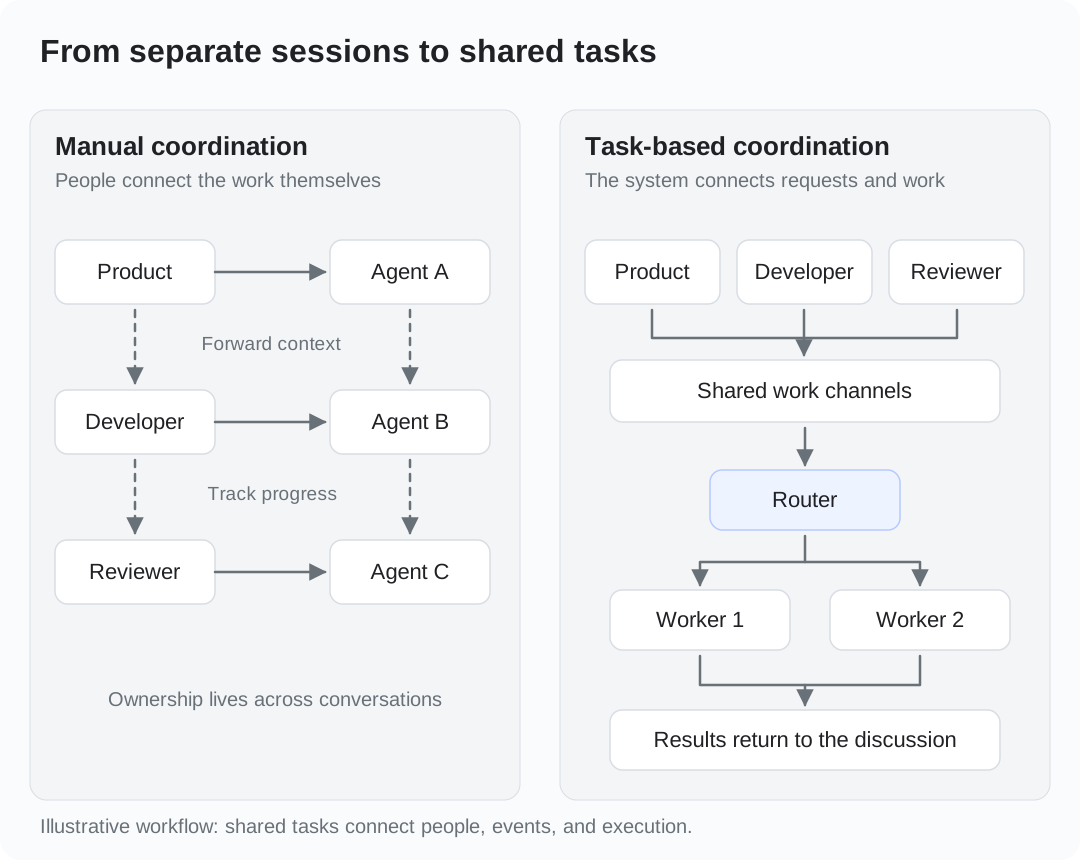
这些关系由人手动管理时,团队会花时间搜索讨论、转发上下文、追问进度。把所有内容放进一个会话,又会混合无关任务的上下文,让新消息打断正在进行的工作。
Super Agent 尝试在这些需求之间取得平衡:协调层保留跨任务关系,独立执行会话分别推进工作,团队成员继续通过熟悉的渠道协作。原文的以人为中心的交互设计介绍了人如何在执行过程中参与,以及如何跨渠道与 Agent 交互。
这与 Offloop 的设计非常相似。DeepSeek 这篇技术文章的作者,也和我们团队的开发者交流过思路。这些讨论,加上我们开发 Offloop 的经验,帮助我们更深入地理解了这套架构的目标和取舍。
你也可以现在体验 Offloop。我们已经实现了这种多人、多 Agent 协作方式,目前正在内部测试。可以把它理解为 AI 队友在一个类似 Slack 的协作空间中工作:人交办任务、补充信息、跟进进度;Agent 分配工作,再把结果带回讨论。
DeepSeek Super Agent 如何工作:Router–Worker 架构
Router–Worker 如何分配任务?
Super Agent 使用两层 Router–Worker 架构。
Router 维护跨任务关系,判断一个新请求应该创建任务、关联到已有任务,还是交给已有执行者。Worker 在各自的执行上下文中处理具体任务,也可以按需使用子 Agent。
这种分工把协调和执行分开。一个 Worker 修改代码时,另一个 Worker 可以处理独立请求。针对第一个任务的补充指令,仍然关联到原任务。
原文提出,通过限制 Router 的执行工具,让它专注于协调,例如不为 Router 配置 Bash。
公开原型采用了不同方式:Router 保留 Bash 等工具,但使用更小的工具集、更短的 Shell 等待时间,并通过提示词要求它避免直接查看代码和实施修改。
具体实现可以参考公开原型的架构文档。
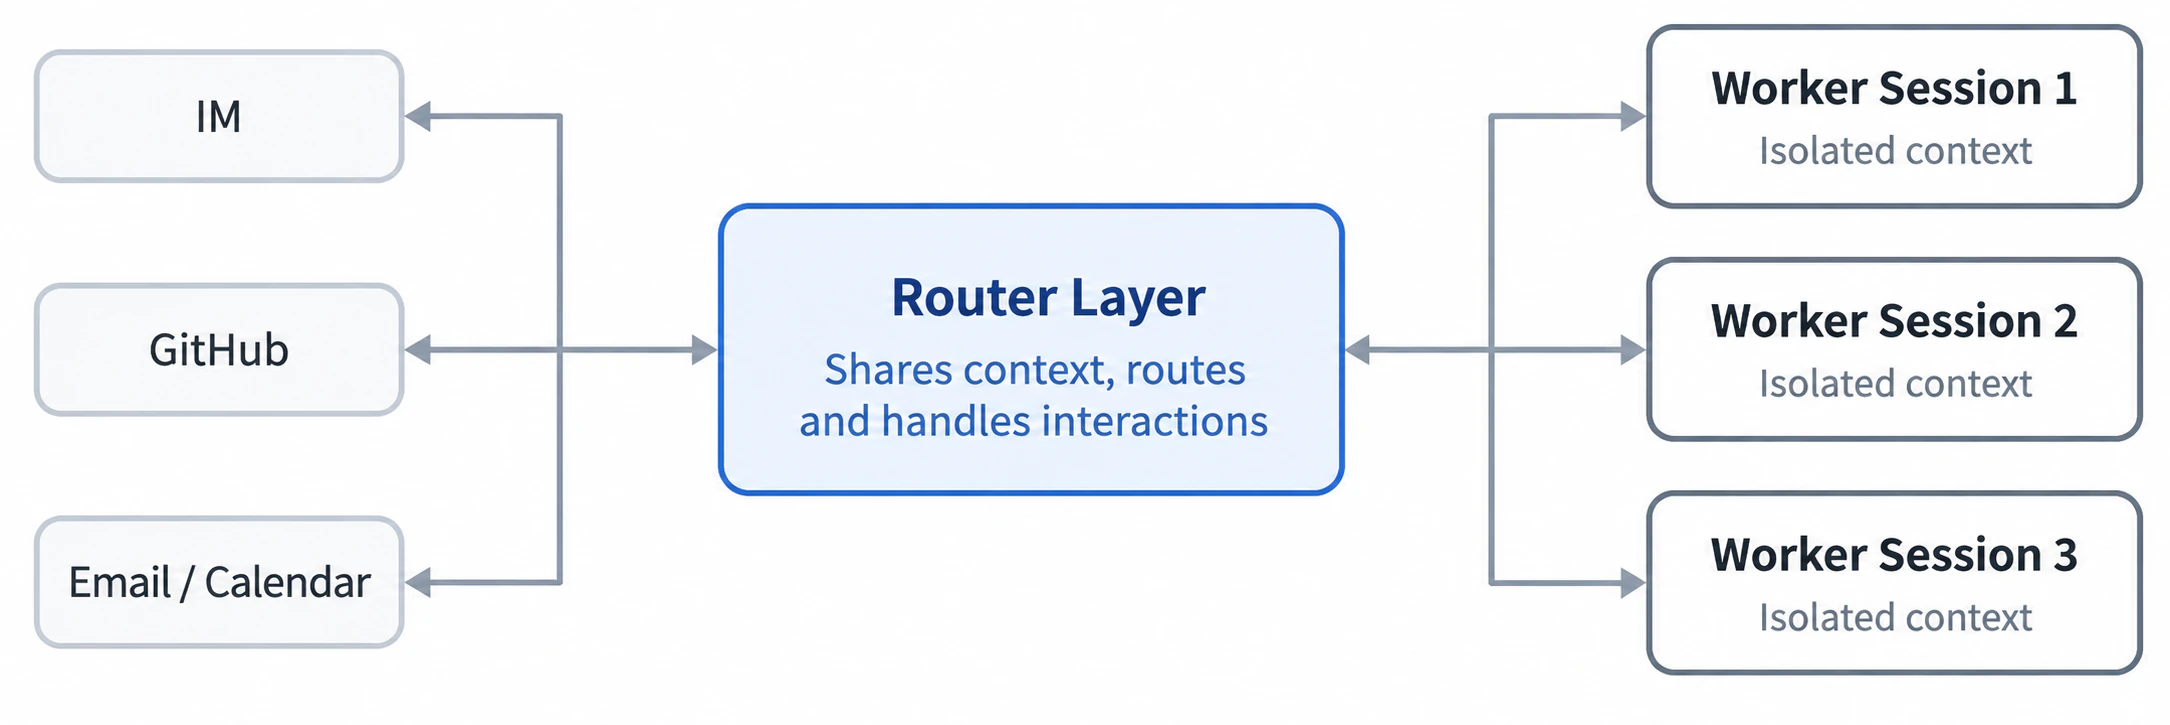
完整架构图见中文原文第 2 节。
事件驱动的任务调度与线程订阅
Super Agent 的事件驱动架构,把新请求和后续事件连接到正在进行的工作。任务调度包括创建任务、关联执行会话,以及在更新到达时将其送达。
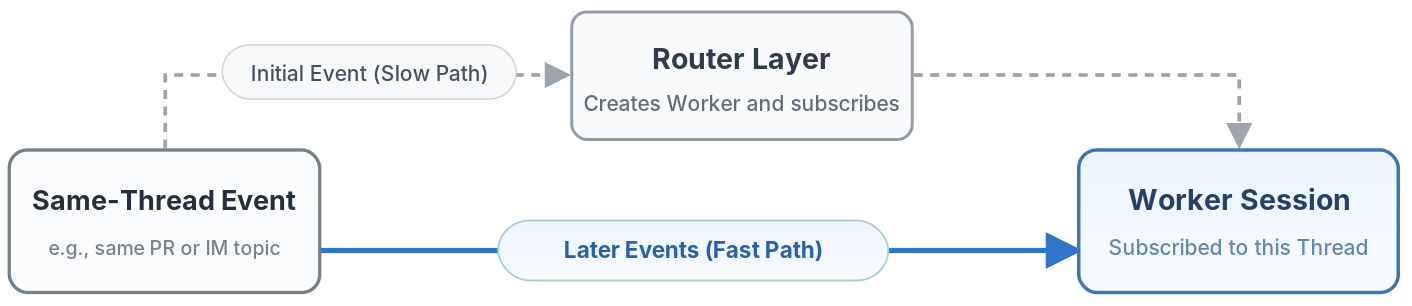
以团队编码任务为例。
一位获准交办任务的同事报告测试失败。系统识别请求,创建任务及其授权记录,并关联一个 Worker 执行。
另一位同事在同一个 Issue 中补充日志。由于这个线程已经订阅到该任务,新增信息可以直接到达对应 Worker。
第三位同事提出一个无关的文档修改请求。系统可以为其建立独立任务,交给另一个 Worker,分别维护上下文。
PR 审核和 CI 结果随后作为事件到达。如果新请求超出任务已有的授权范围,系统会重新评估,而不会仅凭一条后续消息扩大权限。
阅读公开实现时,三个概念尤其有用:
| 概念 | 作用 |
|---|---|
| Ticket | 记录任务及其授权范围。 |
| Assignment | 将任务关联到一次具体执行。 |
| Thread subscription | 将后续消息和事件送到对应执行者,减少重复路由。 |
初始请求建立任务关系,订阅机制让后续事件直接到达 Worker。原文的事件驱动设计进一步介绍了信息过滤、路由和上下文组织。
任务授权:哪些请求可以触发执行?
接入规则先检查来源和身份,再由模型判断内容与任务的关系。Issue 评论、日志和 CI 结果可以补充上下文,但不会因此授予执行权限。
公开原型区分了几种授权情况:
- 默认观察模式下,系统可以识别并记录推断出的工作,但不会自动执行。
- 明确提出的请求,在满足相关规则时可以触发执行。
- 自动执行需要配置对应的授权规则。
这些机制决定一条被观察到的消息如何变成获准执行的工作。具体设计见原型的授权文档。
上下文管理、后台执行与持久化
持续运行的 Agent 无法依赖无限增长的上下文窗口。
Super Agent 围绕任务和事件组织上下文:在当前上下文中保留必要的摘要和引用,按需检索较长内容,并沿着任务、线程和事件之间的关系找回历史。这些机制主要优化上下文占用、重复输入和历史材料的访问。
长期记忆还涉及其他问题:旧结论什么时候失效?冲突信息如何合并?摘要是否遗漏了重要条件?历史记录是否仍然符合当前事实?原文没有详细介绍专门处理这些问题的机制。
耗时操作也与新输入分开处理。工作在后台继续,完成后以新事件返回,让系统在执行期间仍然能够接收其他输入。
原文进一步提出计算、状态和执行环境分离:Agent Loop 在云端运行,持久化状态独立存储,执行设备通过轻量守护进程接收命令。运行 Agent 的计算资源,可以与保存代码、依赖和凭证的机器分别管理。
公开原型的部署文档描述了更集中的部署方式:由 tmux 启动 DeepSeek Harness,配置的状态目录保存数据库,并在执行机器上准备任务工作目录。
原文中的 Watchdog还会评估任务进展。一个独立 Agent 会话检查 Worker 是否停滞,或偏离任务目标。公开部署文档中的状态检查和重启流程,主要处理进程、配置与运行错误。重启服务和判断任务是否在有效推进,是两种不同的能力。
README解释了这种差异:公开代码经过了发布适配,与内部实现及文章描述的架构有所不同,部分设计仍留待后续探索。
DeepSeek Super Agent 与子 Agent:任务协调有什么不同?
两种方式都能并行执行工作。主要区别是由谁组织任务,以及正在进行的工作如何收到后续消息。
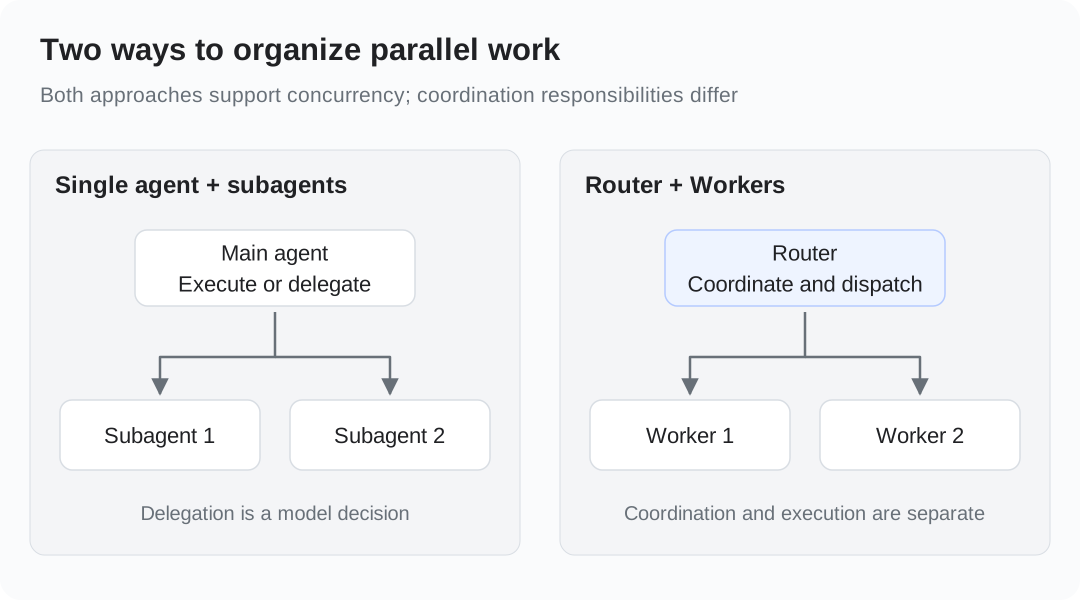
| 维度 | 单个 Agent 配合子 Agent | Super Agent |
|---|---|---|
| 协调方式 | 主 Agent 在执行过程中决定何时委派。 | 架构上分离 Router 与 Worker 的职责。 |
| 并行工作 | 多个子 Agent 处理被委派的子任务。 | 不同 Worker 推进独立任务。 |
| 后续消息 | 由主会话或其他机制将更新关联到进行中的工作。 | 通过任务关系和线程订阅,将更新送到执行者。 |
| 持续协作 | 取决于产品如何管理状态和会话。 | 持久化任务、事件投递和跨任务协调是设计核心。 |
| 复杂任务 | 主 Agent 可以直接执行,也可以委派。 | Worker 本身还可以调用子 Agent,进一步组织执行。 |
Super Agent 的价值超出了“有多个 Agent”。更值得研究的是,它如何减少对模型临时决定是否委派的依赖,以及如何在执行过程中持续处理新输入。原文的两层架构设计详细解释了这一区别。
DeepSeek Super Agent 与 Claude Code、Codex
DeepSeek Super Agent 是用于探索和验证架构的开源研究原型。Claude Code 和 Codex 则是面向用户交付、持续维护的产品。它们分别回答不同的问题:如何设计多人、多 Agent 系统,以及用户今天如何通过现有产品完成工作。
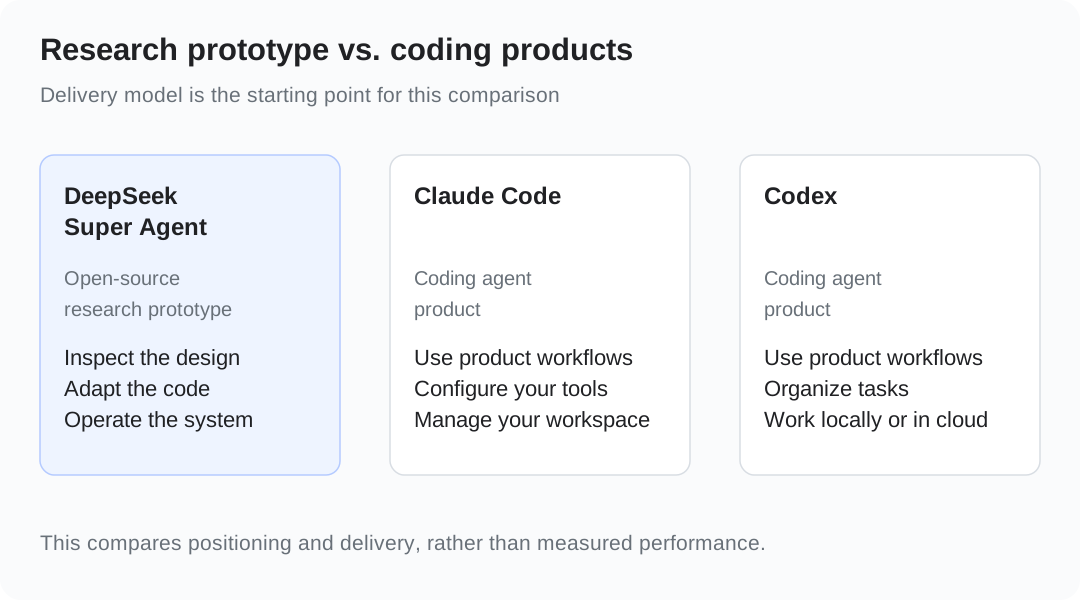
| 维度 | DeepSeek Super Agent | Claude Code | Codex |
|---|---|---|---|
| 定位与交付 | 提供代码和架构文档的开源研究原型。 | 编码 Agent 产品。 | 编码 Agent 产品。 |
| 主要价值 | 查看、修改和复用任务协调、授权及事件路由机制。 | 可直接使用的编码、工具调用和子 Agent 工作流。 | 通过任务、线程和工作空间组织本地及云端编码工作。 |
| 协作重点 | 多个人持续交办和更新任务,通过 Router–Worker 分工协调。 | 主 Agent、子 Agent,以及实验性的 Agent Teams。 | 围绕独立任务和线程组织并行工作。 |
| 如何开始 | 部署原型,配置模型、账号、权限和执行环境。 | 安装、配置并使用现有产品界面。 | 使用 App、CLI、IDE 集成或云端任务。 |
| 维护责任 | 用户维护原型及其运行环境。 | 厂商维护核心产品能力,用户管理配置和开发环境。 | 厂商维护核心产品能力,用户管理配置和开发环境。 |
相关资料:Claude Code 文档、Agent Teams 文档、Codex 子 Agent 文档、Codex 云端文档。
DeepSeek Super Agent 与 Grok Bot、Muse
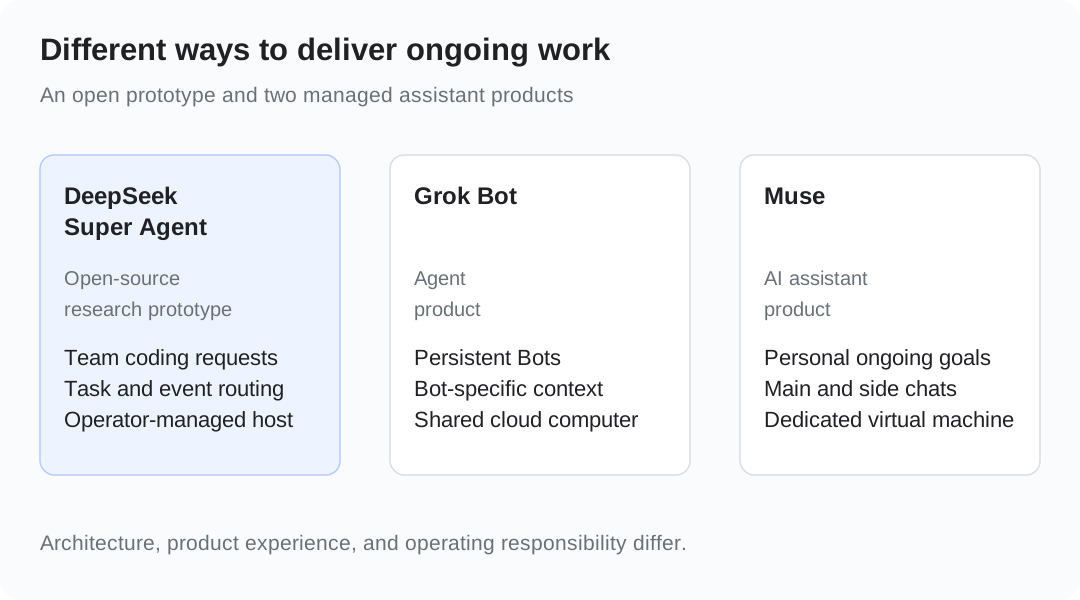
Grok Bot 和 Muse 也以产品形式提供持续工作、多任务或个人助理体验。Super Agent 的特点,是公开了系统设计,以及开发者可以查看和修改的实现。
| 维度 | DeepSeek Super Agent | Grok Bot | Muse |
|---|---|---|---|
| 定位与交付 | 开源研究原型。 | Agent 产品。 | AI 助理产品。 |
| 主要方向 | 协调多个人、多个任务和多个执行者。 | 围绕不同 Bot 组织持续任务和上下文。 | 个人多任务处理和持续助理体验。 |
| 工作组织 | Router、Worker、任务记录和事件订阅。 | 不同 Bot 维护各自上下文,并使用共享资源。 | 通过主对话和侧边对话组织工作。 |
| 上下文与记忆 | 围绕任务和事件组织上下文,并持久化状态。 | 按 Bot 组织工作上下文。 | 提供用户可以查看和编辑的持久记忆。 |
| 执行环境 | 用户配置运行机器和仓库。 | 同一账号下的 Bot 共享持久化云电脑。 | 专用虚拟机提供浏览器、文件和终端能力。 |
| 开发者可获得的材料 | 源代码、架构文档和实验设计。 | 产品能力及公开文档。 | 产品能力、公开介绍和研究说明。 |
相关资料:Grok Bot 文档、Muse 介绍、Muse 安全设计。
DeepSeek Super Agent 实验:完成时间与 Token 用量
初步实验使用约 300 条消息,其中约 20 条是工作请求,其余包括闲聊、跟进、停止请求和 CI 通知。
每种配置运行五次。实验使用工具中的模拟延迟代替实际编码,因此测量的是调度和协调行为,没有评估生成代码的质量、人工审核和返工时间。
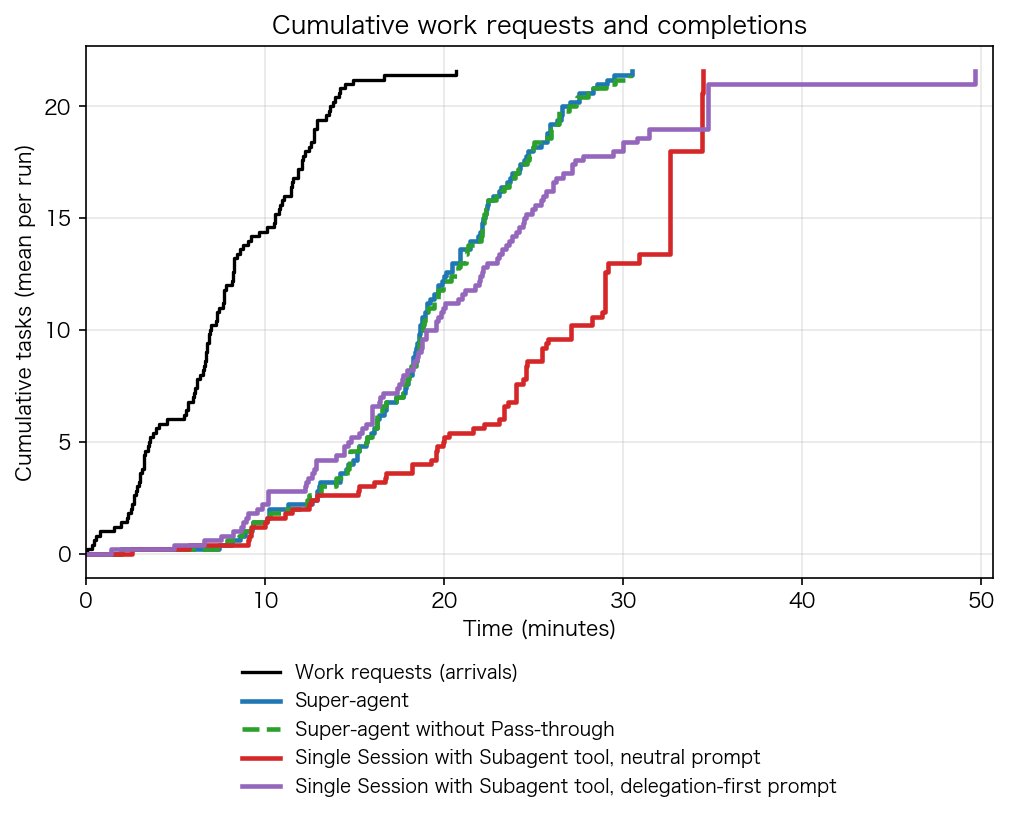
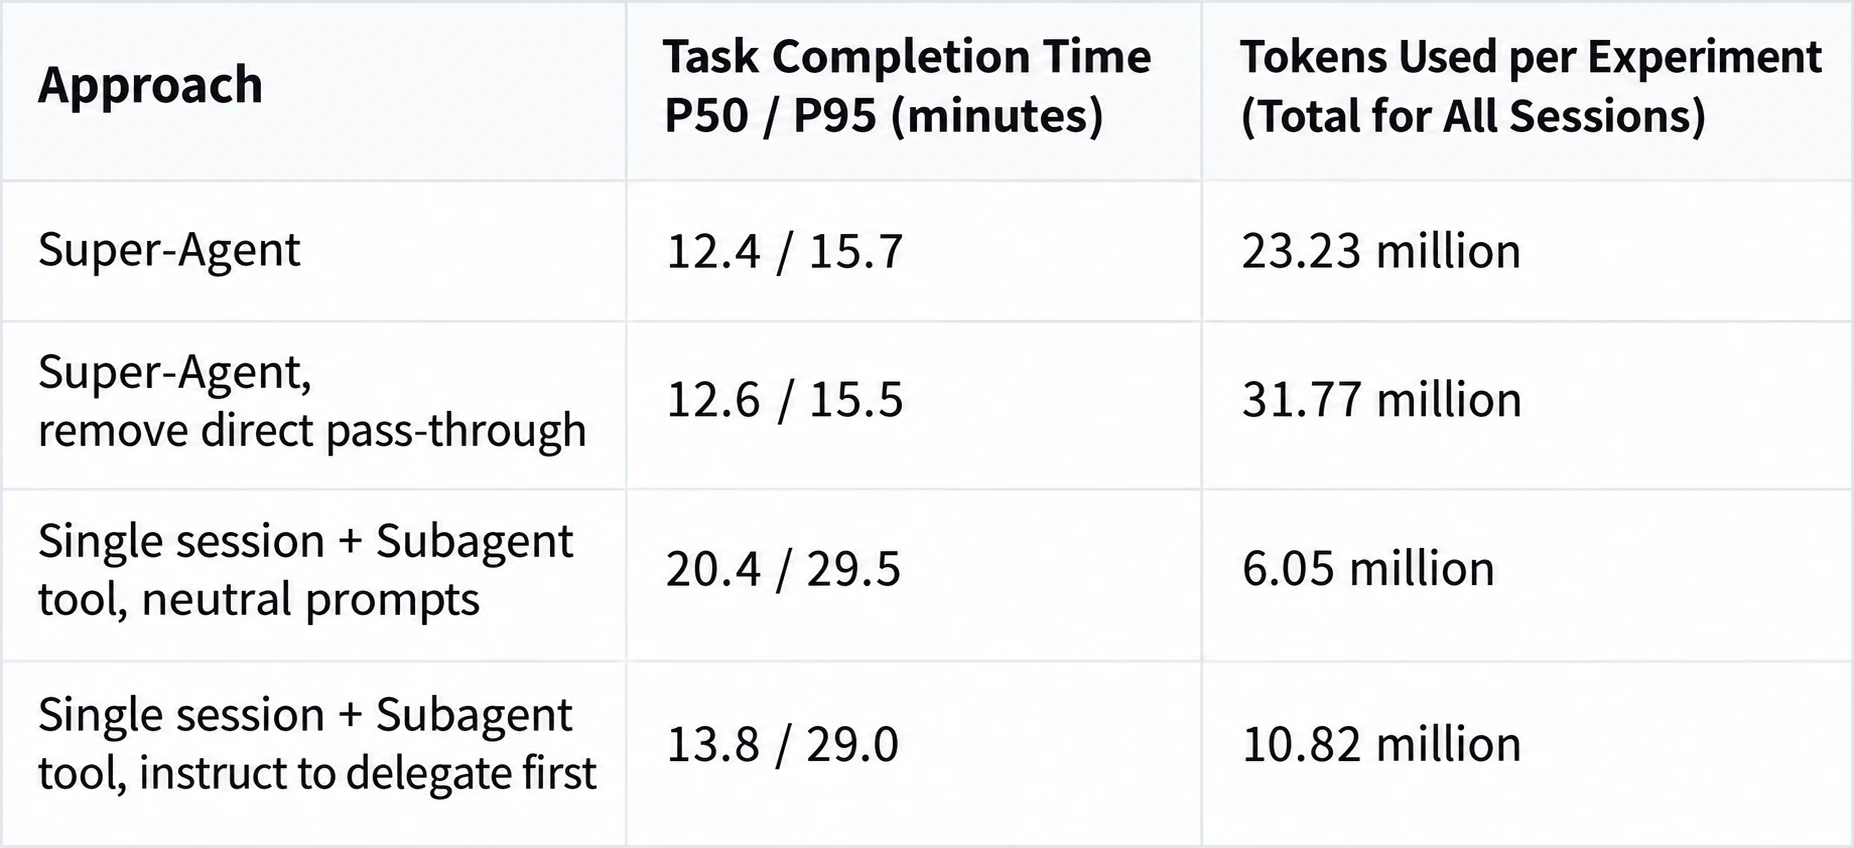
| 配置 | 完成时间 P50 | 完成时间 P95 | 每次运行的缓存读取 Token |
|---|---|---|---|
| Super Agent | 12.4 分钟 | 15.7 分钟 | 23.23M |
| Super Agent,关闭订阅直通 | 12.6 分钟 | 15.5 分钟 | 31.77M |
| 单会话加子 Agent,中性提示词 | 20.4 分钟 | 29.5 分钟 | 6.05M |
| 单会话加子 Agent,优先委派提示词 | 13.8 分钟 | 29.0 分钟 | 10.82M |
P50 是中位数;P95 反映任务完成时间较慢的一端。M 表示百万 Token。
有三个结果值得关注。
第一,基线如何组织工作,会明显影响比较结果。 相对中性提示词基线,Super Agent 的完成时间中位数减少约 39%;相对优先委派基线,只减少约 10%。中性基线在五次运行中从未调用子 Agent;优先委派基线在五次运行中的四次进行了委派。
这支持了一个具体的架构判断:分离协调和执行,可以减少对模型逐项决定“是否委派”的依赖。
第二,订阅直通主要减少额外开销。 关闭订阅直通后,完成时间变化不大,但缓存读取 Token 从 23.23M 增长到 31.77M,增加约 37%。反过来说,相对关闭直通的配置,启用直通减少了约 27% 的缓存读取量。
第三,更低的延迟伴随着更高的 Token 用量。 Super Agent 的缓存读取量约为中性基线的 3.8 倍、优先委派基线的 2.1 倍。缓存读取量不能直接换算成账单:总成本还取决于缓存读取价格、其他输入输出 Token,以及基础设施。
技术分析:任务状态、路由与执行
最有价值的实现选择,是把任务控制逻辑移出模型上下文。Ticket 记录任务和授权范围,Assignment 连接任务与执行,Engine 管理状态转换。已订阅线程上的事件直接到达对应 Worker,减少通过模型进行路由判断的次数。
这比 Router–Worker 的拓扑本身更有参考价值:程序机制处理任务归属和事件投递,模型处理语义判断和执行。具体实现见公开架构文档。
对协作而言,实际收益是任务不再只存在于某个人的记忆或聊天记录中。明确的记录让参与者切换会话后,任务关系仍然保留。
这种整合也增加了运行负担。长期运行的协调器、事件源、持久化状态、执行环境和授权策略,都需要维护。系统还需要可靠地判断:一个请求应该创建任务、更新已有任务,还是转交给人。
我们认为,Super Agent 是值得研究和借鉴的架构。任务状态、授权和事件路由机制可以分别复用。对于流程可预测、职责明确的任务,简单委派仍然是有用的比较基线。
DeepSeek Super Agent 的适用场景与限制
Super Agent 特别适合这样的团队:聊天、Issue 和 PR 持续产生请求,多个任务并行推进,人持续参与澄清和审核。
需要了解的实现边界包括:
- 公开原型面向较窄的工作流。 它围绕单个仓库、GitHub 和可选的飞书接入组织工作。完整文章还讨论了跨设备执行、云端运行和持续监督。
- 任务记录保存状态,内容准确性需要其他机制。 Ticket、Assignment 和事件记录,用于确定谁在处理什么工作。
- 独立工作目录主要分离任务文件和上下文。 Worker 使用运行服务的操作系统用户身份执行,可以访问该用户能够访问的文件。因此,部署文档建议使用只保存 Agent 凭证的专用操作系统账号,具体见部署指南。
- 并行执行增加了协调和审核工作。 多个 Worker 修改相关代码时,可能产生重复实现、合并冲突,或对需求形成不同理解。
原文的开放问题也反映了这些挑战。对 Router 分片可以提高吞吐量,同时削弱共享上下文。扩大参与者和执行设备的范围,需要进一步明确上下文、权限和凭证的边界。
如何开始:GitHub 仓库与安装
DeepSeek Super Agent GitHub 仓库提供源代码、SETUP.md 和部署指南。
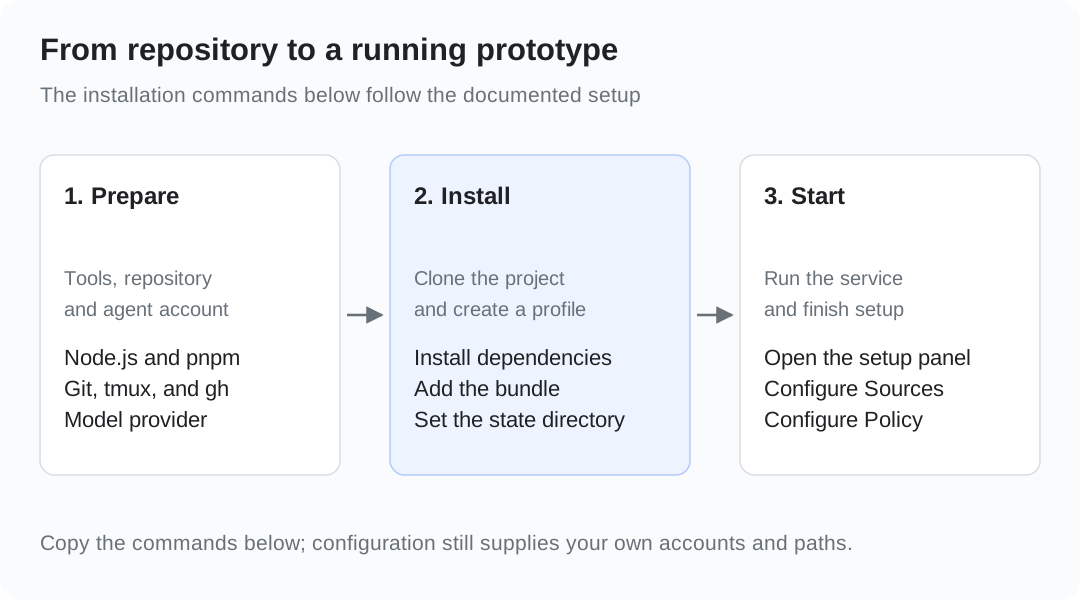
1. 运行要求
文档列出的要求包括:
- Node.js 22.19+ 或 24+,以及 pnpm。
- Git 2.32+、Python 3.8+ 和 tmux。
- GitHub CLI 2.48+。
- 已配置的模型服务。
- 一个目标 GitHub 仓库。
- Agent 专用的 GitHub 账号,以及规定谁可以交办工作的授权规则。
2. 克隆仓库,按照 SETUP.md 配置
克隆仓库:
git clone https://github.com/deepseek-ai/dsh-superagent-prototype.git dsh-superagent
cd dsh-superagent
随后可以让编码 Agent 按照仓库中的说明协助配置:
Read SETUP.md in this repository and set up dsh-superagent with me.配置过程会确定目标仓库、Agent 账号、获准交办任务的用户,以及模型服务。
3. 安装并运行 DeepSeek Super Agent
下面是文档中为新 profile 安装的命令。先检查是否已有同名 profile,避免覆盖现有配置。
npm install -g @deepseek-ai/dsh@0.2.1-rc.3 pnpm@11.7.0

pnpm install
pnpm build

dsh superagent --from-default-profile web --dump-config > /dev/null
dsh plugin --profile superagent add "link:$PWD"

cp examples/profile.cordis.patch.yml ~/.dsh/profiles/superagent/cordis.patch.yml
按照配置说明,将 stateDir 设置为准备使用的绝对路径,然后启动服务:
scripts/dsh-superagent start
scripts/dsh-superagent status
首次运行时,退出码 3 可能表示配置尚未完成。打开启动日志中显示的配置界面地址,设置模型、目标仓库、GitHub 身份、获准用户和工作目录。
DeepSeek Super Agent 常见问题
DeepSeek Super Agent 开源吗?免费吗?
公开原型使用 MIT 许可证。运行它需要模型推理和计算资源,因此会产生模型用量、基础设施和维护成本。
多个人可以向 Agent 交办任务吗?
可以。配置中的身份和授权规则决定谁可以交办及更新任务。
Super Agent 能主动执行自己发现的任务吗?
自动执行需要配置对应的授权规则。默认观察模式下,系统会识别并记录推断出的工作,不会执行。
Super Agent 是 DeepSeek 的新模型吗?
Super Agent 是运行在 DeepSeek Harness 上的系统架构,负责组织模型、工具、事件和执行会话。底层的理解、推理和代码生成仍由配置的模型完成。
参考资料
DeepSeek Super Agent 的原始技术文章以中文发布。阅读全文及原有配图: Super-agent 设计探索:迈向更自主的 Agent 系统