DeepSeek Super Agent(スーパーエージェント)は、DeepSeek Harness上で動くオープンソースの研究用プロトタイプです。チームのワークフローで複数のエージェントをどう協調させるかを探ります。複数の人がタスクを依頼して更新情報を伝え、システムが複数のAIエージェントにまたがる作業を整理します。
DeepSeek Harnessチームは、設計とあわせて、動作するプロトタイプをGitHubで公開しています。研究用プロトタイプという形での公開は、チームがさまざまなアーキテクチャや用途を検討している表れかもしれない、と私たちは考えています。今後も、そうした方向性を具体化するオープンソースのプロトタイプが公開されると予想しています。
元の技術記事は中国語で公開されました。原文の図を含む日本語訳全文を掲載しています。設計と実験結果の全体を確認するには、図付きの日本語訳全文をご覧ください。
概要
| 疑問 | 要点 |
|---|---|
| どのようなものか? | 複数の人、タスク、AIエージェントの協調を支えるシステム設計です。DeepSeek Harnessを基盤とするMITライセンスの研究用プロトタイプも公開されています。 |
| 何ができるか? | チームメンバーがそれぞれタスクを依頼し、追加の指示を出せます。システムがエージェント間の調整を行い、手作業によるタスクの割り当て、コンテキストの共有、進捗確認を減らします。 |
| 基本となる構成は? | Routerが依頼をタスクに関連付け、作業を振り分けます。Workerは個々のタスクを実行します。タスク記録とスレッドの購読により、後から届くイベントが進行中の作業につながります。 |
| 公開プロトタイプの対象は? | 単一のGitHubリポジトリでのコーディング作業です。GitHubと連携し、必要に応じてFeishuとも連携します。 |
| 必要なものは? | 互換性のあるDeepSeek Harness、モデルプロバイダー、ホストマシン、対象リポジトリ、エージェント専用のGitHubアカウントが必要です。 |
| ベンチマークから何がわかるか? | 合成ワークロードでは、タスク完了時間の中央値が中立的なプロンプトを使うベースライン比で約39%、委譲を優先するベースライン比で約10%短縮されました。一方、キャッシュ読み取りトークン数は増えています。 |
| 主な制約は? | 公開コードは研究用プロトタイプで、環境と権限の設定が必要です。実験ではコーディングを模擬的な遅延に置き換えており、評価対象はスケジューリングの挙動です。コードの品質、人によるレビュー、長期的な保守コストは測定していません。 |
DeepSeek Super Agentの技術分析:統合の価値と設計上のトレードオフ
私たちは、アーキテクチャの新規性よりも、各要素を統合した点に価値を感じています。RouterとWorkerの分離、イベント駆動の実行、永続的なタスク記録、バックグラウンドジョブは、いずれも確立された設計手法を基盤としています。Offloopでも、半年以上にわたり類似の仕組みや設計パターンを使ってきました。Super Agentで注目したいのは、これらを開発者が調べ、実行し、議論できるオープンソースのシステムとしてまとめた点です。
特に参考になるのはタスク管理です。複数の人が依頼し、情報を追加し、結果をレビューする中で、明示的な記録とプログラム上のルールが担当、認可、実行状態を追跡します。スレッドの購読は、その後のメッセージを適切なWorkerに届けます。エージェントの数を増やすだけでは得られない、実装上の知見があります。
公開実験では、各構成を5回ずつ実行しています。委譲を優先するベースラインと比べ、Super Agentは完了時間の中央値を約10%短縮する一方、キャッシュ読み取りトークン数は約2.1倍になっています。Offloopの開発経験から、複数の人が関わり、複数のタスクが並行するワークフローには、理論上の効率改善が見込めると考えています。担当とイベントの配送先を明確にすることで、調整の繰り返し、コンテキストの引き継ぎ、実行の中断を減らせるためです。今後、実際のチームの作業で検証し、タスクの検収、レビューと手戻りにかかる時間、調整の手間、総コストを測定する予定です。
DeepSeek Super Agentとは?
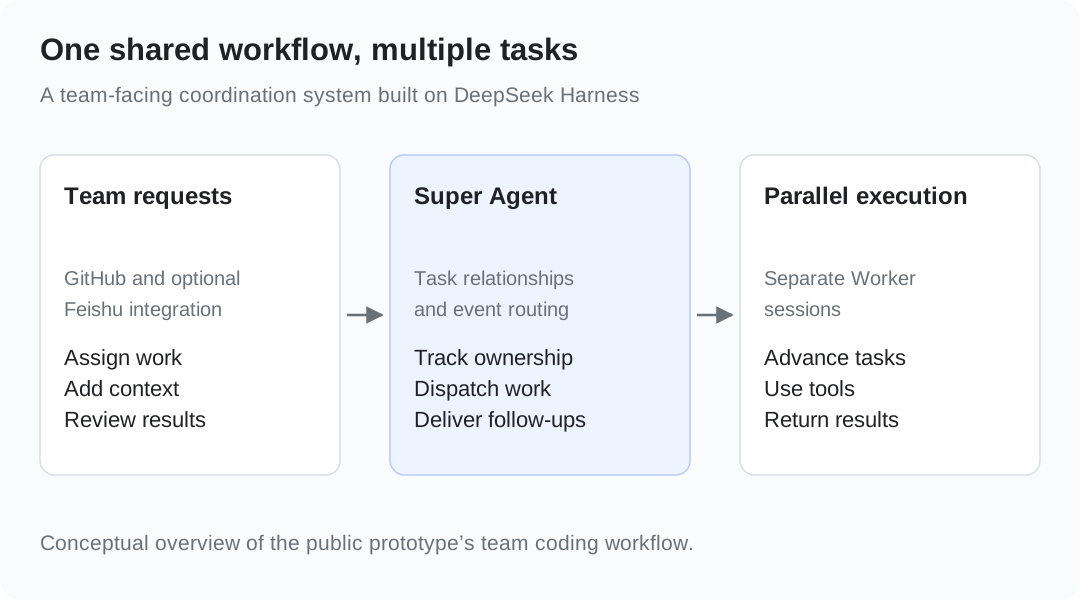
DeepSeek Super Agentは、継続的な協働のためのシステム設計です。チームメンバーが依頼し、コンテキストを追加し、結果をレビューします。システムは、その入力を進行中のタスクに関連付け、複数の実行セッションを調整して作業を進めます。
中心となる問いは、複数の人が複数のAIエージェントとどう協働するかです。
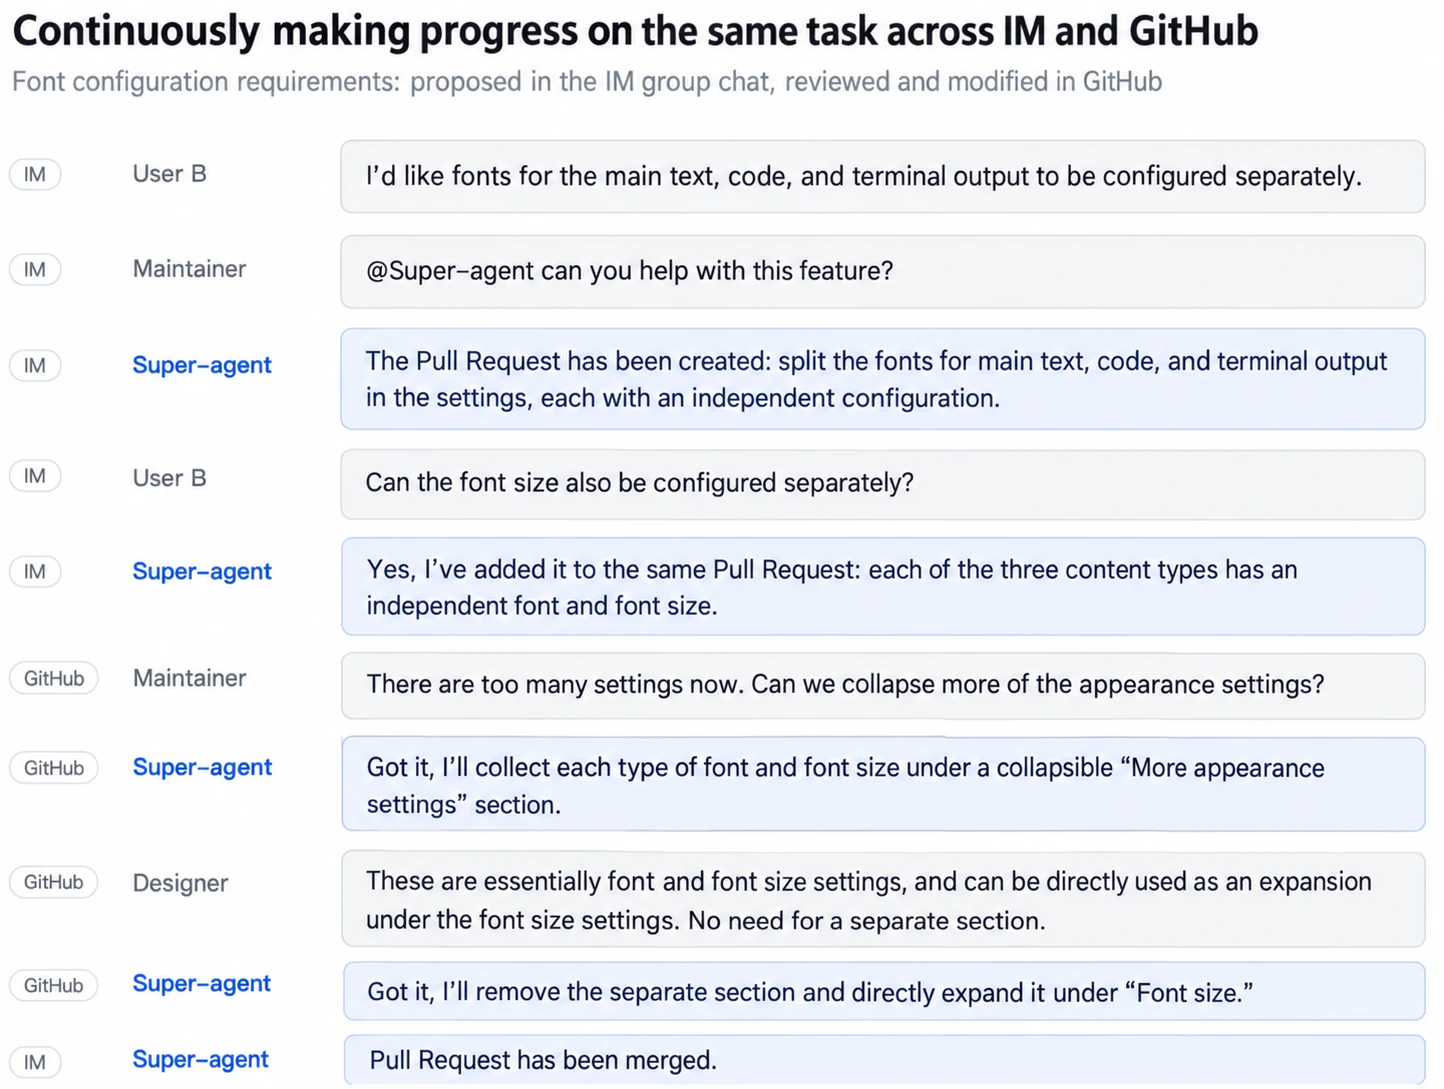
たとえば、同僚がチャットで依頼し、開発者がGitHub Issueに再現手順を追記し、その後レビュアーがプルリクエストで変更を求める場面です。これらの入力は、異なる経路から異なる時刻に届きますが、同じ作業に関係しています。システムには、入力を関連付け、適切な実行主体に届け、タスクの進捗と範囲を維持する役割があります。
Super AgentはDeepSeek Harness上で動作します。Harnessがツール実行やエージェントセッションなどの基盤を提供し、Super Agentがその上でタスク、イベント、複数エージェントの協調を管理します。
DeepSeek Super Agentが設計された理由
モデルが個々のタスクをこなす能力を高めても、チームには、人や並行作業をまたぐ依頼、コンテキスト、進捗の調整が残ります。DeepSeek Super Agentは、その調整をより多くシステムに担わせるための設計です。
チームが次の3件を並行して処理する場面を考えます。
- プロダクトマネージャーがFeishuで機能追加を依頼する。
- 開発者がGitHubでテストの失敗を報告する。
- レビュアーが既存のプルリクエストに変更を求める。
その間、一部のエージェントはタスクを実行し、別のエージェントは外部の結果や人の判断を待っています。
調整では、同じような問いが繰り返されます。新しいメッセージは既存のタスクに属するのか、新規のタスクなのか。担当は誰か。別のエージェントがすでに対応していないか。追加情報はどこに送るべきか。誰による確認、認可、レビューが必要か。
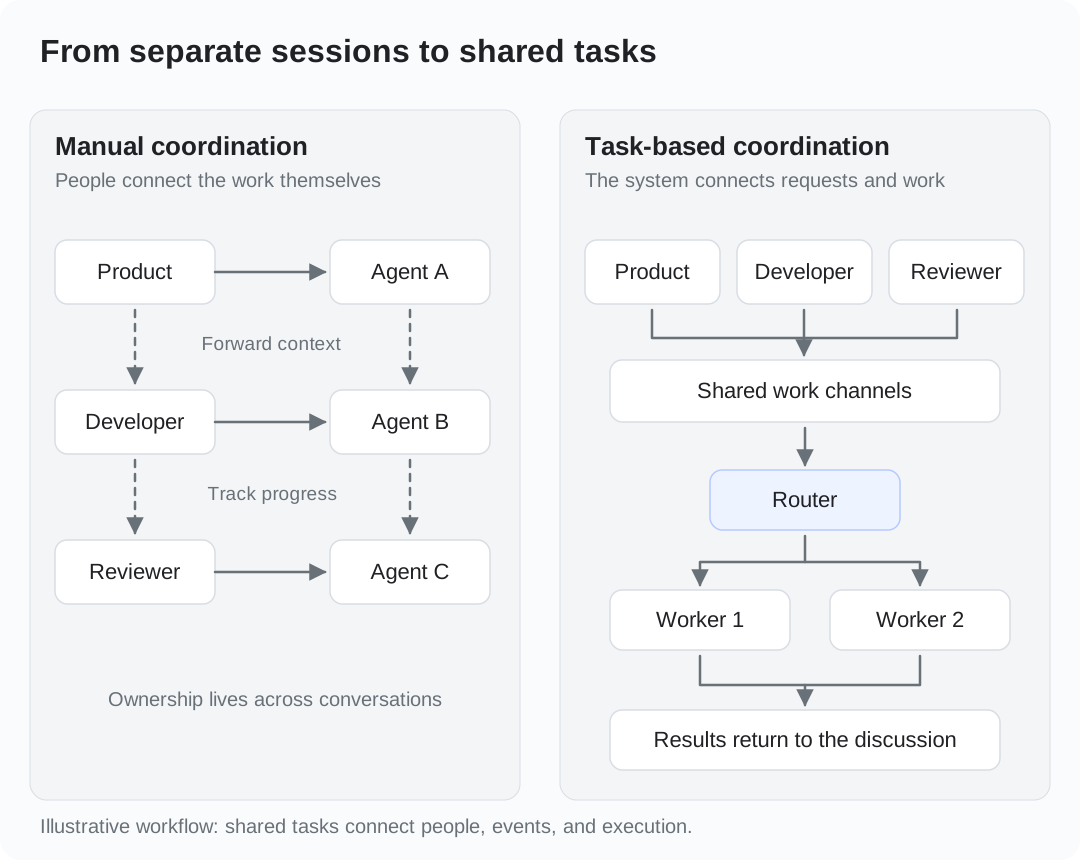
こうした関係を人が手作業で管理すると、会話を探し、コンテキストを転送し、進捗を尋ねる時間がかかります。一方、すべてを一つのセッションに入れると、無関係なタスクのコンテキストが混ざり、新着メッセージが進行中の作業を中断する問題が生じます。
Super Agentは、タスク間の関係を維持する調整層と、作業を進める個別の実行セッションを組み合わせます。チームメンバーは使い慣れた経路を引き続き利用できます。原文の人を中心とした対話の節では、実行中も人が関わり続け、異なる経路からエージェントとやり取りする方法を説明しています。
この方向性はOffloopの設計とよく重なります。DeepSeekの技術記事の著者は、私たちの開発チームとも意見を交換しています。そうした対話とOffloopの開発経験を通じて、このアーキテクチャの目的とトレードオフをより深く理解できました。
また、Offloopを試すこともできます。私たちは、複数の人とエージェントによるこのような協働を実装し、現在は社内で検証しています。Slackのような協働スペースでAIのチームメンバーと働くイメージです。人がタスクを依頼し、コンテキストを提供し、進捗を追います。エージェントは作業を分担し、結果を議論に戻します。
DeepSeek Super Agentの仕組み:Router–Workerアーキテクチャ
Router–Worker構成でタスクを割り当てる仕組み
Super Agentは、Router–Workerの2層構成を採用しています。
Routerは、タスク間の関係を維持します。届いた依頼から新しいタスクを作るのか、既存のタスクに関連付けるのか、既存の実行主体に届けるのかを判断します。Workerは、それぞれの実行コンテキストで個々のタスクを処理し、必要に応じてサブエージェントも使えます。
これにより、調整と実行を分離します。あるWorkerがコードを変更している間に、別のWorkerが独立した依頼に対応できます。最初のタスクへの追加指示は、そのタスクに関連付けたまま扱えます。
原文では、Routerを調整に集中させるため、実行ツールを制限する案を示しています。たとえば、Bashを与えない設計です。
公開プロトタイプは異なる方式を採用しています。RouterにはBashなどのツールを残しつつ、ツールの種類を絞り、シェルの待機時間の上限を短くし、コードの直接調査や実装を控えるようプロンプトで指示しています。
実装の詳細は、公開プロトタイプのアーキテクチャ文書を参照してください。
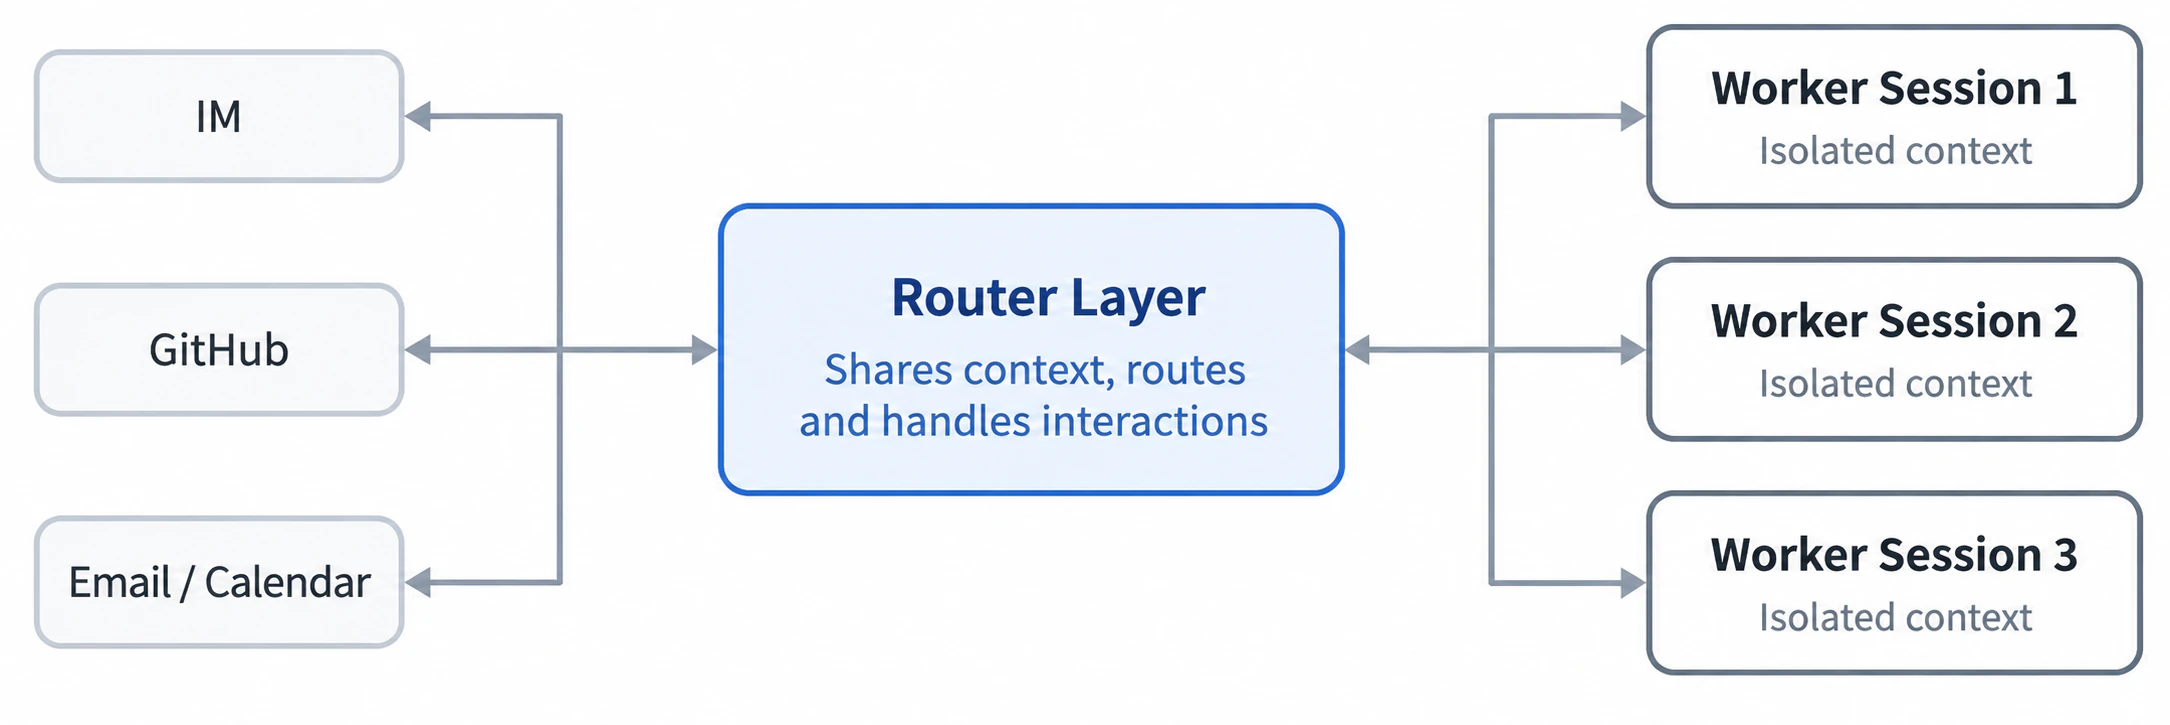
元の構成図は、日本語訳全文の第2節で確認できます。
イベント駆動のタスクオーケストレーションとスレッドの購読
Super Agentのイベント駆動アーキテクチャは、新しい依頼や後続イベントを進行中の作業に関連付けます。タスクオーケストレーションには、タスクの作成、実行セッションの関連付け、到着した更新情報の配送が含まれます。
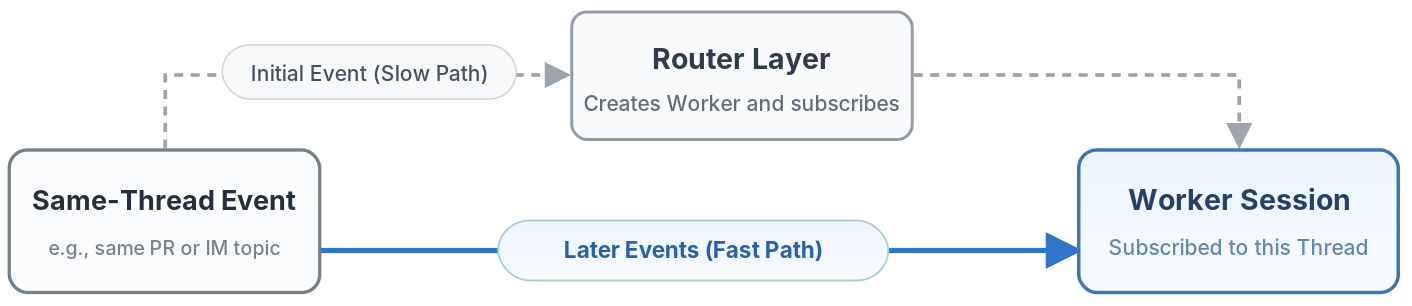
チームでのコーディング作業を例に考えます。
権限を持つ同僚がテストの失敗を報告します。システムは依頼を認識し、タスクとその認可記録を作成して、実行を担当するWorkerを関連付けます。
別の同僚が同じIssueにログを追加します。そのスレッドはすでにタスクの購読対象なので、追加情報を該当するWorkerに届けられます。
3人目の同僚が、無関係なドキュメント変更を依頼します。これは別のWorkerが扱う独立したタスクにでき、二つのコンテキストを分けておけます。
その後、プルリクエストのレビューやCIの結果もイベントとして届きます。新しい依頼がタスクの認可範囲を超える場合は、追加メッセージだけを根拠に権限を広げず、改めて評価する必要があります。
実装には、次の三つの中心的な概念があります。
| 概念 | 役割 |
|---|---|
| Ticket | タスクと、その認可範囲を記録します。 |
| Assignment | タスクを特定の実行に関連付けます。 |
| スレッドの購読 | 後続のメッセージやイベントを該当する実行主体に届け、ルーティングの繰り返しを減らします。 |
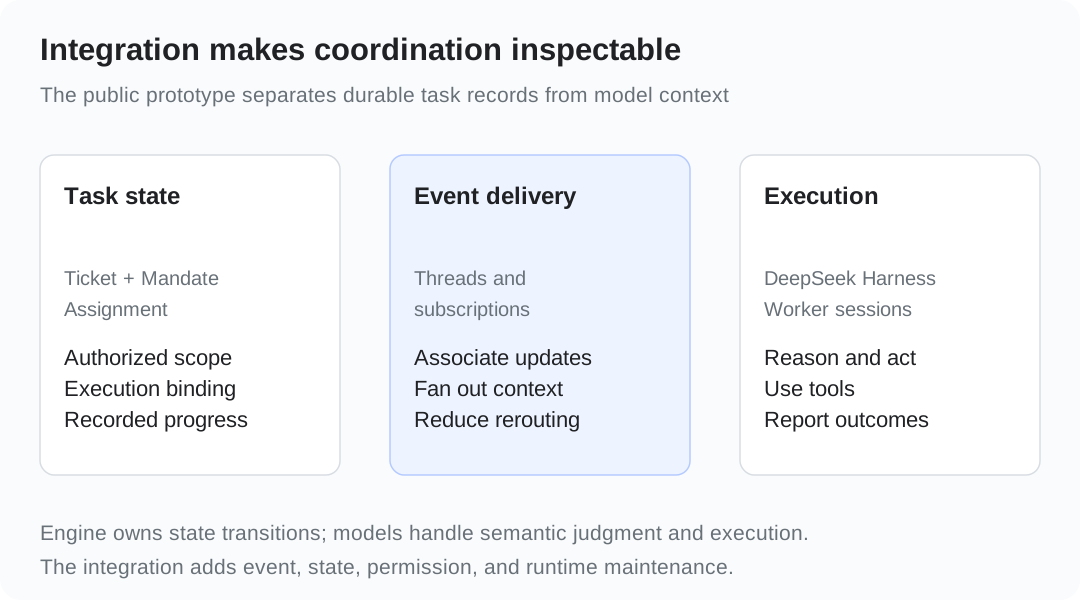
最初の依頼でタスクとの関係を設定し、その後は購読によってイベントをWorkerに直接届けます。原文のイベント駆動設計の節では、この流れを支えるフィルタリング、ルーティング、コンテキストの整理を説明しています。
タスクの認可:どの依頼が実行につながるか
受付ルールが最初に送信元と身元を確認し、その後モデルが内容とタスクの関係を評価します。Issueのコメント、ログ、CIの結果はコンテキストを提供できますが、それ自体が実行権限を与えるわけではありません。
公開プロトタイプでは、認可に関していくつかのケースを分けています。
- 既定の観測モードでは、推定した作業を認識して記録できますが、自動的には実行しません。
- 明示的な依頼は、関連ルールを満たす場合に実行を開始できます。
- 自動実行には認可ルールの設定が必要です。
これらの仕組みが、観測したメッセージをどのように認可済みの作業にするかを決めます。詳しくは、プロトタイプの認可設計を参照してください。
コンテキスト管理、バックグラウンド実行、永続化
常時稼働するエージェントには、コンテキストのサイズを制御する仕組みが必要です。
Super Agentは、タスクとイベントを軸にコンテキストを整理します。必要な要約と参照を現在のコンテキストに保持し、長い内容は必要に応じて取得します。タスク、スレッド、イベントの関係をたどって履歴を呼び出します。この構造により、コンテキストのサイズを制御し、同じ入力の繰り返しを減らし、過去の情報も参照できるようにします。
長期記憶には、さらに別の問題があります。古い結論をいつ無効にするか、矛盾する情報をどう整合させるか、要約から重要な条件が抜け落ちないか、過去の記録が現在の事実を反映しているか、といった点です。記事では、これらに特化した仕組みまでは詳述していません。
時間のかかる処理も、到着する対話から切り離します。作業はバックグラウンドで続き、完了時には新たなイベントが届きます。そのため、実行中もシステムは追加の入力を受け取れます。
原文は、さらに計算、状態、実行環境の分離を提案しています。Agent Loopはクラウドで動き、永続的な状態は別に保存され、実行端末は軽量なデーモンを通じてコマンドを受け取ります。これにより、エージェントを動かす計算資源を、コード、依存関係、認証情報を持つマシンとは独立して管理できます。
公開プロトタイプのデプロイ文書は、これらをまとめた配置を説明しています。tmuxでDeepSeek Harnessを起動し、設定した状態ディレクトリにデータベースを保存し、実行マシン上にタスクの作業ディレクトリを用意する構成です。
原文のWatchdogは、タスクの進捗も評価します。独立したエージェントセッションが、Workerの作業が停滞していないか、目標から逸脱していないかを確認します。一方、公開デプロイ文書にある状態確認や再起動の手順は、主にプロセス、設定、ランタイムのエラーを対象としています。サービスの再起動と、タスクが実質的に前進しているかの評価は、異なる機能です。
公開リポジトリのREADMEには、公開コードはリリース用に調整されており、内部実装や記事に記載されたアーキテクチャとは異なること、一部の設計は今後の検討対象であることが説明されています。
DeepSeek Super Agentとサブエージェントの違い:タスクの調整
どちらの方式でも並列に作業できます。主な違いは、誰がタスクを整理するか、進行中の作業に後続メッセージをどう届けるかです。
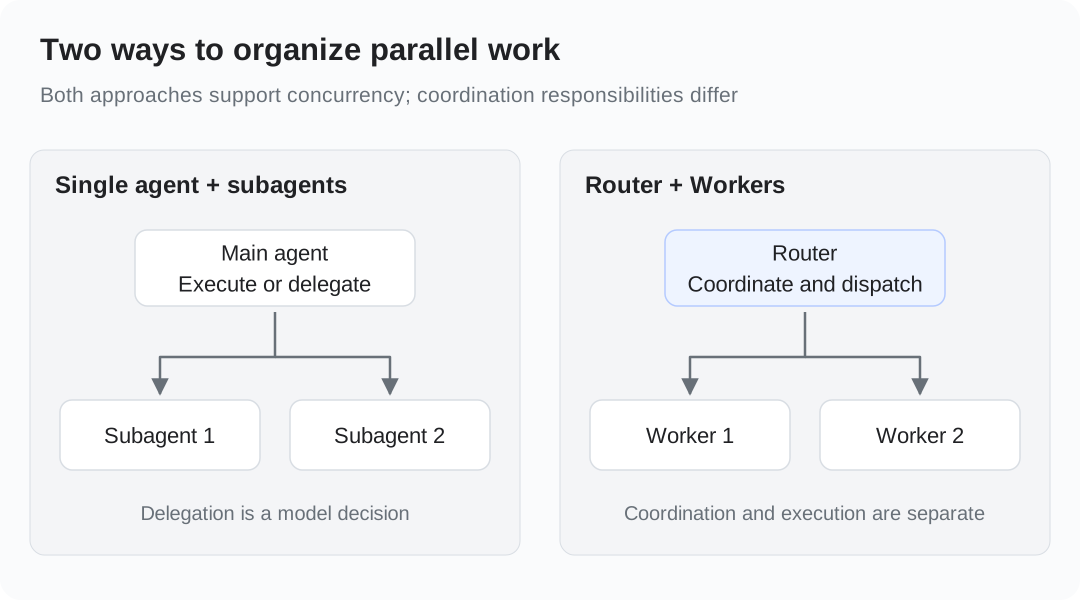
| 比較項目 | サブエージェントを使う単一エージェント | Super Agent |
|---|---|---|
| 調整 | 主エージェントが実行中に委譲のタイミングを判断します。 | RouterとWorkerの役割をアーキテクチャで分離します。 |
| 並列作業 | 複数のサブエージェントが委譲されたサブタスクを処理できます。 | 別々のWorkerが独立したタスクを進められます。 |
| 後続メッセージ | メインセッション、または別の仕組みで更新を進行中の作業に関連付けます。 | タスク間の関係とスレッドの購読によって、更新を実行主体に関連付けます。 |
| 継続的な協働 | 製品の状態管理やセッション管理に依存します。 | 永続的なタスク、イベントの配送、タスクをまたぐ調整が設計の中心です。 |
| 複雑なタスク | 主エージェントが直接実行することも、委譲することもできます。 | Worker自身もサブエージェントを使い、実行をさらに分担できます。 |
Super Agentの価値は、エージェントの数だけにあるわけではありません。注目したいのは、個々の作業を委譲するかどうかの判断を、その都度モデルに任せる度合いをどう減らすか、実行中も続く入力をどう扱うかです。原文の2層アーキテクチャの節で、この違いを詳しく説明しています。
DeepSeek Super AgentとClaude Code・Codexの比較
DeepSeek Super Agentは、アーキテクチャの検討と検証のためのオープンソースの研究用プロトタイプです。Claude CodeとCodexは、ユーザー向けに提供・保守される製品です。前者は複数の人とエージェントによるシステムをどう設計するか、後者は現在利用できる製品でどう作業を進めるか、という異なる問いに応えています。
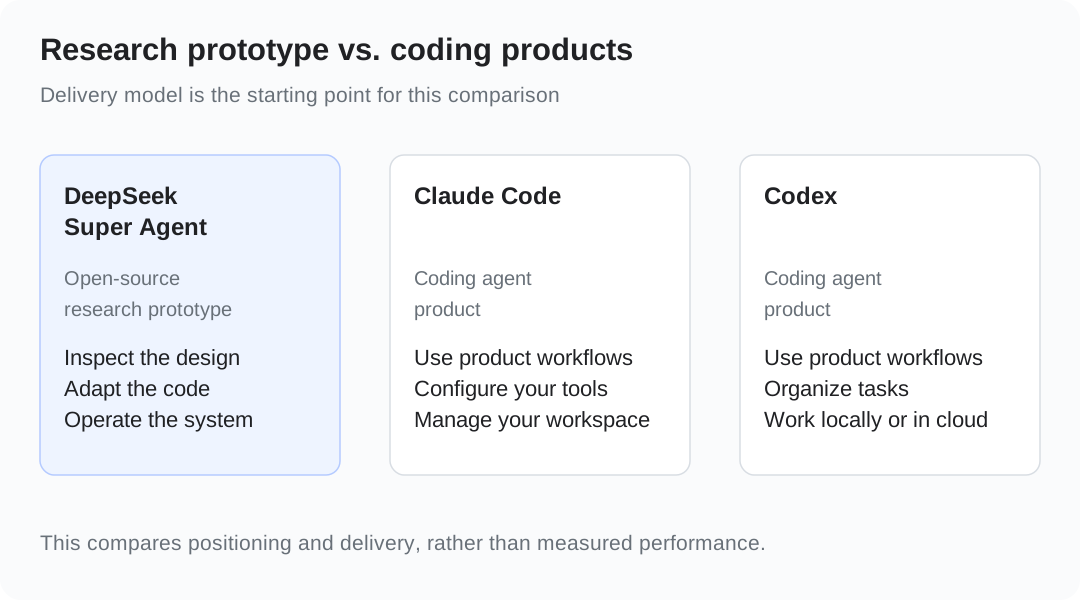
| 比較項目 | DeepSeek Super Agent | Claude Code | Codex |
|---|---|---|---|
| 位置付けと提供形態 | ソースコードとアーキテクチャ文書を公開した研究用プロトタイプ。 | コーディングエージェント製品。 | コーディングエージェント製品。 |
| 主な価値 | タスク調整、認可、イベントルーティングの仕組みを調査、変更、再利用できます。 | コーディング、ツール利用、サブエージェントのためのワークフローをすぐに使えます。 | タスク、スレッド、ワークスペースを通じて、ローカルとクラウドのコーディング作業を整理できます。 |
| 協働の対象 | 複数の人が継続的にタスクを依頼・更新し、RouterとWorkerの役割分担によって調整します。 | 主エージェント、サブエージェント、実験的なAgent Teamsを使ったコーディングのワークフロー。 | 独立したタスクとスレッドを軸に整理された並列作業。 |
| 使い始めるには | プロトタイプをデプロイし、モデル、アカウント、権限、実行環境を設定します。 | 製品をインストール・設定し、提供されるインターフェースから利用します。 | アプリ、CLI、IDE連携、クラウドタスクから利用します。 |
| 保守 | ユーザーがプロトタイプと周辺環境を保守します。 | 製品の主要機能は提供元が保守し、設定や開発環境はユーザーが管理します。 | 製品の主要機能は提供元が保守し、設定や開発環境はユーザーが管理します。 |
参考資料:Claude Codeのドキュメント、Agent Teamsのドキュメント、Codexのサブエージェントのドキュメント、Codexのクラウドのドキュメント。
DeepSeek Super AgentとGrok Bot・Museの比較
Grok BotやMuseも、継続的な作業、マルチタスク、パーソナルアシスタントの体験を製品として提供しています。Super Agentの特徴的な貢献は、開発者が調べて変更できるシステム設計と実装を公開した点にあります。
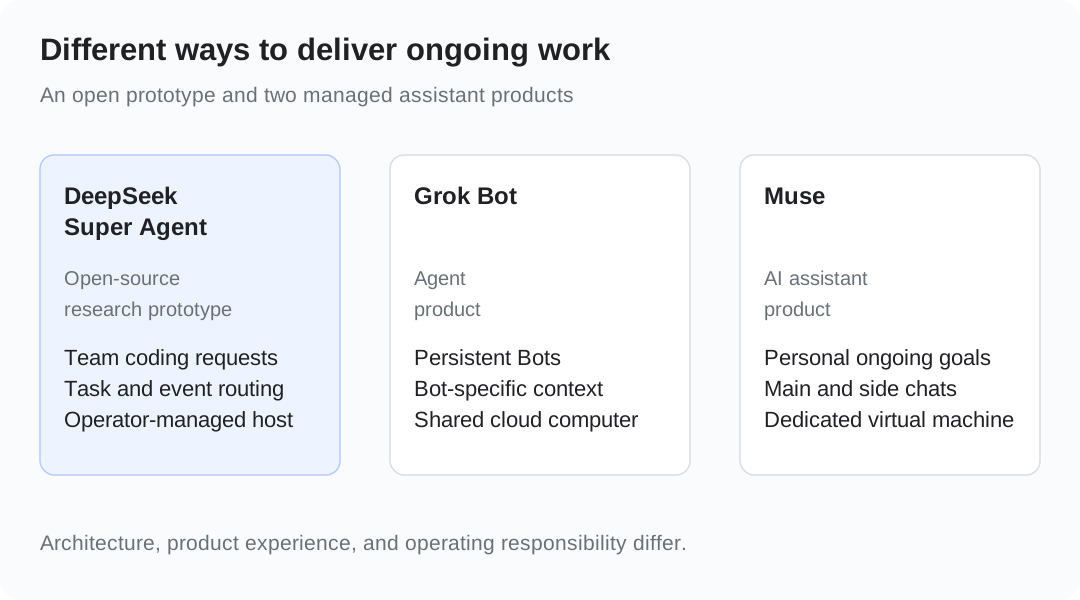
| 比較項目 | DeepSeek Super Agent | Grok Bot | Muse |
|---|---|---|---|
| 位置付けと提供形態 | オープンソースの研究用プロトタイプ。 | エージェント製品。 | AIアシスタント製品。 |
| 主な対象 | 複数の人、タスク、実行主体の調整。 | 継続的なタスクやコンテキストを、別々のBotを軸に整理します。 | 個人のマルチタスクと継続的なアシスタント体験。 |
| 作業の整理方法 | Router、Worker、タスク記録、イベントの購読。 | 別々のBotが各自のコンテキストを維持し、共通のリソースを使います。 | メインの会話とサイドの会話で作業を整理します。 |
| コンテキストと記憶 | タスクとイベントを軸にコンテキストを整理し、状態を永続化します。 | Botごとに作業のコンテキストを整理します。 | ユーザーが確認・編集できる永続的な記憶。 |
| 実行環境 | ユーザーがホストマシンとリポジトリを設定します。 | 同じアカウントのBotが、永続的なクラウドコンピューターを共有します。 | 専用の仮想マシンが、ブラウザー、ファイル、ターミナルの機能を提供します。 |
| 開発者が利用できる資料 | ソースコード、アーキテクチャ文書、実験設計。 | 製品機能と公開ドキュメント。 | 製品機能、公開の紹介資料、研究の解説。 |
DeepSeek Super Agentのベンチマーク:遅延とトークン使用量
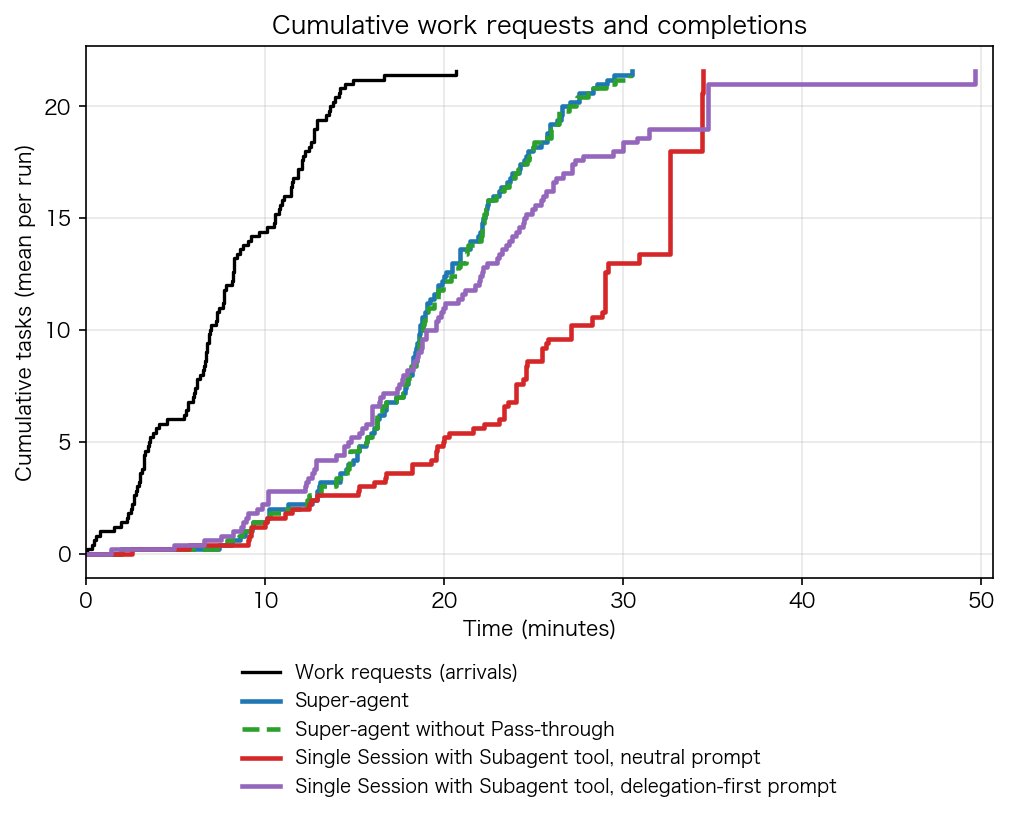
原文の初期実験では、約300件のメッセージを使っており、そのうち作業依頼は約20件です。残りは雑談、追加の指示、停止依頼、CIの通知などです。
各構成を5回ずつ実行しています。実際のコーディングはツールの模擬的な遅延に置き換えているため、測定対象はスケジューリングと調整の挙動です。生成コードの品質、人によるレビュー、手戻りの時間は評価していません。
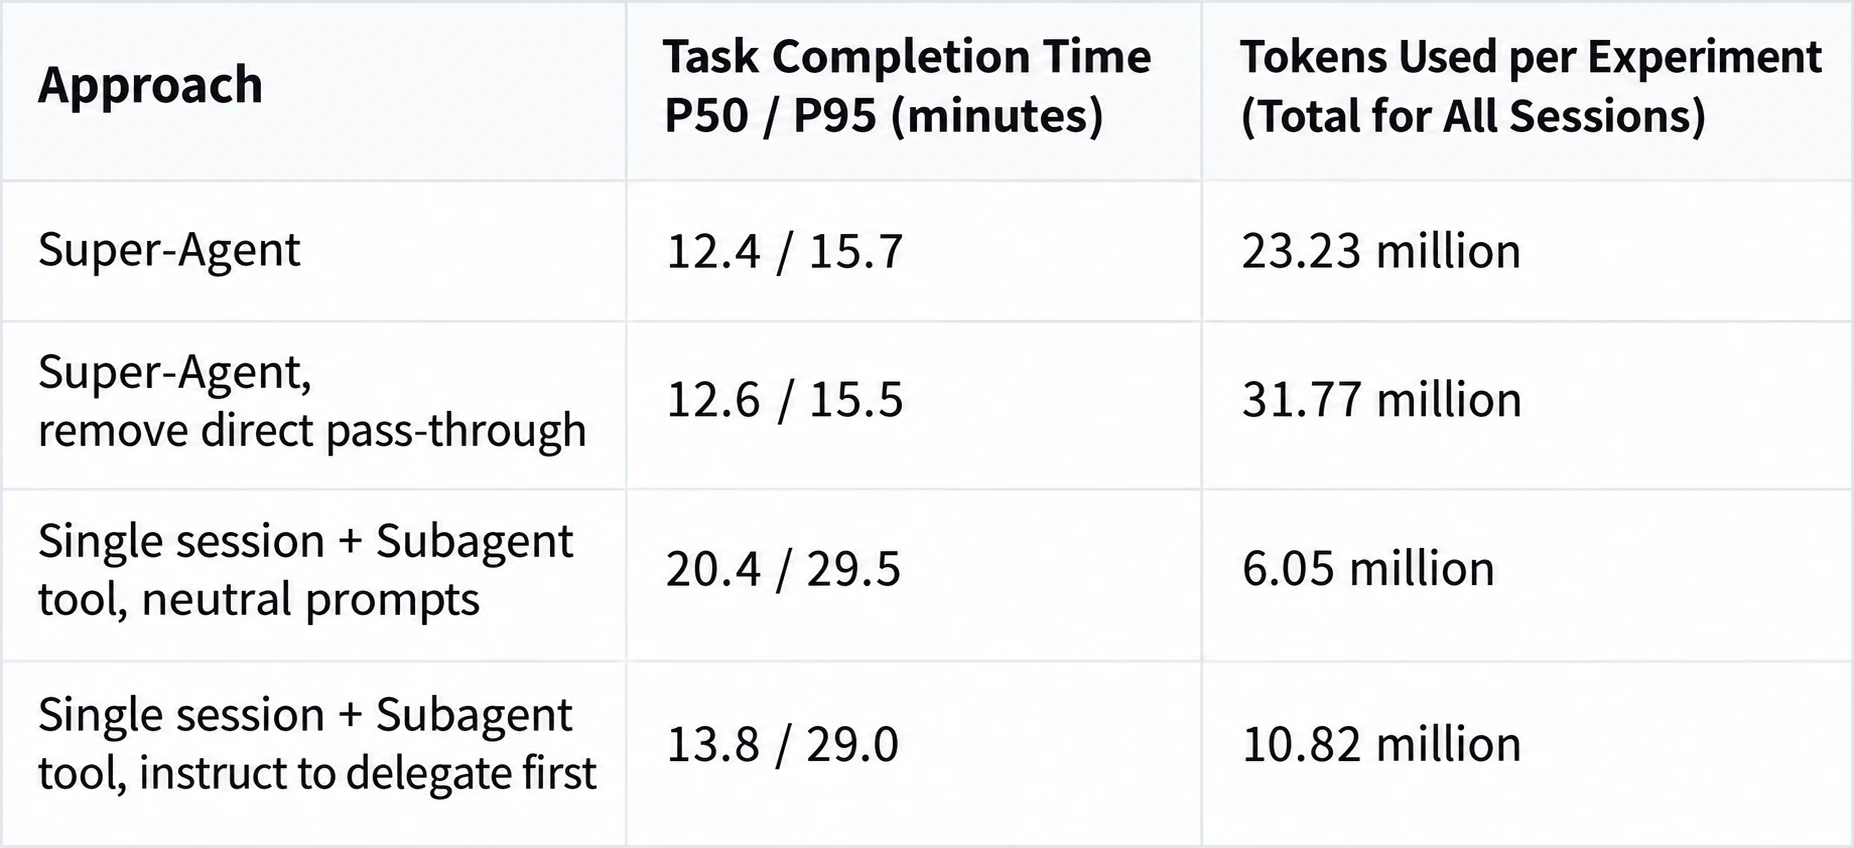
| 構成 | 完了時間 P50 | 完了時間 P95 | 1回の実行当たりのキャッシュ読み取りトークン数 |
|---|---|---|---|
| Super Agent | 12.4分 | 15.7分 | 23.23M |
| 購読イベントの直接配送なしのSuper Agent | 12.6分 | 15.5分 | 31.77M |
| 単一セッション+サブエージェント、中立的なプロンプト | 20.4分 | 29.5分 | 6.05M |
| 単一セッション+サブエージェント、委譲優先のプロンプト | 13.8分 | 29.0分 | 10.82M |
P50は中央値、P95は完了までに時間がかかる側の傾向を示す95パーセンタイルです。Mは100万トークンを表します。
注目したい結果は三つあります。
第一に、ベースラインの調整方法によって比較結果が大きく変わります。Super Agentの完了時間の中央値は、中立的なプロンプトのベースライン比で約39%、委譲優先のベースライン比では約10%短くなっています。中立的なベースラインは5回ともサブエージェントを呼び出さず、委譲優先のベースラインは5回中4回で委譲しました。
この結果は、調整と実行を分離することで、作業を委譲するかどうかをモデルがその都度判断する仕組みへの依存を減らせる、という具体的な設計上の主張を支えています。
第二に、購読イベントの直接配送は、主にオーバーヘッドを減らします。これを外しても完了時間はおおむね同じですが、キャッシュ読み取りトークン数は23.23Mから31.77Mへと約37%増えます。逆に、直接配送を有効にすると、無効な場合に比べてキャッシュ読み取り量を約27%減らせます。
第三に、遅延の短縮にはトークン使用量の増加が伴います。Super Agentのキャッシュ読み取りトークン数は、中立的なベースラインの約3.8倍、委譲優先のベースラインの約2.1倍です。キャッシュ読み取り量がそのまま請求額になるわけではありません。総コストは、キャッシュ読み取りの単価、その他の入力・出力トークン、インフラにも左右されます。
技術分析:タスクの状態、ルーティング、実行
実装で特に重要なのは、タスクの制御をモデルのコンテキストの外に置いた点です。Ticketがタスクと認可範囲を記録し、Assignmentがタスクと実行を結び付け、Engineが状態遷移を管理します。購読済みスレッドのイベントは該当するWorkerに直接届き、モデルによるルーティング判断を減らします。
Router–Workerという構成そのものより、この役割分担が参考になります。タスクの担当とイベントの配送はプログラムで管理し、意味の判断と実行はモデルが担います。詳しくは、公開アーキテクチャ文書を参照してください。
協働における実用上の利点は、タスクが誰かの記憶や会話ログの中だけに存在しなくなることです。参加者がセッションを切り替えても、明示的な記録がタスクの関係を保持します。
一方、この統合は運用の負担も増やします。常時稼働する調整役、イベントソース、永続的な状態、実行環境、認可ポリシーは、いずれも保守が必要です。新しい依頼からタスクを作るのか、既存タスクを更新するのか、人の入力を求めるのかを、引き続き適切に判断しなければなりません。
Super Agentは、学び、取り入れる価値のあるアーキテクチャだと考えています。タスクの状態管理、認可、イベントルーティングの仕組みは、それぞれ単独でも役立ちます。手順を予測しやすく、責任の範囲が明確なタスクでは、より単純な委譲方式も有用なベースラインです。
DeepSeek Super Agentの用途と制約
Super Agentは、チャット、Issues、プルリクエストから依頼が継続的に届き、複数のタスクが並行し、人が確認やレビューに関わり続けるチームに特に関係する設計です。
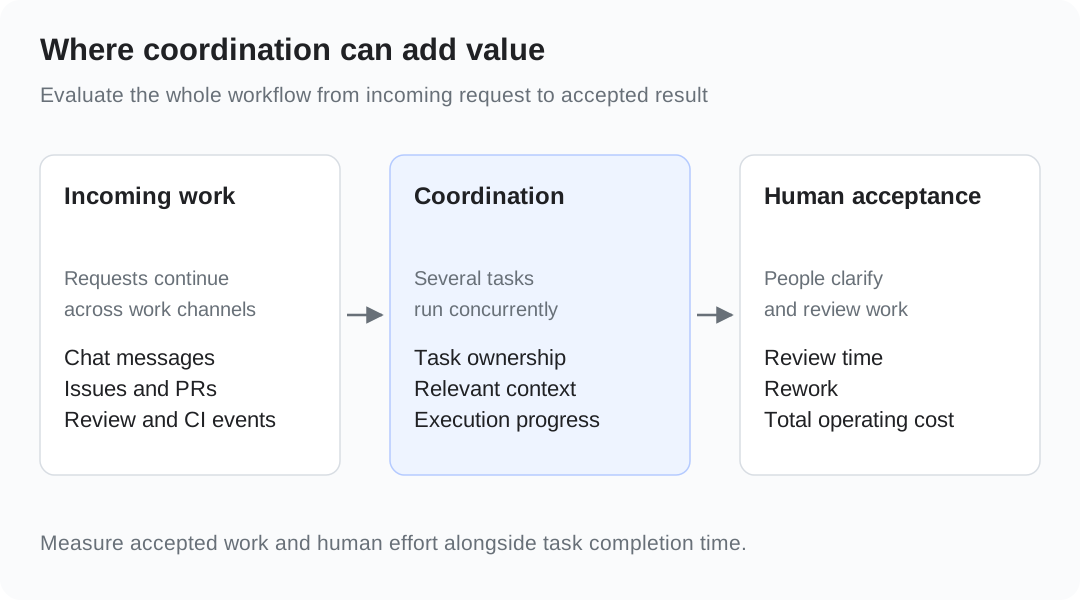
主な制約は次のとおりです。
- 公開プロトタイプの対象は限定されています。単一のリポジトリ、GitHub、任意のFeishu連携を軸に作業を整理します。原文の記事は、さらに広く、複数端末での実行、クラウドでの稼働、継続的な監督についても論じています。
- タスク記録は状態を保持しますが、内容の正確さには別の仕組みが必要です。Ticket、Assignment、イベント記録は、誰が何をしているかを把握するのに役立ちます。
- 個別の作業ディレクトリが主に分けるのは、タスクのファイルとコンテキストです。Workerは、サービスを動かすOSユーザーとして実行され、そのユーザーが参照できるファイルにアクセスできます。そのため、デプロイ文書は、エージェントの認証情報だけを持つ専用OSアカウントを推奨しています。詳しくは、デプロイガイドを参照してください。
- 並列実行では、調整やレビューの作業も増えます。関連するコードを複数のWorkerが変更すると、重複実装、マージ競合、解釈の不一致が生じることがあります。
原文の未解決の課題にも、こうした問題が表れています。Routerを分割すれば処理能力は増やせますが、共有コンテキストが弱くなる可能性があります。参加者や実行端末を増やすには、コンテキスト、権限、認証情報の境界をより明確にする必要があります。
DeepSeek Super Agentの導入:GitHubリポジトリとインストール
公開されているDeepSeek Super AgentのGitHubリポジトリには、ソースコード、SETUP.md、デプロイガイドが含まれます。
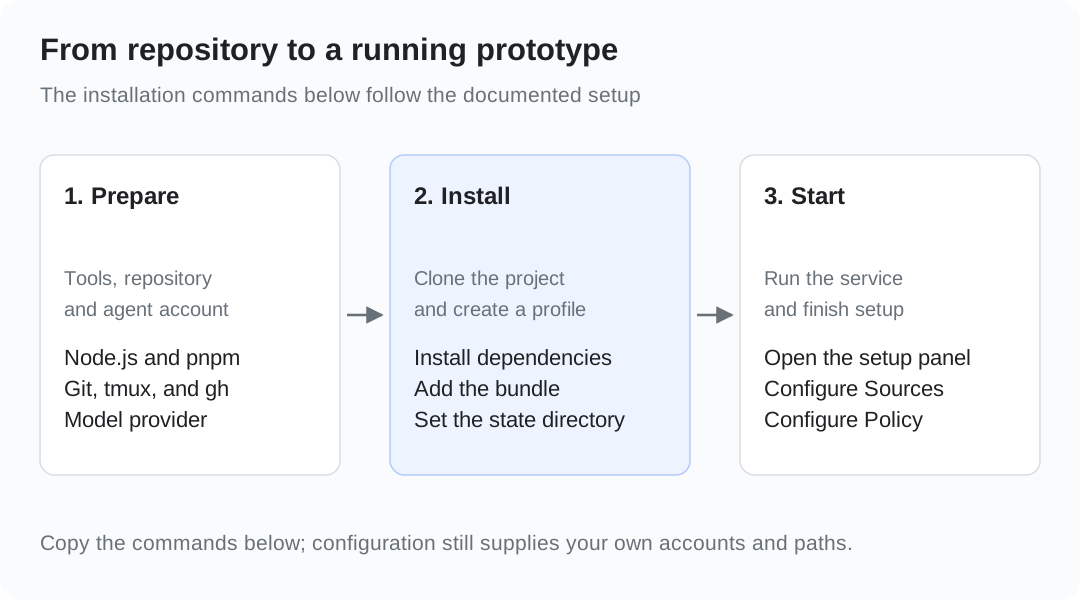
1. DeepSeek Super Agentの動作要件
文書に記載されている要件は次のとおりです。
- Node.js 22.19以降または24以降、およびpnpm。
- Git 2.32以降、Python 3.8以降、tmux。
- GitHub CLI 2.48以降。
- 設定済みのモデルプロバイダー。
- 対象のGitHubリポジトリ。
- エージェント専用のGitHubアカウントと、誰が作業を依頼できるかを定めるルール。
2. GitHubリポジトリをクローンし、SETUP.mdに従う
リポジトリをクローンします。
git clone https://github.com/deepseek-ai/dsh-superagent-prototype.git dsh-superagent
cd dsh-superagent
コーディングエージェントで設定する場合は、次の指示を使います。
Read SETUP.md in this repository and set up dsh-superagent with me.この手順で、対象リポジトリ、エージェントのアカウント、認可されたユーザー、モデルプロバイダーを設定します。
3. DeepSeek Super Agentをインストールして起動する
次のコマンドで新しいプロファイルを設定します。既存の設定を上書きしないよう、先に同名のプロファイルがないか確認してください。
npm install -g @deepseek-ai/dsh@0.2.1-rc.3 pnpm@11.7.0

pnpm install
pnpm build

dsh superagent --from-default-profile web --dump-config > /dev/null
dsh plugin --profile superagent add "link:$PWD"

cp examples/profile.cordis.patch.yml ~/.dsh/profiles/superagent/cordis.patch.yml設定項目のstateDirに使用したい絶対パスを設定し、サービスを起動します。
scripts/dsh-superagent start
scripts/dsh-superagent status初回起動時は、終了コード3が設定の未完了を示す場合があります。起動ログに表示されたアドレスから設定画面を開き、モデル、対象リポジトリ、GitHubのID、認可するユーザー、作業ディレクトリを設定してください。
DeepSeek Super Agentのよくある質問
DeepSeek Super Agentはオープンソースですか?無料ですか?
公開プロトタイプはMITライセンスです。実行にはモデル推論と計算資源が必要で、モデルの利用料、インフラ、保守にコストがかかります。
複数の人がエージェントにタスクを依頼できますか?
はい。設定したIDと認可ルールによって、誰がタスクを依頼・更新できるかが決まります。
Super Agentは、自分で見つけた作業を実行できますか?
自動実行には認可ルールの設定が必要です。既定の観測モードでは、システムは推定した作業を認識・記録しますが、実行はしません。
Super AgentはDeepSeekの新しいモデルですか?
Super AgentはDeepSeek Harness上で動くシステムアーキテクチャです。モデル、ツール、イベント、実行セッションをまとめて管理します。実際の理解、推論、コード生成は、設定したモデルが行います。
参考資料
DeepSeek Super Agentの技術記事は、当初中国語で公開されました。原文の図を含む日本語訳全文はこちらです。 Super-agentの設計を探る:より自律的なエージェントシステムへ — 日本語訳全文