Super-agentの設計を探る:より自律的なエージェントシステムへ
本記事は、エンジニアリングの観点からアーキテクチャの考え方を検討するものです。DeepSeek Harnessの既存の製品機能を紹介する記事ではありません。
1. Super-agent
この1年、単一タスクを扱うエージェント、特にコーディングエージェントは、モデルがツールを使い、継続的な監督や段階ごとの介入を人に求める度合いを減らしながら、複雑な問題を解決できることを示してきました。同時に、モデルは複数エージェントの協調も得意になり、セッションをまたいだ編成やスケジューリングが可能になりつつあります。実行の細部に人が関わる必要が減るにつれて、人の役割は、より上位の判断や成果の検収へと移りつつあります。
モデルの能力向上は、新しいアプリケーションの形も生んでいます。最近はパーソナルエージェントが数多く登場し、日常のメッセージ、カレンダー、メール、業務プラットフォームに直接つながり、情報の流れを継続的に観測してタスクの処理を支援しています。この常時稼働・イベント駆動型の動作は、個人利用に限られるものではありません。パーソナルアシスタントは用途の一つであり、ソフトウェア開発などの業務でも同じように価値があります。
しかし、現在主流のエージェント設計では、この動作を複数タスクやチームの協働に広げることは依然として難しい状況です。エージェントは今も単一のSessionを作業の基本単位とし、Session同士は独立しています。ユーザーが複数の作業を並行するときは、Sessionを手動で切り替え、それぞれのコンテキストを覚えておかなければなりません。私たちの観察では、1人が同時に把握できる稼働中のSessionは通常3〜5個ほどです。この設計では、単一タスクの上限はモデルの能力が決め、複数タスクの上限は人の注意力が決めます。
既存のローカルな単一セッション型エージェントをCLI、MCP、外部コネクターで拡張するだけでも、外部のメッセージは受け取れるかもしれません。しかし、単一セッション内の同期的な待機、タスク間で絡み合うコンテキスト、ローカル端末がオフラインになると実行が止まるといった制約は残ります。手作業による保守も、なお多く必要です。
これらの制約を越えるには、エージェントを、人が手動で開始する単一セッションに結び付ける設計を見直す必要があります。エージェントは、セッションをまたいでコンテキストを保持し、複数の複雑なタスクを互いに干渉せず進められる、継続的な存在になるべきです。私たちは、この形のエージェントとそのシステムアーキテクチャをSuper-agentと呼びます。
たとえば、DeepSeek Harness上で社内運用しているSuper-agentのインスタンスでは、同じ開発タスクをインスタントメッセージとGitHubをまたいで継続できます。また、公開グループチャットのフィードバックを継続的に監視し、誰も@メンションしていなくても、自ら原因を特定して修正のPull Requestを提出しています。
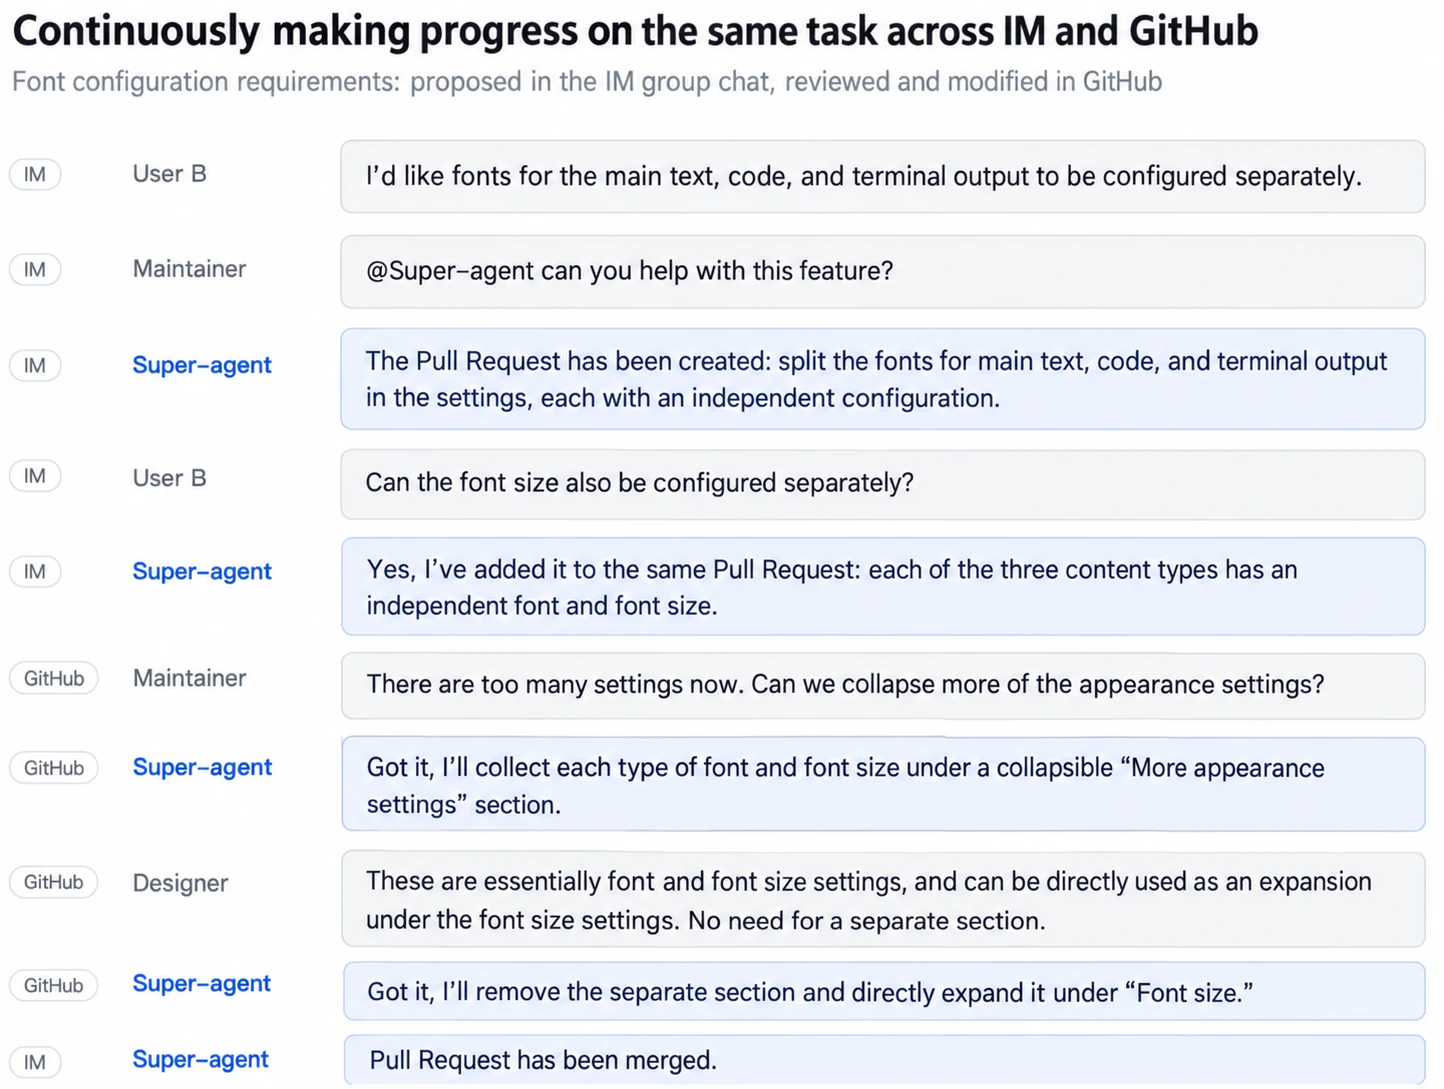
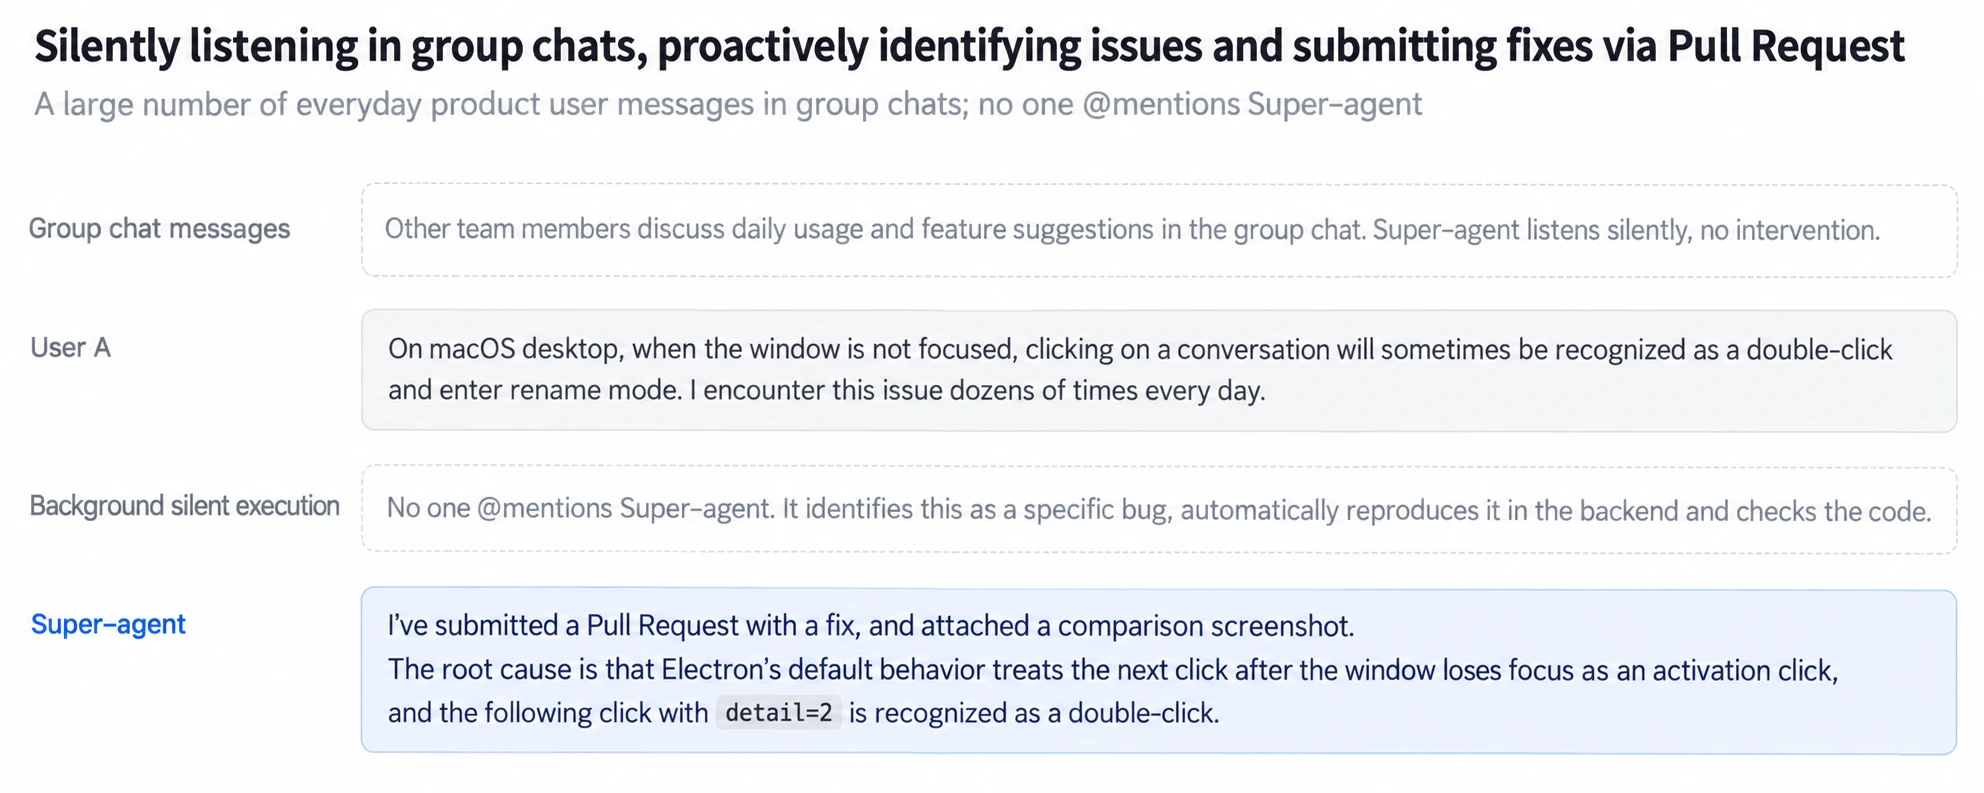
具体的には、Super-agentには次の四つの基本的な特性があると考えています。
- 継続性:ユーザーは、IMチャットやGitHubのコメントなど、使い慣れた業務画面から直接やり取りできます。常に一つのエージェントと話しているように感じられ、「Session Xのコンテキストには情報Yが入っているか」と考える必要がありません。たとえば、IMで最初に案Aを提案し、後からGitHub Pull Requestのコメントで案Bに切り替えた場合も、エージェントは変更を理解して作業を調整できます。
- 効率性:素早く応答しながら、複数の複雑なタスクを高い水準で並行して完了できます。前のコマンドやタスクが終わるのを待たず、次の指示を受け取れます。
- 能動性:環境内のイベントを継続的に観測し、対応する価値のある事柄には自ら行動します。指示を一つずつユーザーが出すのを待ちません。介入が不要なときは静かにしています。
- 持続性:常時接続を保ち、ユーザーの実際の作業環境に直接つながり、長時間の稼働中に発生した異常から自動的に復旧します。
一つのReAct Loopだけで、これら四つの特性を同時に支えることはできません。適切な基盤アーキテクチャが必要です。設計上の制約が似ていれば、アーキテクチャの選択も似てきます。個人向けアシスタントでも、ソフトウェア開発などの業務用エージェントでも、常時稼働して環境内のイベントに並行して応答するシステムを作ると、基盤は似たものになると考えています。その過程で直面する問題の多くは、従来のコンピューターシステムが数十年にわたり研究してきた問題ともよく似ており、古典的なシステム設計の考え方を活用できます。
このアーキテクチャの実装には、さまざまな形があり得ます。それでも、次の五つのモジュールが、四つの特性を支える基本構成になると考えています。2層アーキテクチャは、継続的な対話と効率的な並行処理を両立します(第2節)。イベント駆動の動作は、能動的な応答を可能にします(第3節)。人を中心とした対話は、コミュニケーションの継続性と効率性を両立します(第4節)。計算、状態、環境の分離(第5節)とWatchdog(第6節)は、端末をまたぐ持続的な稼働と、異常からの自動復旧を可能にします。
次の図はSuper-agentシステム全体のアーキテクチャです。図中の[2]〜[6]は、以下の第2〜6節に対応します。
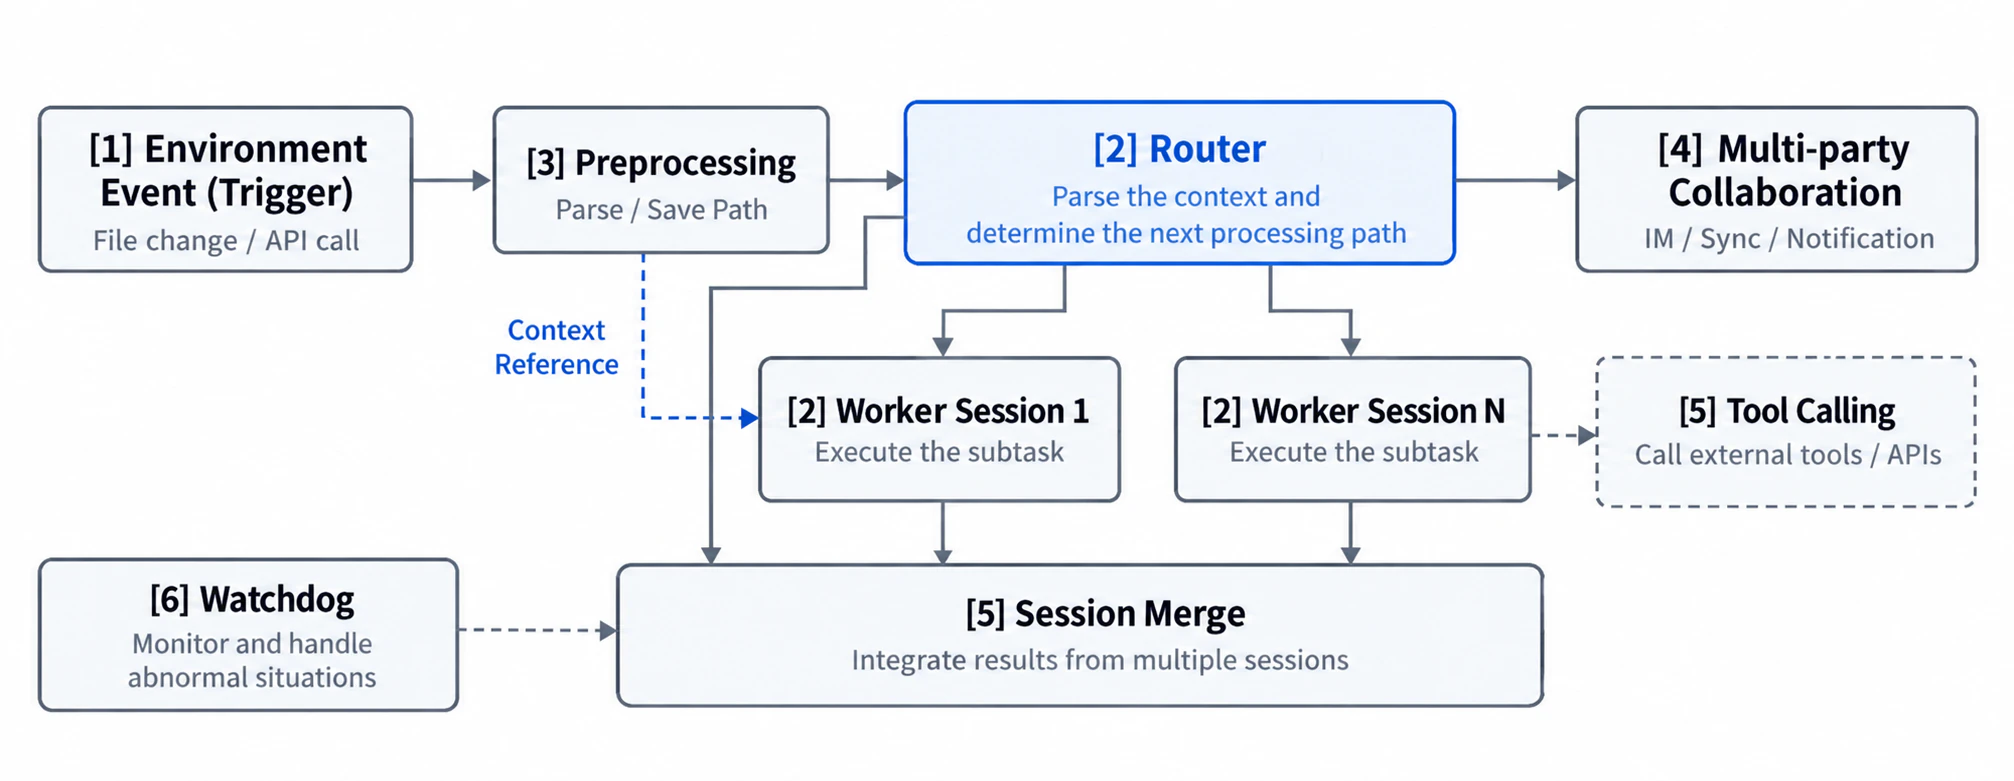
2. 2層アーキテクチャ
チャネルをまたぐ継続的な対話と、タスクをまたぐ効率的な並行処理を両立するには、基盤となるセッションの編成において、継続性とスループットの基本的なトレードオフに向き合う必要があります。
すべてのイベントを同じSessionに送れば、コンテキストの継続性は最大になります。しかし、単一のReAct Loopが直列実行する速度に制約され、タスクの完了に時間がかかり、スループットも低くなります。複数タスクの途中経過が混ざることで、結果の品質を損なう可能性もあります。
逆に、イベントごとに独立したSessionを新設すれば、並行処理のスループットを最大化できます。しかし、タスクが完全に独立していない場合、全体のコンテキストがないために結果がつながらなくなります。複数のSessionがそれぞれユーザーに返答すれば、混乱も生じます。
継続性とスループットの釣り合いを取るため、「全体の継続性の維持」と「高い並行性での実行」を別の層に分けられます。常駐するRouter層が人との対話と全体の調整を担当し(第2.1節)、Worker層が分離されたコンテキストで具体的なタスクを並行実行します(第2.2節)。次の図のような構成です。
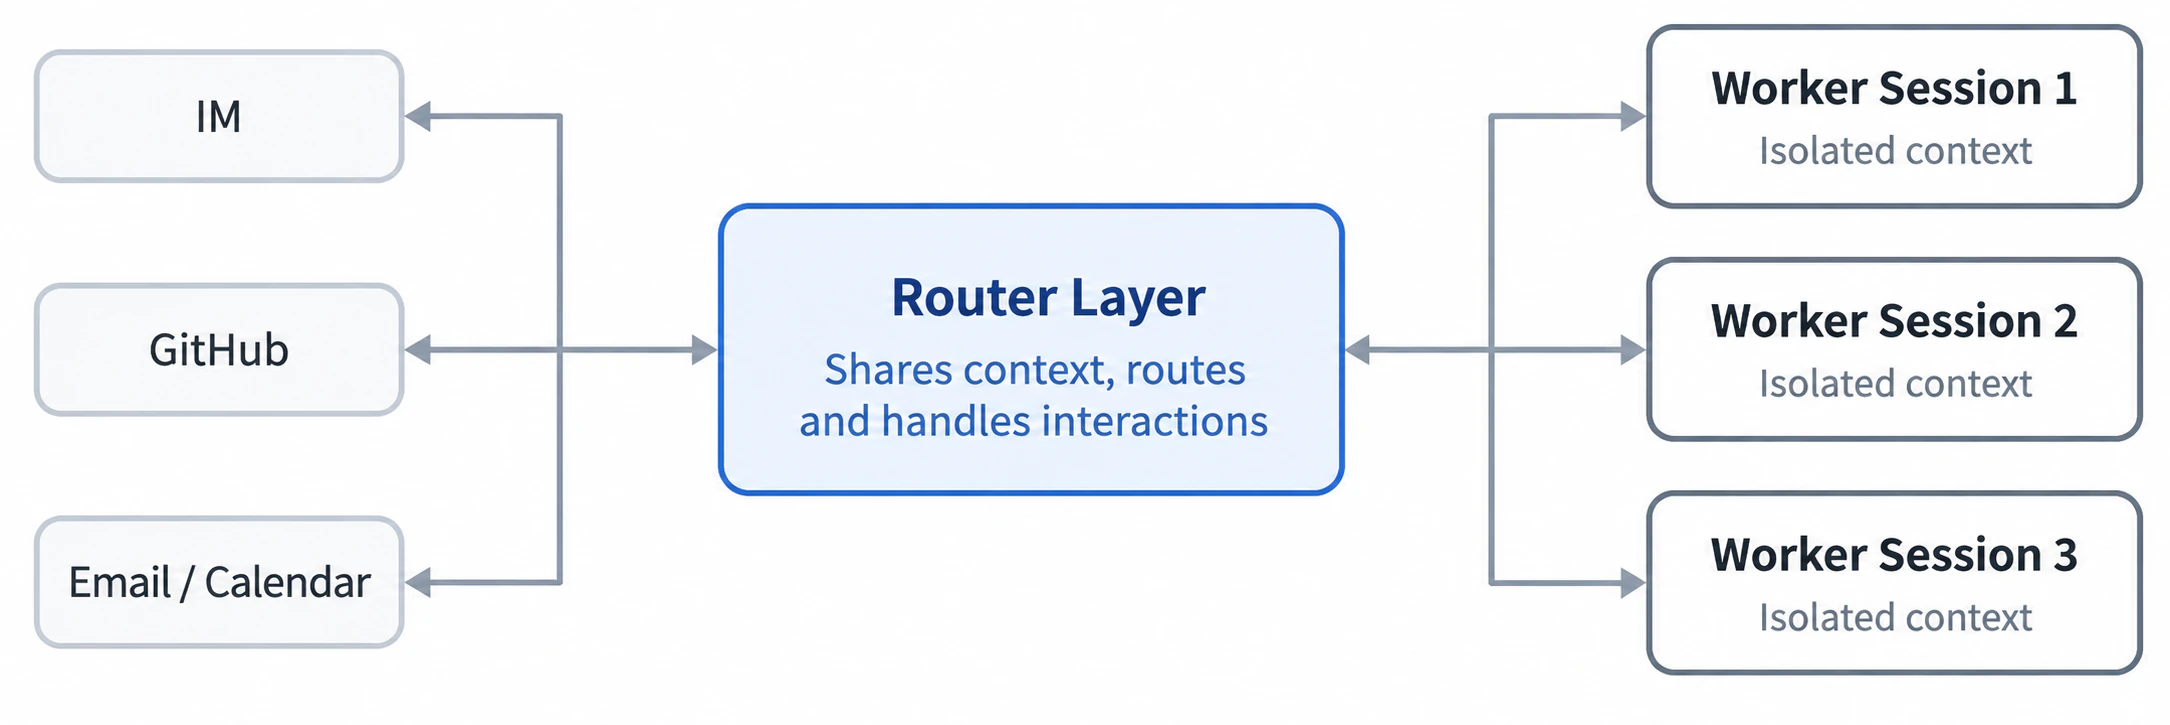
この2層アーキテクチャでは、基盤システムがコンテキスト管理と並行実行を引き受けます。Sessionはユーザーから見えにくくなり、ユーザーは常に同じSuper-agentとやり取りします。こう考えると、Sessionをユーザーに手動で管理させる設計は、基盤のLLM APIから受け継いだ慣習の影響が大きいといえます。Sessionはシステムの実装上の詳細であるべきで、ユーザーの認知的な負担にするべきではありません。
既存の設計では、一つのSessionが、技術的なコンテキスト管理とユーザー向けのプロジェクト管理を兼ねています。製品の体験を基盤のSessionから切り離せば、ユーザー向けのプロジェクト管理は、その制約を受けなくなります。どのような対話やタスク管理の体験を提供するかは、独立した製品設計の問いになります。この点は後ほど取り上げます。
ここでいう「2層」は、責任を論理的に分けたものです。各層を一つのSessionで実装する必要はなく、それぞれが内部構造を持てます。以下でRouter層とWorker層を説明します。
2.1 Router層
Router層は、あらゆる入口からの人との対話を扱う、常駐型の全体ルーティング層です。タスクをまたぐ情報と判断をここに集め、全体の順序を定める地点、調整役、記憶として機能します。この全体をつなぐノードが性能上のボトルネックにならないよう、Router層は具体的なタスクを自ら実行しない設計にします。人との対話とタスクの割り当てだけを担当し、Bashツールを持たない構成もあり得ます。
中央のノードが複数の実行ノードに作業を割り当てる構造は、典型的なAgent Teamに似ていますが、重点は異なります。一般的なAgent Teamは、主に一つの複雑なタスクの手順分解や役割調整に使われます。サブステップ同士の結び付きが強いことが多いため、Team Leadはタスクを深く理解し、サブタスクを計画し、メンバー間の調整を頻繁に行う必要があり、推論の負担も大きくなります。Super-agentのRouter層が扱うのは、タスク間の上位の関係と割り当てだけです。個々のタスクの内部を分解する必要はありません。逆に、Agent Teamのメインセッションに、具体的な作業を自ら実行せず、外部との対話とメンバーへの個別タスクの割り当てだけを行い、各メンバーが独立して進めるようプロンプトで制約すれば、それもこの種の2層アーキテクチャと見なせます。私たちの経験では、Router層の仕事は、見た目ほど複雑でないことが多く、軽量なモデルでも速度と良い結果を両立できる場合があります。
Router層の内部も、一つのSessionにする必要はありません。処理の一部にはLLMが不要なこともあります。私たちは最も単純な実装として、単一の常駐LLM Sessionを中核に据えました。実際には、想像するほどスループットのボトルネックにはなりにくいことがわかりました。ある推論ラウンドの間に届いた環境イベント、すなわち第3節で説明するTriggerは、次のラウンドまで蓄積し、まとめて処理されます。これによってバッチ処理が生まれ、複数のイベントをまとめる追加コストは小さくなります。
- 外部イベントの流れが落ち着いているときは、TriggerがRouter Sessionに一つずつ入り、個々の応答遅延は小さくなります。
- イベントが集中してRouter Sessionに待ち行列ができると、前の推論ラウンド中に蓄積した複数のTriggerが自動的にまとめられ、次のLLM呼び出しに一括で投入されます。Router Sessionが行うのは軽量な対話と割り当てだけで、各ステップは通常、入力が長く出力が短い処理です。待機中のTriggerを一つのLLM API呼び出しにまとめると、prefillの段階で並列に計算できます。そのため、1リクエストの所要時間の増加は、バッチサイズの増加よりもはるかに緩やかです。一定の範囲内では、蓄積が多いほど、判断1件当たりに按分した推論時間は短くなります。上限は、コンテキスト長と、モデルが1ラウンドで正確に扱えるTriggerの数によって決まります。
第7.2節では、このバッチ処理の効果を実験で定量化します。後述する購読と直接配送の仕組み、Chain of Recall(第3.2節、第3.3節)と組み合わせることで、現在のチーム規模では、コンテキストの継続性を維持しながら単一の常駐Router Sessionで十分に対応できています。
規模がさらに大きくなり、一つのセッションでは実際に足りなくなった場合、Router層に多段のフィルタリング構造を採用したり、複数セッションに水平分割、すなわちシャーディングしたりできます。その段階での内部設計は、根本的には継続性とスループットのトレードオフです。分割を細かくするとRouter層の並行処理能力は増えますが、シャード間の記憶やコンテキストの継続性は弱くなります。全体で共有する記憶の問題が解決されるまでは、このトレードオフが残ります。
2.2 Worker層
Worker層は、実行を担当するセッションで構成されます。各Workerのコンテキストは他のWorkerから分離され、実行ツールを一式備えているため、自分のコンテキストで一つのタスクに集中できます。Worker Sessionはタスクの成果やコードの品質を直接左右するので、通常は利用できる中で最も能力の高いモデルが必要です。
Workerは人と直接やり取りしません。推論やツール呼び出しを外部のチャネルに直接送らず、Router層に状態を報告し、Router層が代わりにユーザーへ返答します。これにより、並行処理と成果の品質を維持しつつ、複数セッションが独立して返答する混乱を避けられます。
複数のタスクを同時に実行するとき、各Workerは自分のタスクを独立して進めます。同じ層のWorker同士は、通常、直接通信する必要がありません。実行中の競合は、同じPull Requestなど、共有する作業環境で生じることが多いためです。対応するThreadをWorkerが購読していれば、同じイベント通知を受け取れます(第3.2節)。そこから、互いの競合を自ら認識し、解決できる機会が生まれます。タスクをまたいで必要になる少量の調整は、Router層が仲介します。
Router層と同様に、各Worker Sessionの内部も一つのセッションに限定されません。複雑な個別タスクを実行する際は、Workerがサブエージェントを作成したり、Worker自体をAgent Teamにしたりできます。これらの詳細は上位のRouter層からは見えません。この構造は、独立したIssueの再現、Pull Requestのレビュー、機能開発を互いに妨げず進める共同開発にも、パーソナルアシスタントにも適用できます。パーソナルアシスタントの画面は通常、一つのセッションのチャットページですが、ユーザーは同じ会話で複数の話題を扱うことがあります。一つのチャットページが対話の継続性を維持し、その下のシステムが話題ごとに別のWorkerを割り当てれば、タスクの実行や返答案の作成を並行して進められます。
3. イベント駆動の動作
Super-agentを能動的に動かすには、まず駆動の起点を変える必要があります。エージェントを動かす主な入力は、人がSessionに一つずつ打ち込むプロンプトではなく、環境から届く半構造化されたイベントになります。Super-agentでは、グループチャットのメッセージ、メールやカレンダーの通知、コードレビューのコメント、CIの結果といった環境イベントをTriggerと呼びます。Triggerを監視して応答することで、単一Sessionの方式のように、人の指示を受けて一度だけ実行する動作から抜け出せます。
環境イベントが到着してから処理されるまでをたどり、四つの問いを順に取り上げます。コードとモデルを組み合わせた2段階の戦略で大量のノイズをどう取り除くか(第3.1節)。購読と直接配送によってイベントをWorkerにどう届けるか(第3.2節)。Inline & SpillとChain of Recallで情報密度の高いコンテキストを投入し、必要なときにどう取得するか(第3.3節)。そして、投機的実行を使い、環境の兆候に基づいてバックグラウンドでどう先回りして動くかです(第3.4節)。
3.1 イベントのフィルタリング
実際のグループチャットやコード管理プラットフォームに接続すると、環境イベントの流れには「ノイズが多く、対応が必要なものは少ない」という特徴が顕著に表れます。日常のメッセージの大半は、エージェントの介入を必要としません。すべてのイベントを最初から大規模モデルに評価させると、遅延も計算コストも維持が難しくなります。コンピューターシステムのFast Path / Slow Pathという考え方を借りると、大規模モデルの推論は、柔軟ですが高価なSlow Pathと見なせます。よく理解できていて、安定し、頻繁に行う判断を決定的なコードに落とし込めば、低遅延・低コストのFast Pathになります。
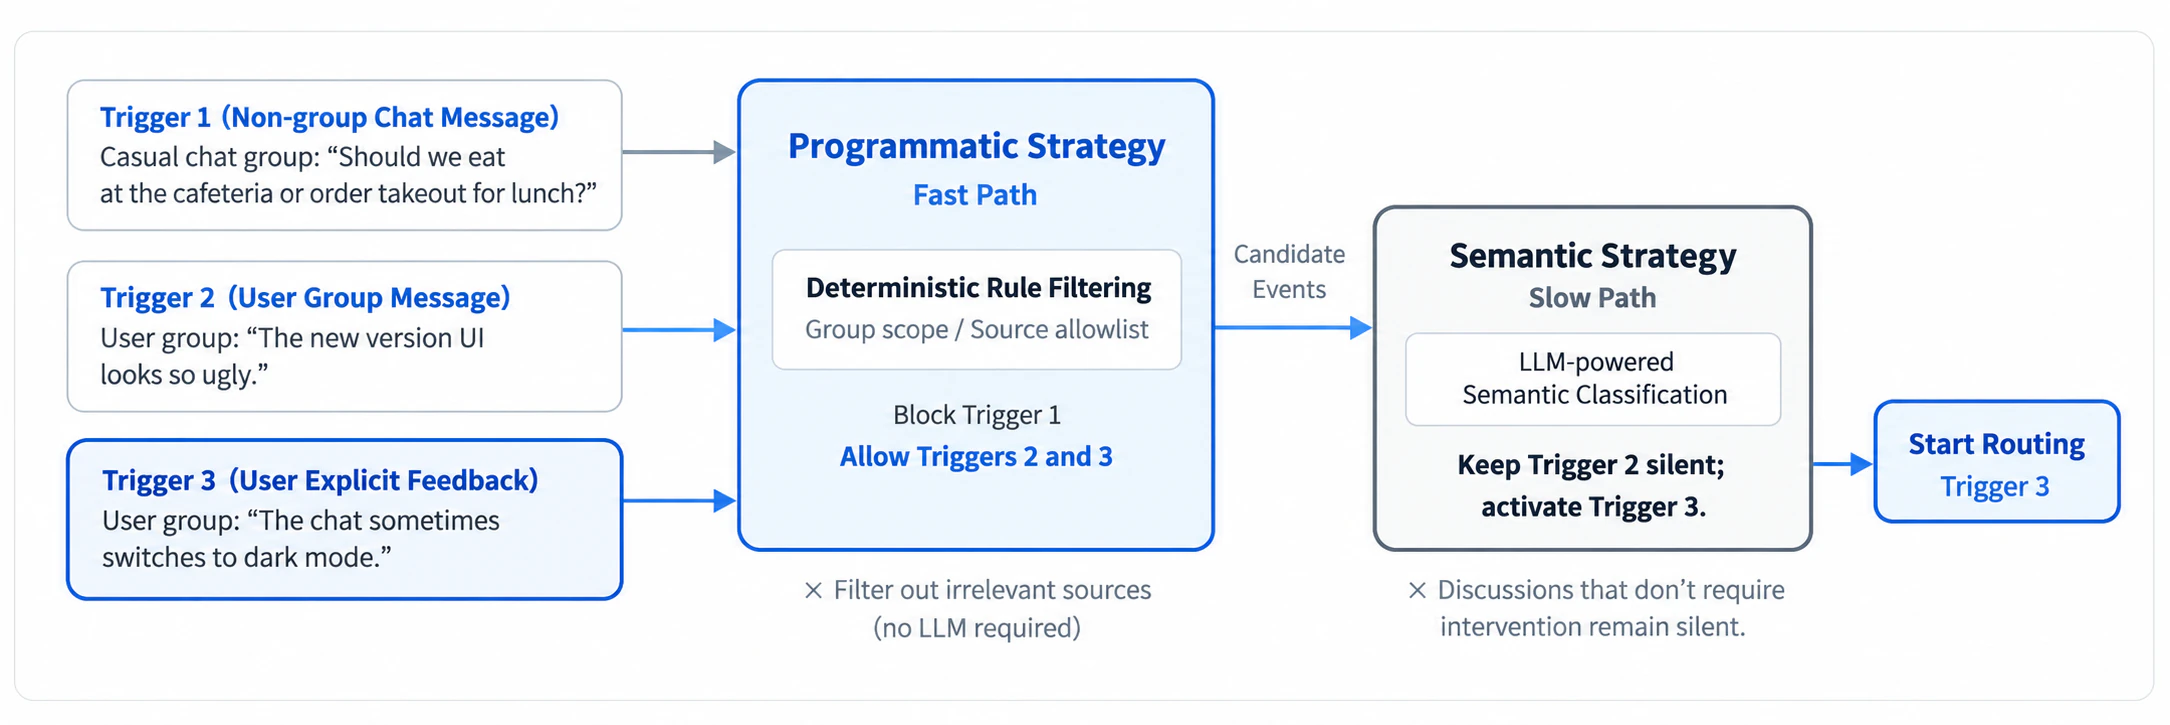
したがって、イベントがシステムに入って最初に行う処理はフィルタリングです。大規模モデルを呼ぶ前に、決定的なポリシーでノイズを取り除き、意味の理解が必要な候補イベントだけをモデルの判断に回すのが目的です。私たちは、プログラムによるポリシーと大規模モデルを組み合わせた2段階のフィルタリングを使っています。
- プログラムによるポリシー — Fast Path:コードが、イベントの送信元、対象グループ、ユーザーやBotの許可リストなど、決定的な条件に基づいて素早く受け入れを判断します。たとえば、送信元ごとに「明示的な依頼にだけ応答」「候補イベントとして検討」「そのまま無視」と設定でき、モデルを呼ぶ前に無関係なメッセージの大半を取り除けます。
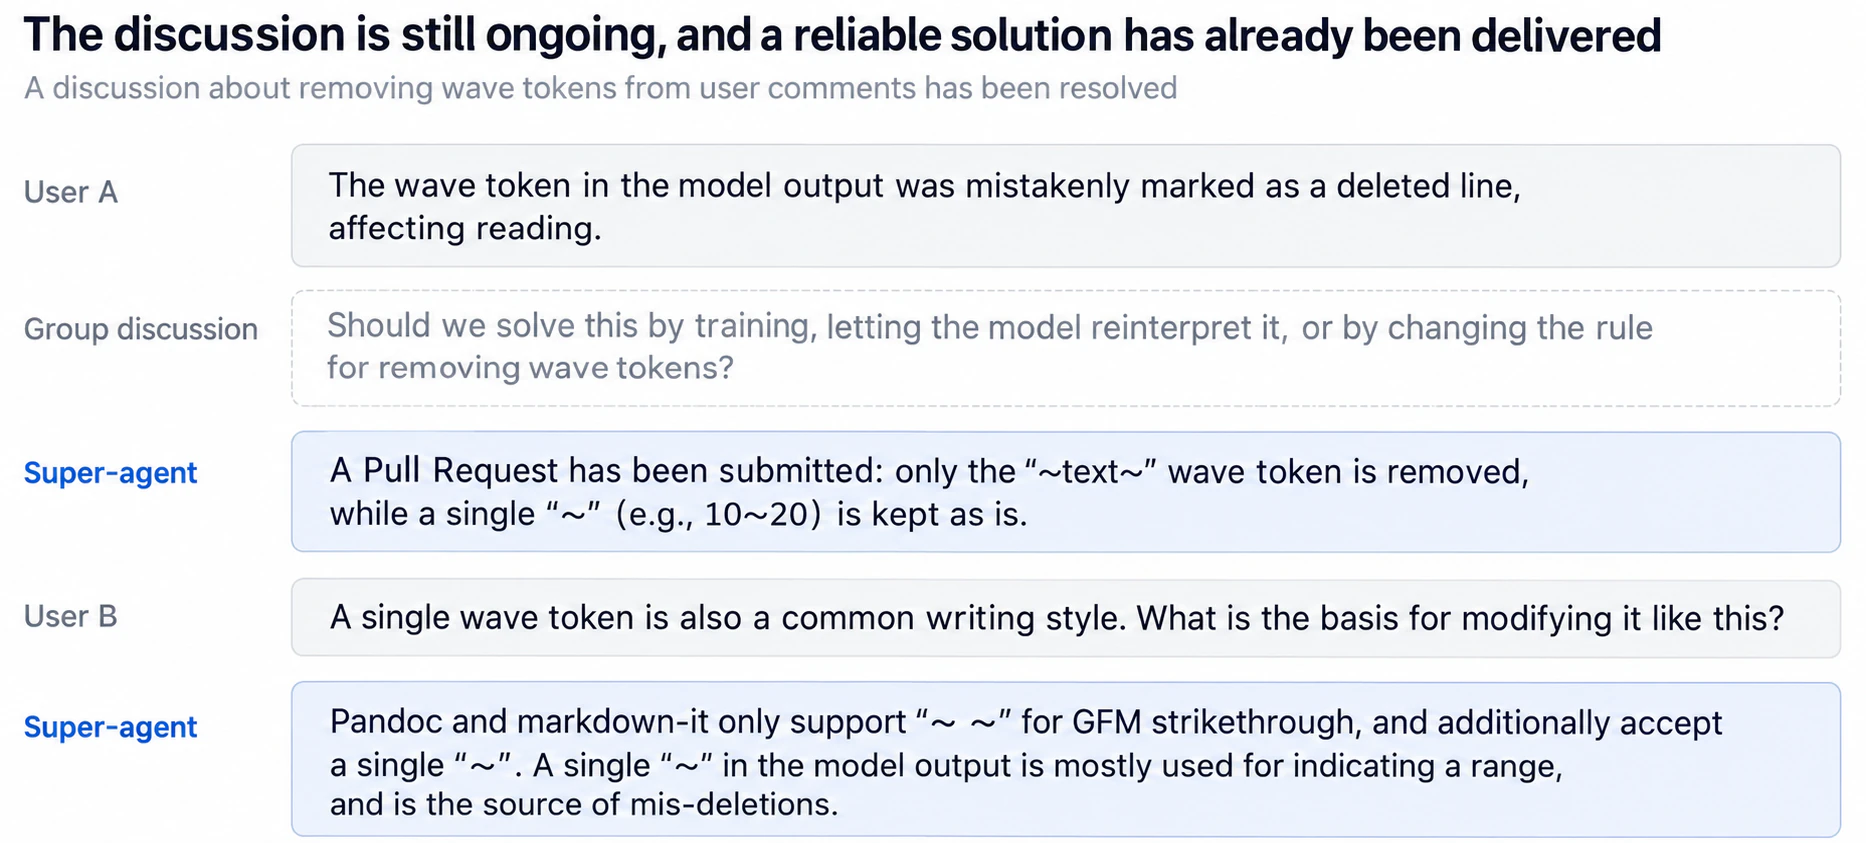
- 意味に基づくポリシー — Slow Path:プログラム層を通過した候補イベントをLLMに送り、プロンプトに書かれたポリシーとコンテキストに基づいて対応の要否を判断させます。この意味判断の層は、人が自然言語で拡張するための入口にもなります。次の図のように、プロンプトでポリシーを簡単に有効化、無効化、追加できます。
3.2 イベントのルーティング
第2節で紹介した、システム全体を担うRouter層は、チャネルをまたぐ継続性を保ちます。しかし、割り当て済みタスクの後続イベントまで毎回ここで転送していては、この中央ノードの負荷が高いままになり、システムの応答遅延が増えます。そのため、フィルタリング後のイベントのルーティングにも、Fast Path / Slow Pathの考え方を適用します。全体のRouter層が担うのは、新しいタスクの開始とタスク間の調整だけです。担当が決まった後は、コードが後続イベントを該当するWorker Sessionへ直接送り、Router層による転送を不要にします。
実際のワークフローでは、同じGitHub Pull Request、IMのトピック、メールの会話に属する連続したイベントが、一つのイベントストリーム、すなわちThreadを形成します。
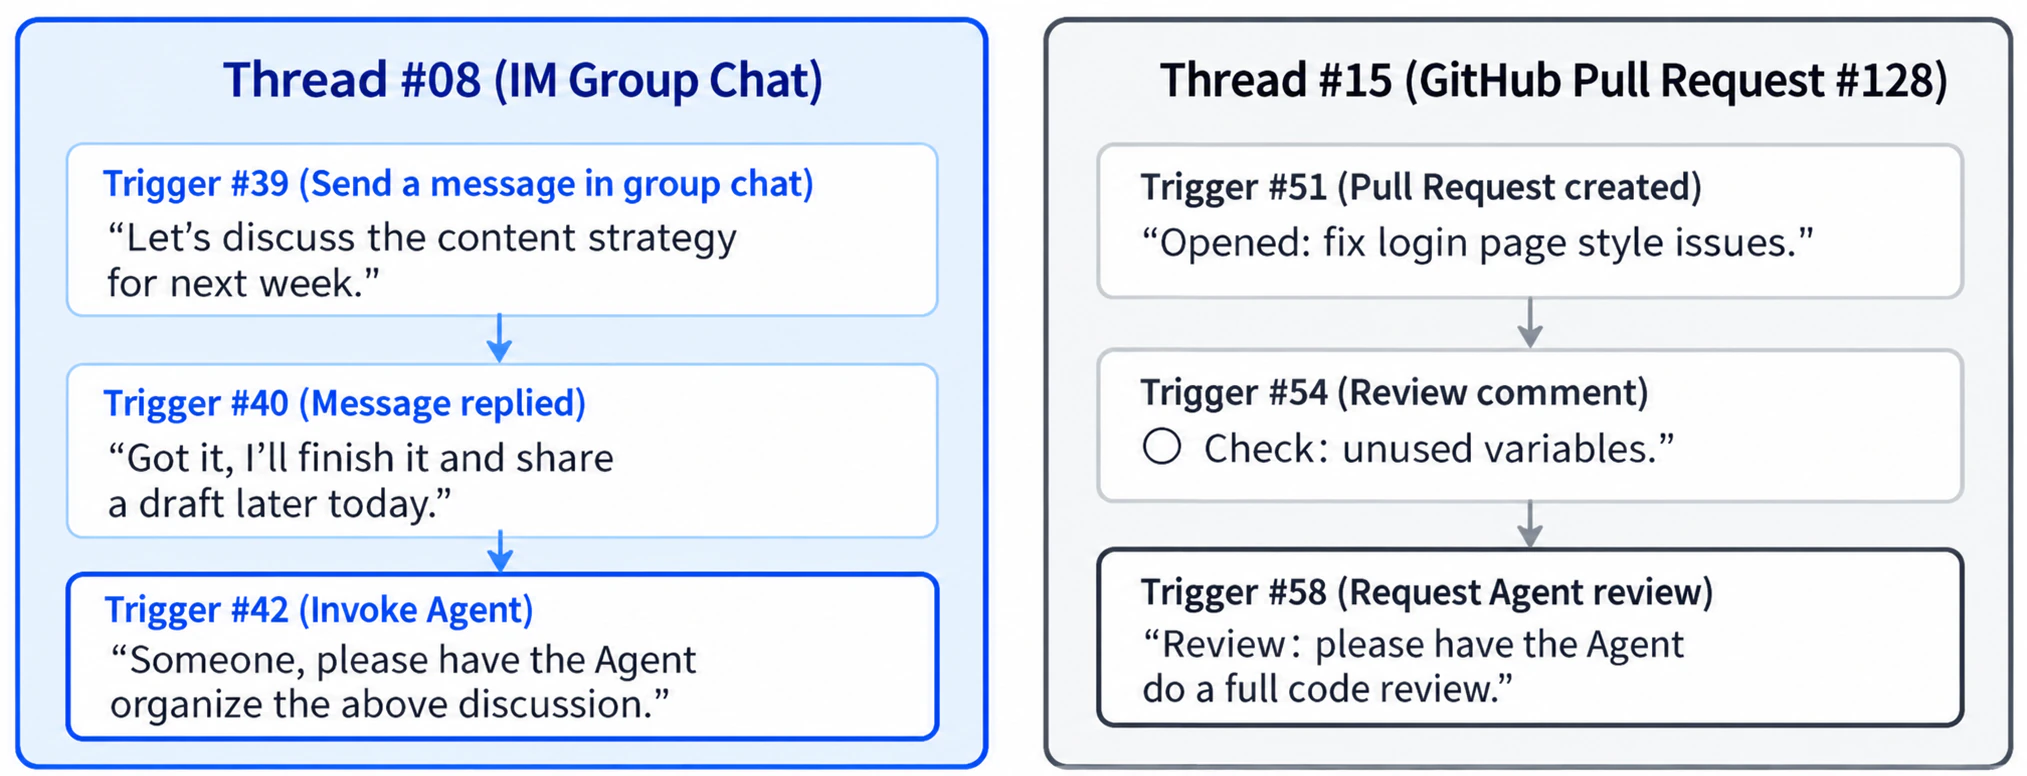
Router層がThreadの最初のイベントからWorker Sessionを作成すると、そのWorkerはThreadを直接購読します。その後のイベントのルーティングは、次の二つの経路に分かれます。
- 購読済み — Fast Path:同じThreadの後続イベントを、コードが購読中のWorkerに直接届けます。Router層が再転送のためにツールを呼ぶ必要はありません。新しいイベントが現在のタスクの範囲外であれば、Workerは購読を解除するか、再割り当てのためにRouter層へ戻せます。
- 未購読 — Slow Path:Router層は引き続きすべてのイベントを観測し、全体を把握できますが、判断して割り当てる必要があるのは、まだ購読されていない新しいイベントだけです。
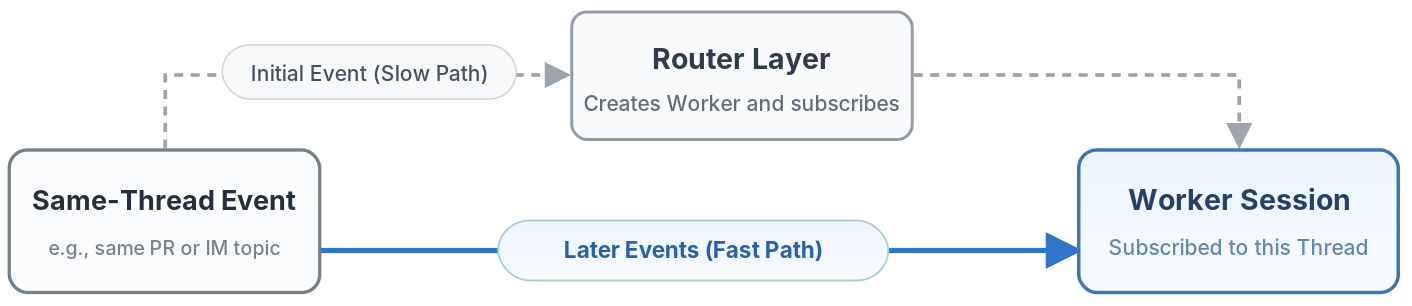
ThreadとWorkerの購読関係は多対多です。一つのWorkerが複数の関連Threadを購読でき、一つのThreadを複数のWorkerが購読できます。Worker同士が同じ作業環境や議論で交わると、そのThreadの新しいイベントはすべての購読者に直接届きます。個別の相互通信がなくても、互いの行動を知り、自ら競合を解決する機会が生まれます。出力側では、Workerは引き続き重要な結論をRouter層に報告し、Router層がユーザーに返答して全体の記憶を更新します。
3.3 コンテキストの構成
イベントをフィルタリングし、対象のSessionへ送った後は、モデルのコンテキストウィンドウにどれだけ情報を入れるかが次の課題になります。システムの入力が、限られた人のプロンプトから、半構造化された環境イベントの連続的な流れへ変わると、ツール呼び出しやイベント投入の構造がさらに重要になります。投入しすぎるとウィンドウを消費し、モデルの注意を薄めます。少なすぎると情報を取るためにツールを繰り返し呼ぶことになり、実行ステップが増えます。コンテキストウィンドウの浪費は、モデルの知能の浪費です。
そこで、限られたコンテキストウィンドウをキャッシュとして管理できます。コンパイラ最適化やコンピューターシステムの考え方を借りると、コンテキストへの投入は二つの基本操作で説明できます。Inlineは、近いうちに必要になりそうな情報を現在のウィンドウへ直接入れ、追加のツール呼び出しの往復を省くことです。Spillは、ウィンドウの容量を超える完全な情報や使用頻度の低い情報をウィンドウ外に置き、中には参照や要約だけを残し、必要なときにモデルが読めるようにすることです。
Inline & Spillに、システム設計の古典的な局所性の原理を組み合わせれば、イベントの投入やツール呼び出しを段階的に最適化できます。
- 最小限の情報から始める:最初は、現在のオブジェクトのIDと内容の要約だけを渡します。
- 局所性に基づいて関連情報を徐々にInlineする:近いうちに必要になりそうな情報をInlineします。まず関係の深いオブジェクトのIDを添え、次に時間や構造が近い内容を添えます。たとえば、内容の先頭50文字、IMメッセージの前後と返信先のメッセージ、コードコメントが属するレビュー内の隣接コメントなどです。
- 上限を超えたらSpillする:すべてをInlineできない長い内容には小さな長さの上限を設け、残りをウィンドウ外にSpillします。単純な実装では、超過分を切り詰めつつ、続きを読むための入口を残します。モデルは必要に応じてツールを呼び、全文を取得できます。
さらに、多くの後続イベントがWorkerへ直接届けられ、長いタスク履歴が蓄積すると、Router層は全タスクの完全な履歴を自分のウィンドウに保持できなくなります。それでも、ユーザーが別のチャネルから過去のタスクに言及したときは、コンテキストを復元する必要があります。システム内の異なるオブジェクト型にInline & Spillを一貫して適用すると、必要に応じて複数の参照をたどる取得の仕組み、Chain of Recallが得られます。次の図のように、Router層が長期間の運用で以前の情報を見失う問題への対処に役立ちます。
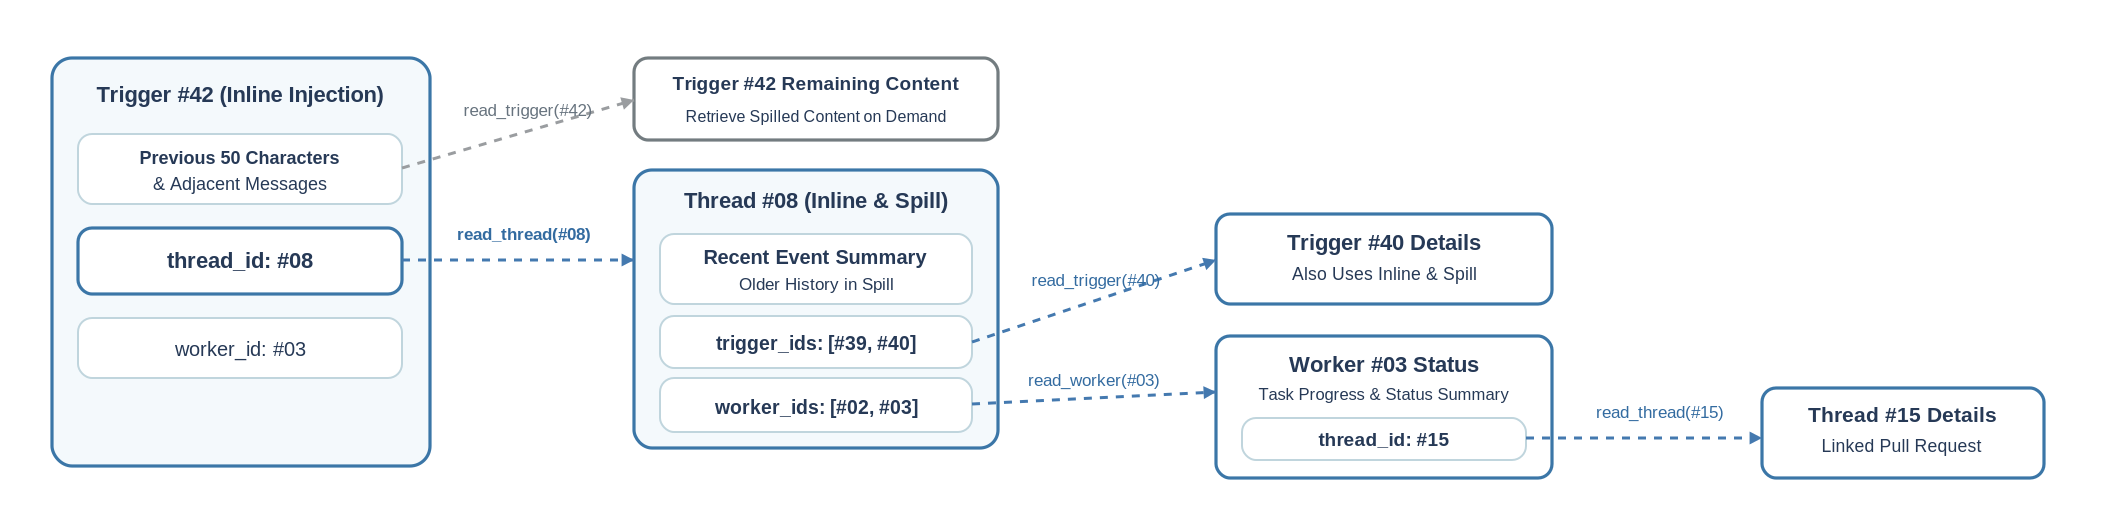
具体的には、Trigger、Thread、Worker Sessionなどのオブジェクトに固有のIDを割り当てます。オブジェクトを投入するとき、関係の深いオブジェクトのIDもInlineし、基盤となる参照グラフを形成します。ツール呼び出しで取得する各オブジェクトにも同じInline & Spillを適用するため、返されるデータには、次にたどれる関連オブジェクトの要約とIDが含まれます。モデルは現在のイベントを起点に、必要に応じて参照をたどり、コンテキストを段階的に呼び出せます。
たとえば、現在のメッセージが属するThreadを読み、ThreadにInlineされたIDから関連するWorker Sessionをたどり、そのWorkerに関連する別のコードレビューのThreadを見つけられます。
3.4 先回りして動く
コンピューターシステムの投機的実行にならい、結果が使われると確定する前から、環境の兆候に基づいてエージェントをバックグラウンドで動かせます。追加の計算資源をバックグラウンドで使うことで、人の待ち時間や介入を減らします。結果に価値があれば届け、そうでなければ破棄します。
パーソナルアシスタントなら、会議招待のメールや用件のメッセージを受け取り、バックグラウンドで予定の重複を調べ、関連する背景情報を集め、返信案を用意できます。ユーザーは確認後、すぐに確定して送信できます。共同開発でも同じです。たとえば、私たちは社内のDeepSeek Harnessユーザーグループに「静かに再現・修正する」ポリシーを設定しました。誰かが問題を報告したり変更案を議論したりすると、エージェントはまず裏で再現を試し、修正方法を探します。問題を確認し、単純な修正が見つかった場合だけ結果を届け、それ以外は最後まで静かにしています。
4. 人を中心とした対話
第2節の2層アーキテクチャは、チャネルをまたぐコンテキストの継続性を保ちます。しかし、実際の人とエージェントの対話で継続性と効率性を両立するには、対話の方法とチャネルに関する二つの問題も解く必要があります。第一に、非同期ReAct Loopによって、時間のかかるバックグラウンド処理が前面の会話を妨げる状態を解消し、前のコマンドやタスクが終わるのを待たずにセッションが新しい指示を受け取れるようにします(第4.1節)。第二に、使い慣れた業務チャネルをまたいでやり取りするとき、システムの出力を、各チャネルが扱える情報量や人の使い方に合わせる必要があります(第4.2節)。
4.1 全二重の対話
従来のReAct Loopでは、モデルが同期的なrun()ツール呼び出しを行うと、ツールが実行を終えて最終結果を返すまでループがブロックされます。その間、セッションはユーザーからの新しい入力に応答できません。この待機をなくすには、次の図のように、対話を半二重の一問一答から全二重の方式へ移す必要があります。
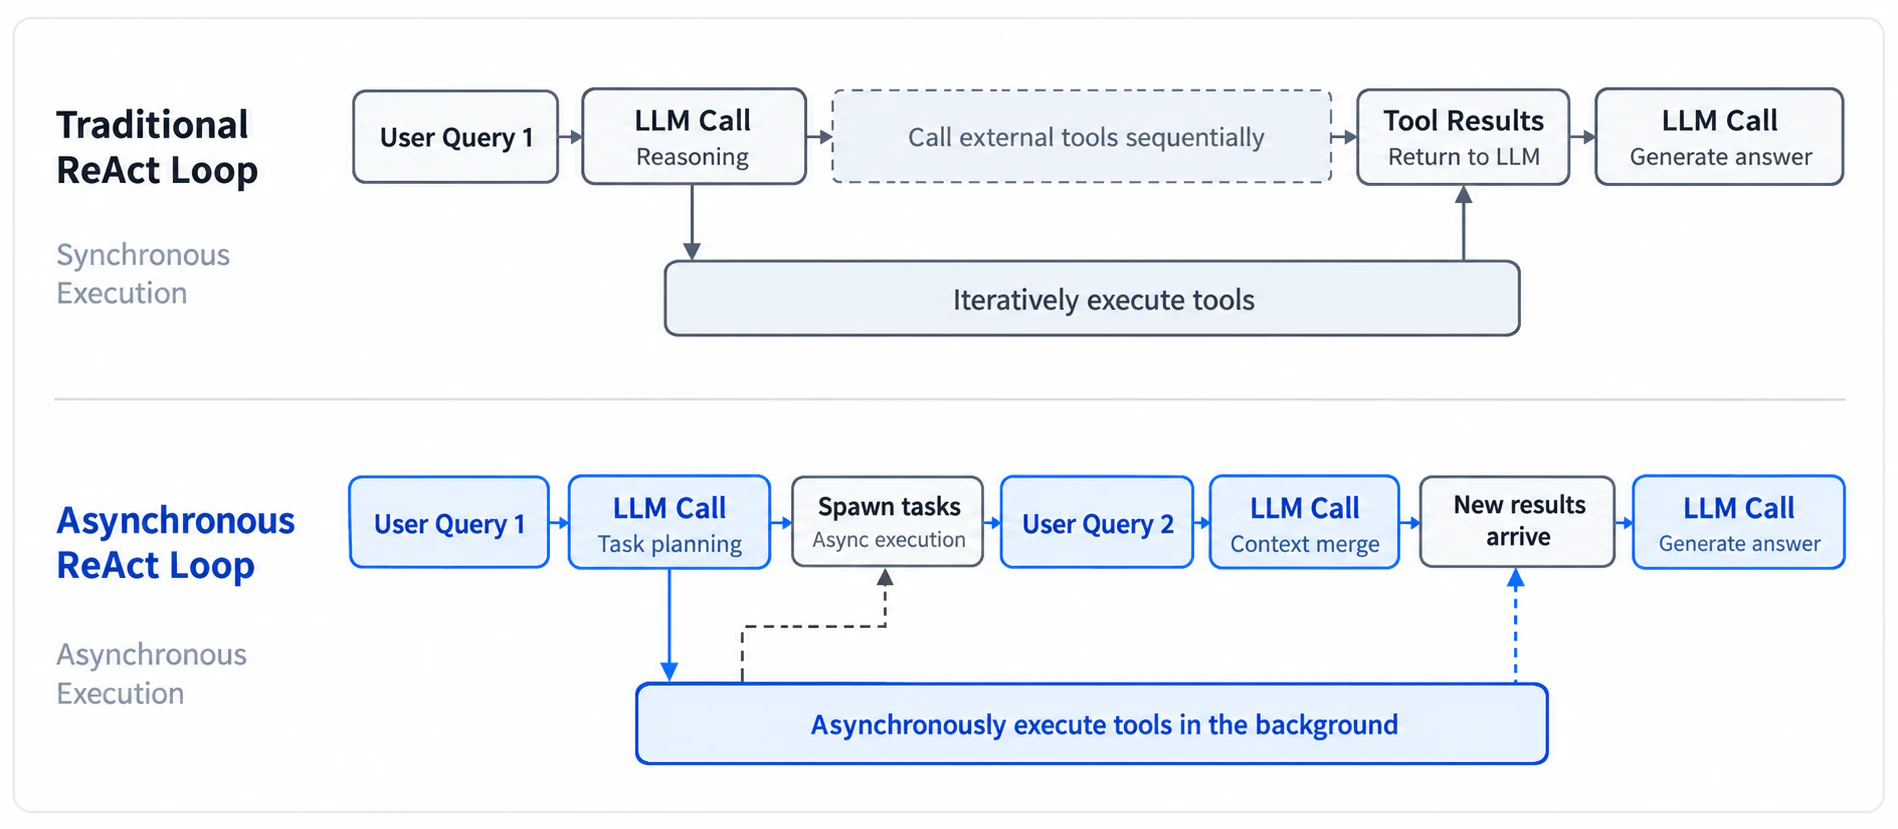
このために、時間のかかるコマンドやサブタスクのツール呼び出しを、非同期のstart()とstop()という操作に置き換え、非同期ReAct Loopを構成します。start()を呼ぶと、モデルは直ちに「Started」という応答を受け取り、ループはツールを待たなくなります。バックグラウンドのツールが終了すると、システムが最終結果を新たなイベントメッセージとしてセッションに届けます。また、モデルはコンテキストに基づいてstop()を呼び、長く動き続けるバックグラウンドのコマンドを終了させることもできます。
これにより、前面の会話とバックグラウンドのタスク実行を切り離せます。エージェントは、時間のかかるタスクを裏で実行しながら、人の入力に応答できます。新しい入力は、バックグラウンドのツールの完了を待たず、現在の推論ステップが終わり次第処理されます。
この非同期タスクの仕組みはDeepSeek Harnessに実装済みですが、まだ既定では有効になっていません。
4.2 チャネルをまたぐ対話
業務チャネルごとに、情報密度や対話の慣習は異なり、システムの出力もそれに合わせる必要があります。単一ユーザー向けのターミナル用インターフェースをグループチャットへそのまま持ち込み、長い推論過程や頻繁なツール呼び出しを逐一表示すると、グループで協働する人たちに情報を浴びせてしまいます。
Super-agentでは、2層アーキテクチャがすでにこの問題の一部を解決します。個別タスクの長い推論や頻繁なツール呼び出しをWorker Session内に閉じ込め、外部チャネルには直接送りません。外部との対話はRouter層が一元的に担当します。そのうえで、人が日常的に使う作業環境に接続し、プロンプトで各チャネルに適したやり取りのルールを定める必要があります。
- インスタントメッセージのチャネル:割り込みを最小限に抑えた、簡潔なコミュニケーションを重視します。人の同僚と同じように、判断や成果の検収が必要なときだけ通知し、質問は明確に、結論は短く伝えます。私たちが試した単純で効果的な厳守ルールの一つは、各返答を100語以内に収めることです。
- GitHub、メール、文書などの非同期チャネル:情報密度が高く、構造化された成果の提示を重視します。たとえば、Pull Requestを作成・更新するときは、プロジェクトの慣習に従い、問題、変更、検証結果を十分に記述します。パーソナルアシスタントなら、構造化されたメールや文書の要約を直接作成します。
5. 計算、状態、環境の分離
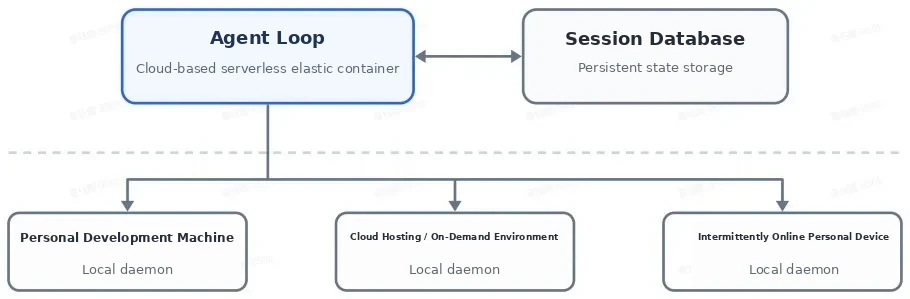
既存のローカルエージェントは、Agent Loopを進める計算、永続化すべきセッションの状態、コードリポジトリやローカルのツールチェーンといった実行環境を、同じ端末上に結び付けています。端末がスリープしたりオフラインになったりすると、エージェントは停止し、他の端末上の環境にもアクセスできません。Super-agentを継続的に利用可能にし、さまざまな実際の作業環境へ柔軟につなげるため、コンピューターシステムの計算とストレージを分離する考え方を借り、これら三つを2段階で切り離せます。まず、Agent Loopを進める計算と、永続的なセッションの状態を分離します。これにより、エージェントを単一マシンのライフサイクルから解放し、クラウドで継続稼働させられます(第5.1節)。次に、クラウドのAgent Loopを、多くの状態を持つ実行環境から切り離し、実際の作業環境を元の場所に置いたまま、端末をまたいで利用できるようにします(第5.2節)。
5.1 計算と状態の分離
Agent Loopを進める計算はステートレスにできます。永続化が必要なのは、セッションの状態です。そこで第一段階では、計算をクラウドのステートレスで伸縮可能なコンテナーに配置し、Sessionなどの永続的な状態をデータベースに保存します。ステートレスな計算用コンテナーは、水平に増やしたり、再起動・交換したりできます。永続ストレージがセッションやタスクの継続性を保つことで、エージェントは特定のローカル端末のライフサイクルに縛られず、クラウドで常時稼働できます。
5.2 計算と実行環境の分離
Agent Loopとセッションの状態を継続的にクラウドに置けるようになると、次の課題は、タスクに必要な実行環境へどうアクセスするかです。モデルの作業に必要なコンテキストの多くは、ツールを呼び、コードリポジトリ、ローカルファイル、依存するサービスなどの実行環境から得る必要があります。この広い意味では、実行環境そのものもコンテキストに含まれます。
一般的な方式は二つあります。一つは、クラウドでサンドボックスを起動し、コードを取得して、環境の再構築と同期を試みる方法です。しかし、実際の作業環境には、未コミットのローカル変更、非公開の認証情報、内部ネットワークサービスへの依存、特定のハードウェアやツールチェーンが含まれることがよくあります。そうした環境の同期は技術的なコストが高く、情報の欠落も起きやすくなります。もう一つは、ユーザーにローカル環境を手放し、作業をクラウドへ移すよう求める方法ですが、多くのユーザーにとって移行コストが高すぎます。
コピーや同期が難しいのが環境そのものなら、Agent Loopと一緒にクラウドへ移す必要はありません。第二段階の分離では、Agent Loopをクラウドで動かし、多くの状態を持つ実行環境は元の場所に残します。端末側には軽量なデーモンを置き、セッションの状態を保存させず、コマンドの実行と結果の返却だけを担わせます。実行環境は実質的にクラウドの外に残り、エージェントは必要に応じてそこからコンテキストを読み取ります。
これはAnthropicの「頭脳と手を切り離す」という考え方に通じます。Harnessをステートレスに保ち、セッションログを外に保存し、統一インターフェースを通じて実行環境へ必要に応じて接続するものです。違いは想定する場面です。その記事はマネージドサービスを説明し、主にオンデマンドで作成するサンドボックスや、顧客のVPC内のリソースを論じています。ここで最初につなぐ環境は、人が日常的に使うパーソナルマシンです。断続的にしか接続されず、未コミットの変更やローカルの認証情報を持つこともあります。そのため、この設計はBYOM(Bring Your Own Machine)、つまり普段使う開発マシンや個人のコンピューターをクラウドエージェントにつなぐ方式と、クラウドで管理するマシンや必要時に作成する計算環境の両方に対応します。
その結果、エージェントは一台のマシンに限定されなくなります。実行端末を切り替え、タスクに応じた環境を選んでコマンドを実行し、コンテキストを取得できます。断続的に接続する端末にも対応でき、個人の端末が再接続されると、クラウドのエージェントが、その端末上で行う必要のあるタスクを自動的に開始し、完了させることもできます。次の図は、計算、永続的な状態、各種実行環境を切り離す2段階の構造を示します。
6. Watchdog
持続的な稼働には、第5節の計算とストレージの分離だけでは足りません。長期間の稼働で発生する異常から自動復旧する仕組みも必要です。常時動く分散システムを、内部のロジックだけで長く信頼できる状態に保つのは困難です。主システムの外に、独立した外部制御ループを置く必要があります。
エージェントシステムでは、従来のプロセスの生存確認や監視スクリプトだけでは不十分です。多くの失敗では、プロセスがクラッシュするわけではありません。モデルが成果につながらないループに陥ったり、目標から逸脱したりします。そのため、長時間動くエージェントシステムでは、インフラの稼働状態だけでなく、タスク自体の進捗も監視しなければなりません。
私たちは、主システムの外に独立したWatchdog Sessionを配置し、定期的なメッセージで駆動して外部制御ループを構成しました。APIエラーや状態の復元失敗といったインフラの障害に対処するだけでなく、モデルを使い、Workerの作業が実質的に進んでいるか、全体の目標から逸脱していないかを判断します。異常を検知したら、速やかに介入して修復します。一時的な外部障害については、通常の動作に戻るまで確認を続けます。
Watchdog自体がツールを一式備えたAgent Sessionなので、保守担当者は自然言語で障害について尋ねられます。また、稼働中の主システムの動作を変えるよう依頼することもできます。たとえば、プロンプトを追加・削除したり、Triggerのルールを調整したりできます。
7. 初期実験
ここまでのスケジューリングとルーティングの中核設計を評価するため、二つの水準で初期実験を行いました。まずエンドツーエンドの実験で、2層アーキテクチャと購読に基づく直接配送を、単一Sessionの方式と比較しました(第7.1節)。次に、Router層のバッチ処理を単独で検証しました(第7.2節)。合成ワークロードと簡略化した環境を使っており、実験条件にも、より厳密にできる点があるため、以下の結果は初期の参考値として扱ってください。
7.1 アブレーション実験
グループチャットとGitHub CIのメッセージの流れを使い、四つのエンドツーエンド方式を動かしました。各実験は約300件のメッセージで、そのうち作業依頼は約20件です。残りは雑談、追加の指示、停止依頼、CIのメッセージなどです。コーディング作業は時間だけを消費するツールに置き換えました。そのため、実験が測るのは、個々のタスクの実行能力ではなく、システムのスケジューリングと調整です。各方式を5回ずつ実行しました。
四つの方式は、Super-agent、直接配送なしのSuper-agent、そしてSubagentツールを持つ単一Sessionを二つの異なるプロンプト設定で動かすものです。
中立的なプロンプトは、英語で「Use a subagent for a piece of work when appropriate...」としました。
委譲を優先するプロンプトは、英語で「Every message of the chat reaches you, so work you run yourself keeps stopping for new messages. Prefer handing each piece of work to a subagent of its own, and do only small things yourself...」としました。
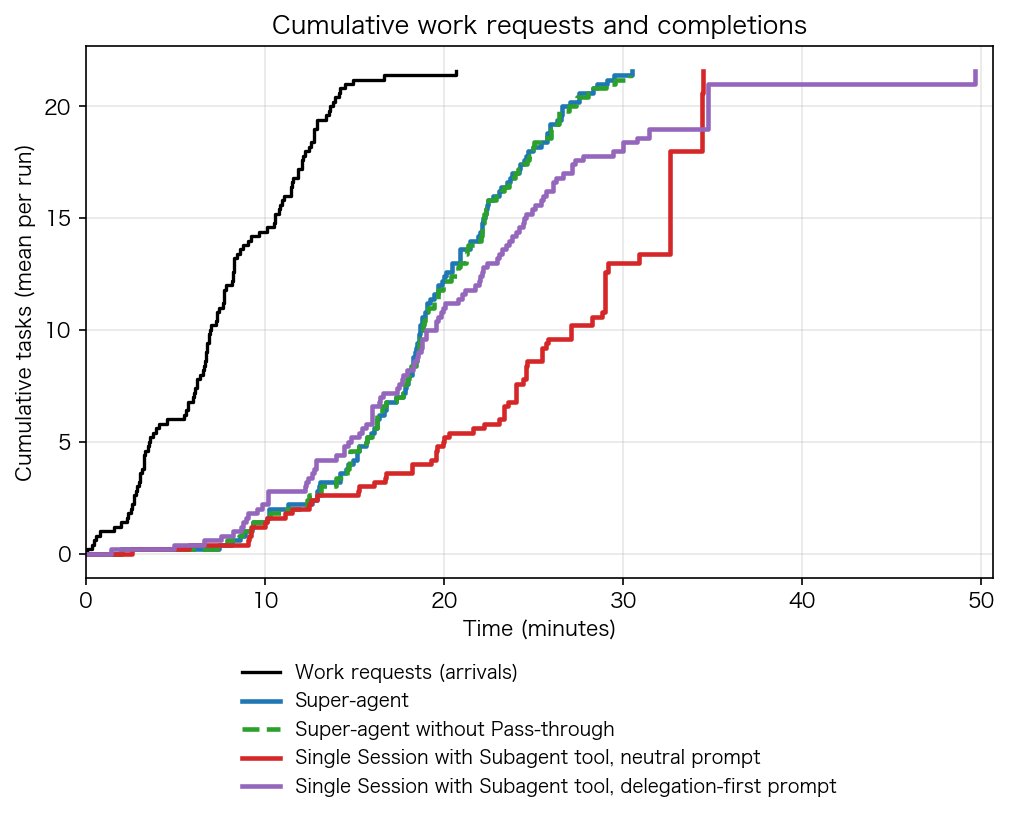
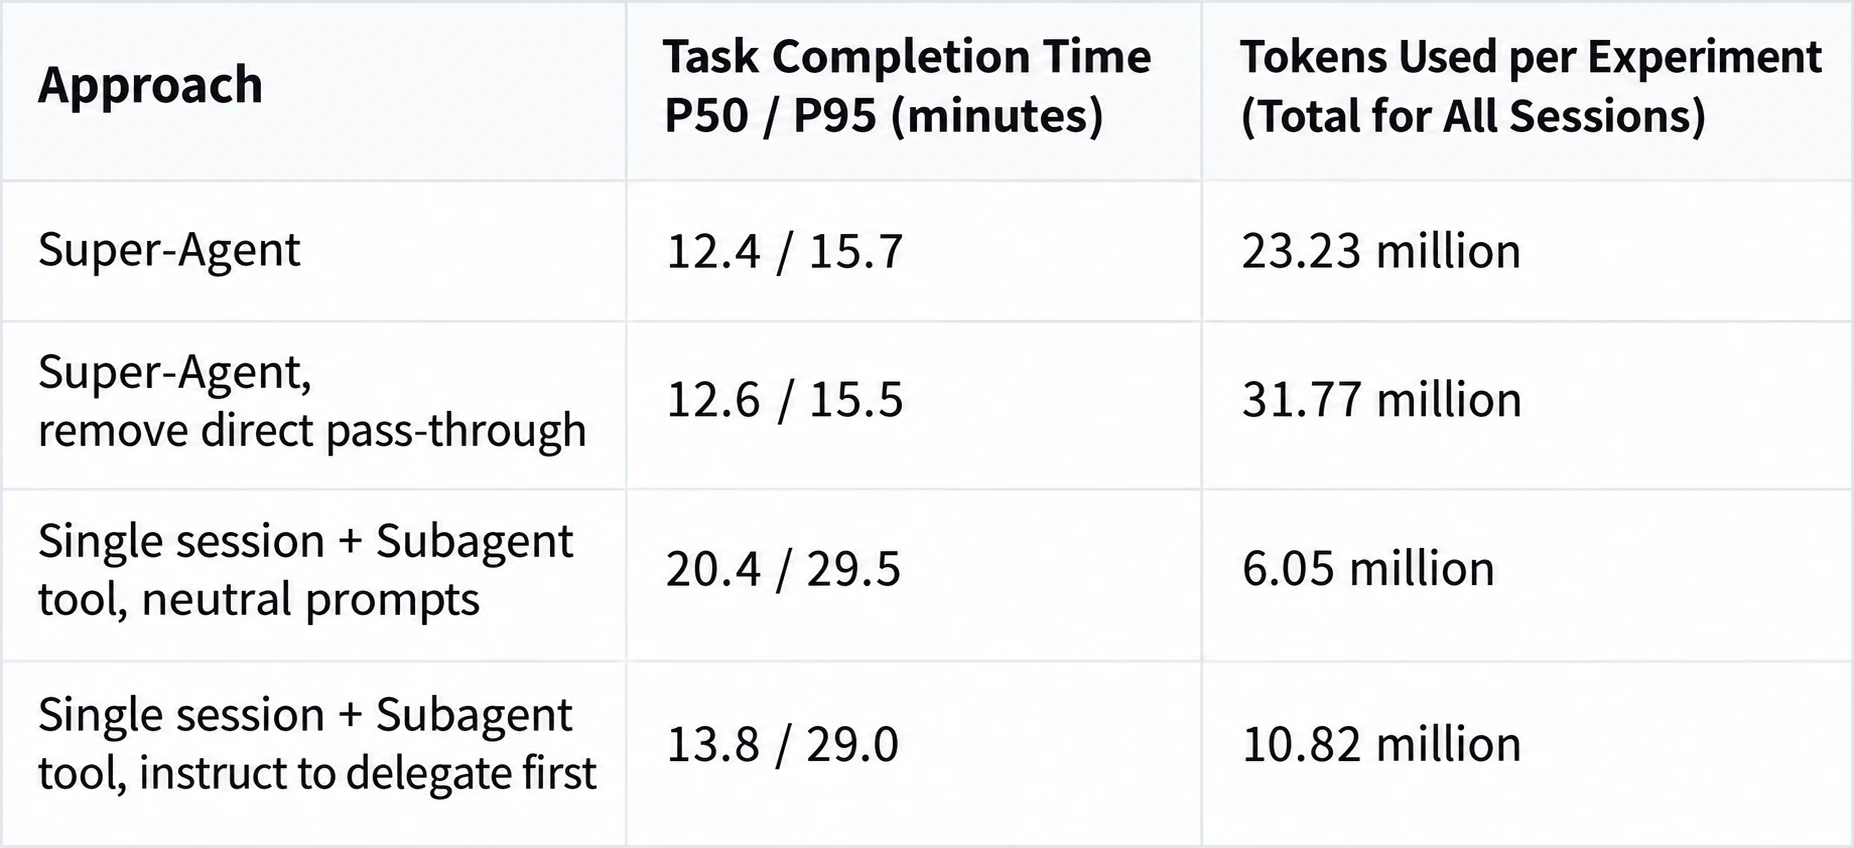
注:各方式を5回ずつ実行しています。タスク完了時間は、作業依頼から結果メッセージまでの経過時間です。
Super-agentのタスク完了時間はp50が12.4分、p95が15.7分と、Subagentツールを持つ単一Sessionより大幅に短くなりました。この実験条件では、サブエージェントを使う単一Sessionの挙動が、プロンプトに強く左右されたためです。メインのSessionが自らタスクを実行することを選びやすく、全体の完了に時間がかかり、結果も不安定になりました。中立的なプロンプトでは、5回ともSubagentを呼び出しませんでした。すべての作業がメインのSessionで行われ、新しいメッセージによって繰り返し中断され、p95は29.5分に達しました。委譲優先のプロンプトでは、5回中4回で委譲して完了時間が短縮しましたが、全体としてはSuper-agentより遅いままでした。残る1回では、作業を「小さい」と判断して自ら実行し、図の紫色の長い裾に相当する結果となりました。単一Session内でプロンプトの工夫や、その都度のモデルの委譲判断に頼る方式に対し、2層アーキテクチャはシステムの水準でこの問題を緩和します。Routerは具体的な作業を実行せず、Workerは購読するThreadからのメッセージだけを受け取ります。
システムのオーバーヘッドでは、複数の独立したセッションを維持するため、Super-agentの実験1回当たりのキャッシュ読み取りトークン数は、単一Sessionの方式より多くなりました。追加のトークン消費と引き換えに、より短く安定した完了時間を得ています。Super-agentから直接配送を外すと、タスク完了時間はほぼ変わらない一方、Routerが行う判断の回数は約30%増えました。実験1回当たりのキャッシュ読み取りトークンの総数は、2,323万から3,177万へ約37%増えています。このワークロードでは、直接配送によってタスクの完了品質や速度が改善したわけではありませんが、Router Sessionのトークン消費と推論のオーバーヘッドを大幅に節約できました。
7.2 Router層のバッチ処理
第2.1節で述べた単一の常駐Router Sessionのスループット上限とバッチ処理の仕組みを評価するため、Router層だけを対象に負荷試験を行いました。Routerは実際のモデルを呼び、Workerにはモックモデルを使いました。判断が必要なTriggerの到着頻度を、毎分約1件から約40件まで徐々に増やし、平均バッチサイズ、1リクエストの所要時間、判断1件当たりに按分した推論時間を観測しました。
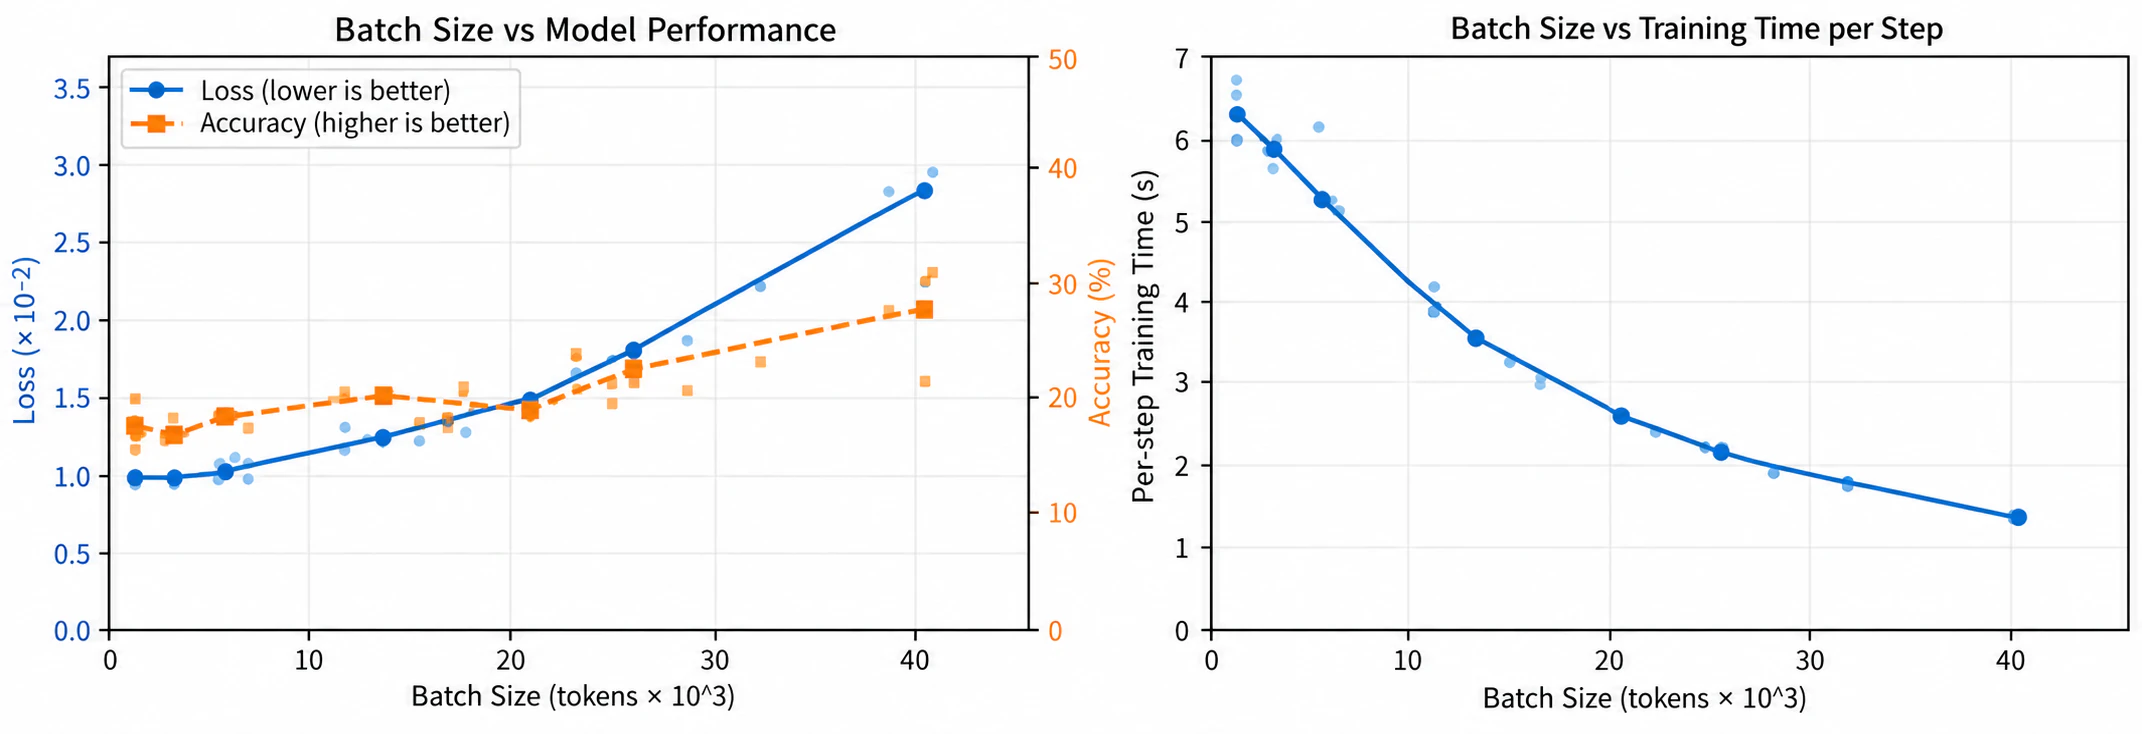
図のように、判断が必要なTriggerの到着頻度が毎分約1件から約40件へ増えると、平均バッチサイズは1.0から2.8へ増加しました。1リクエストの所要時間は2.5秒から3.9秒への増加にとどまり、バッチサイズよりも緩やかに増えています。その結果、判断1件当たりに按分した推論時間は6.4秒から1.6秒へ短くなりました。外部イベントが集中して待ち行列ができると、Router層が待機中のイベントを自動的にまとめ、実効スループットを改善できることを意味します。第7.1節で直接配送を外したとき、Routerのピーク負荷が増えながら、単一Routerのスループット上限に達しなかった理由も説明できます。したがって、現在のチーム規模では、全体のコンテキストの継続性を犠牲にしてまで、Router層を早くからシャーディングする必要はありません。
8. 未解決の課題
第2〜6節で紹介した五つのモジュールは、Super-agentを支える基本アーキテクチャです。第7節の実験でも、複数タスクが並行するワークロードで、中核となるスケジューリングとルーティングの効果を示しました。比較的複雑さを抑えて動かせているのは、現段階で、実装や利用場面にいくつもの単純化を加えているためです。その前提の外側には、2層アーキテクチャの拡張(第8.1節)、Sessionを越えた人とエージェントの協働(第8.2節)、コンテキストの境界とA2A(第8.3節)、セキュリティとプライバシー(第8.4節)について、未解決の問いが残ります。
8.1 2層アーキテクチャをどう拡張するか
「単一の常駐Router Session+購読に基づく直接配送+Worker間の直接通信なし」という単純な組み合わせで、現在の日常的なタスクの大半を、比較的小さな実装コストで扱えています。しかし、タスクの規模が増え、相互の結び付きが強くなると、単一のRouter Sessionの能力を超える可能性があります。各層の内部構造に決定的な答えはありません。Router層をいつシャーディングするか、どの粒度で分けるか、同じ層のWorker間の直接通信をいつ導入するか、どの協働トポロジーを使うかは、さらに多くの場面で検証する必要があります。システムとモデルの協調設計も検討に値します。Router層のイベント評価、バッチでの割り当て、コンテキストの呼び出しなどに特化した学習で、スループットや判断性能をさらに高められる可能性があります。
一方、ここまで述べた常駐Router層と、参照グラフに基づくChain of Recallは、主に最近のタスクやセッション履歴を必要に応じて取得する問題を扱っています。数か月、あるいはそれ以上の運用では、長期記憶が拡張性の主なボトルネックになります。
8.2 Sessionを越えて、人とエージェントはどう協働するか
2層アーキテクチャは、複数セッションの基盤での管理をユーザーから隠します。そのため、製品設計でSessionを第一に考える必要はなくなります。しかし、実行セッションが画面上の会話と一対一に対応しなくなると、新たな問いが生まれます。タスクをどう見せればよいのか。どのような対話やプロジェクト管理の体験が自然なのか。チャットウィンドウ中心の対話は、ある程度、過去の設計を引き継いだ結果だと考えています。領域に特化したインターフェースで、もっと多くの対話が行われてもよいはずです。たとえば、本記事の例のように、Super-agentがGitHub IssuesやPull Request内で直接働けます。ユーザーの慣れに合わせて、画面にSessionを残すこともできますが、ユーザーに見える一つの会話が、基盤の一つのSessionだけに対応する必要はありません。
ここまでは、主にタスクの開始と成果の検収時の人とのやり取りを論じてきました。しかし、モデルの能力が急速に進歩する移行期において、多くのタスクには途中での人の関与がまだ必要です。重要な細部への段階的な介入と、バックグラウンドで自律的に働く効率性を、製品設計でどう両立するかも検討に値します。たとえば、エージェントが裏で作業している間に、ユーザーがリアルタイムで介入したり、作業を引き継いだり、一緒に進めたりできる設計です。
全体として、必要なプロジェクト管理や対話の体験は、仕事の領域や個人のスタイルに強く結び付いています。最終的な形は、大きくカスタマイズされたものになるでしょう。DeepSeek Harnessのオープンなアーキテクチャも、そのようなカスタマイズを支えやすくしています。
8.3 コンテキストの境界とA2Aの協働をどう設計するか
これまでの議論は、一つのSuper-agentインスタンスの内部設計を対象にし、その範囲内のすべての情報を一つの全体コンテキストに集める前提でした。しかし、個人や小規模なチームから大きな組織へ利用が広がると、Super-agentをどう配置するかは、実質的に、どこでコンテキストを共有し、どこで分離するかを決めることになります。共有が必要な範囲では同じインスタンスを使い、分離が必要な範囲では別のインスタンスを使います。
さらに、組織の内外に、互いに分離された複数のインスタンスが存在するとします。たとえば、各メンバーのパーソナルアシスタントと、チーム共通のSuper-agentが併存する場合です。その境界を越える協働は、エージェント間通信、すなわちA2Aになります。ここで特定のプロトコルを指しているわけではありません。基盤のコンテキストを共有せず、異なる権限境界を代表するエージェント同士で、安全かつ信頼できるA2A通信や協働をどう実現するかは、未解決の課題です。
8.4 セキュリティとプライバシーをどう守るか
第3節のイベント駆動設計により、エージェントは、より幅広い環境からの入力で動けるようになりますが、信頼できない入力に触れる機会も増えます。セキュリティとプライバシーの問題に十分に対処できなければ、Super-agentは小さな信頼できる範囲内でしか運用できません。
たとえば、第5節のように、Agent Loopをクラウドに配置し、実行端末に軽量なデーモンを入れる構成は、クラウドと端末側の環境の相互信頼を前提とします。しかし、クラウドのAgent Loopが外部の環境イベントを継続的に受け取り、接続端末が非公開のコード、機微なデータ、ローカルの認証情報を持っていれば、端末間の接続には大きなセキュリティとプライバシーのリスクが伴います。サーバーへの侵入やプロンプトインジェクションでクラウドのAgent Loopが侵害されると、接続されたすべての端末が乗っ取られる可能性があります。
さらに、クラウドが侵害されていなくても、端末側の認証情報がモデルのコンテキストに入り得るなら、通常の実行中にも漏えいは起こり得ます。そのため、エージェントが認証情報自体に触れずに、その認証情報を利用できる仕組みが必要です。このアーキテクチャを広く普及させるには、多様な環境からコンテキストを呼び出せる能力を保ちつつ、これらのセキュリティとプライバシーの問題を解決しなければなりません。
9. 結論
設計全体を振り返ると、私たちは新しい理論を提案したわけではありません。コンピューターシステムの古典的な設計思想を、エージェントシステムの構築に応用しました。具体的な実装は技術とともに変わるでしょうが、基礎となるシステム設計の考え方は、より長い期間にわたり役立つと考えています。これらの考え方とDeepSeek Harnessを使って構築した社内のSuper-agentインスタンスは、すでに継続的に稼働しています。日々の問題の再現・修正、コードレビューへの対応、DeepSeek Harness自体の開発に参加しています。
冒頭で述べたとおり、大規模モデルが個々のタスクを実行するのに必要な人の介入は減りつつあり、生産性をさらに高める際のボトルネックは、人の注意力へ移っています。2層アーキテクチャ、イベント駆動の動作、チャネルをまたぐ非同期対話、計算とストレージの分離、外部のWatchdogによって、煩雑なセッション管理やコンテキストの同期を基盤システムが引き受けます。これにより、人は実行の細部からさらに離れ、より上位の判断と成果の検収へ役割を移せます。
この形のエージェントは、指示を受け身で待つチャットウィンドウにとどまりません。デジタル環境で常時稼働する、自律的な協働相手へ進化します。個人にとっては、端末をまたいで日常の用事を支援するパーソナルアシスタントになれます。チームにとっては、開発ワークフローに組み込まれ、具体的なタスクを引き受けて進めます。モデルの能力と基盤のアーキテクチャが共に進化することで、このような、より自律的な働き方が、人とエージェントの協働の標準になり得ると考えています。
本記事の設計の一部は、dsh-superagent-prototypeに実装されています。このプラグインは技術的な方式の検証用に提供するプロトタイプであり、DeepSeekの正式な製品ではありません。
著者と謝辞
本記事は、DeepSeek Harnessチームの共同実践から生まれました。Yujia Qiaoがシステムを実装し、記事を執筆しました。Huanqi Cao、Zui Chen、Xieting Chu、Tianyi Cui、Shiyuan Feng、Yudong Han、Kexin Liu、Shichun Liu、Gesi Luo、Yifan Shi、Tongrui Xiong、Hanxiang Xu、C.C. Yu、Ziya Zhang、F. Zhouらがレビューや議論に参加し、フィードバックを提供しました。システムの実装と記事の発展の両方が、チームの日々の意見交換と蓄積した経験に支えられています。