千问 4(Qwen4)是阿里千问的新一代大模型系列,Qwen4-Max 是这一代率先正式上线的旗舰模型。它于 2026 年 11 月 16 日发布,支持 100 万 Token 上下文,可以理解文本、图片和视频,通过代码生成、工具调用和结构化输出完成多步任务。
Qwen4-Max 采用混合专家(MoE)架构,拥有约 2.4 万亿主体参数,每个 Token 激活约 710 亿参数。此前的 qwen4-max-preview 于 11 月 11 日开放测试,正式版则开始提供按量计费 API,模型 ID 为 qwen4-max。阿里也表示,后续会开放较小的 Qwen4 模型权重。
Qwen4-Max 到底是什么级别?能和 Claude Opus 5.5 竞争吗?
从首发成绩看,它已经进入值得与国际旗舰模型比较的范围,特别是在网页开发方面。但综合能力更接近 Kimi K3.1 Pro,还不能认为它全面达到了 Claude Opus 5.5 的水平。
在 Artificial Analysis 的独立综合评测中,Qwen4-Max 得到 43 分,超过上一代 Qwen3.8-Max 的 34 分,接近 Kimi K3.1 Pro 的 46 分,但落后于 Claude Opus 5.5 的 59 分。
网页开发的差距更小。Qwen4-Max 在 WebDev Arena 取得 1750 Elo,首发暂列第 6,Opus 5.5 得到 1816 Elo,暂列第 2。
这让 Qwen4-Max 成为一个值得测试的前端开发模型。如果任务需要复杂的代码库操作、长程终端执行或高难度专业推理,目前仍应与 Opus 5.5、Kimi K3.1 Pro 等模型分别测试,不能直接替换。
Artificial Analysis · WebDev Arena
Qwen4-Max Benchmark:相比上一代提升了多少?
Qwen4-Max 的首发测试覆盖网页开发、软件工程、Agent 工作流、专业知识和多模态理解。不同机构使用的测试工具和推理设置不同,不能把所有分数直接放在一起比较。
下面优先列出 Artificial Analysis、Arena 和 Vals AI 的独立测试。三家机构均公布了正式版的评测结果,主要使用 xhigh 推理档位。
| Benchmark | Qwen4-Max | 对照成绩 |
|---|---|---|
| Artificial Analysis Intelligence Index | 43 分 | Qwen3.8-Max 34、Kimi K3.1 Pro 46、Opus 5.5 59 |
| WebDev Arena | 1750 Elo,第 6 | Qwen3.8-Max 1676、Opus 5.5 1816 |
| Image-to-WebDev | 1674 Elo,第 6 | Qwen3.8-Max 1639 |
| Vals Index v2.2 | 63.20%,第 11/38 | Qwen3.8-Max 59.05%、Kimi K3.1 Pro 62.52% |
| Vibe Code Bench v1.1 | 86.66%,21/50 个应用通过全部测试 | Qwen3.8-Max 16/50 |
| Terminal-Bench 4.0 | 约 48.5% | Qwen3.8-Max 约 38.9%、Kimi K3.1 Pro 约 67% |
| AA-Briefcase v1.1 | 1686 Elo | Qwen3.8-Max 1604、Opus 5.5 1801 |
| AutomationBench-AA | 约 73% | Qwen3.8-Max 56%、Opus 5.5 70% |
| Finance Agent v2.1 | 66.68% | Vals AI 排名第 8 |
| Tax Agent Bench | 40.35% | Qwen3.8-Max 49.7% |
| Legal Research Bench | 41.35% | Qwen3.8-Max 46.2% |
Arena 为首发初步排名,后续票数增加可能改变成绩。Vals AI 的排名采用当前模型页口径,不同日期的榜单总数可能变化。
Artificial Analysis 评测 · Vals AI 模型页 · Arena 网页开发榜
网页开发是目前比较突出的优势
Qwen4-Max 在 WebDev Arena 比上一代提升了 74 Elo,在截图转网页测试中也有提升。
Vals AI 的 Vibe Code Bench 测试了 50 个网页应用,正式版 Qwen4-Max 有 21 个通过全部测试,而上一代有 16 个。两项结果都支持它在前端生成与交互应用开发上的进步。
不过,1750 Elo 与 Opus 5.5 的 1816 Elo 之间仍有差距。网页布局是否好看、交互是否正确、能不能持续修改一个已有项目,也应分开判断。
复杂编程与专业任务仍有差距
在 Terminal-Bench 4.0 中,Qwen4-Max 约为 48.5%,高于上一代的 38.9%,但低于 Kimi K3.1 Pro 的约 67%。
在阿里公布的 ProgramBench 软件复刻测试中,Qwen4-Max 得到 31.5,Opus 5.5 得到 65.0。虽然 Qwen4-Max 在部分软件工程测试中表现不错,这项结果仍显示出长程编程能力上的差距。
专业任务也不是全面进步。
Vals AI 测得 Qwen4-Max 在 Finance Agent v2.1 中得到 66.68%,但 Tax Agent Bench 从上一代的 49.7% 降到 40.35%,Legal Research Bench 也从 46.2% 降到 41.35%。
如果企业使用模型进行财务、税务或法律相关工作,应该根据对应任务的评测结果选型,而不是只看综合排名。
Vals AI 详细结果 · 千问发布的 Benchmark 对比

三组实测:Qwen4-Max 实际做出来了什么?
跑分之外,已经有开发者公开了正式版的执行记录和成品。下面三组测试分别展示网页生成、设计差异以及推理档位对速度的影响。
1. 同题网页开发:Qwen4-Max 比 DeepSeek V4.1 Flash 早完成 31 分 24 秒
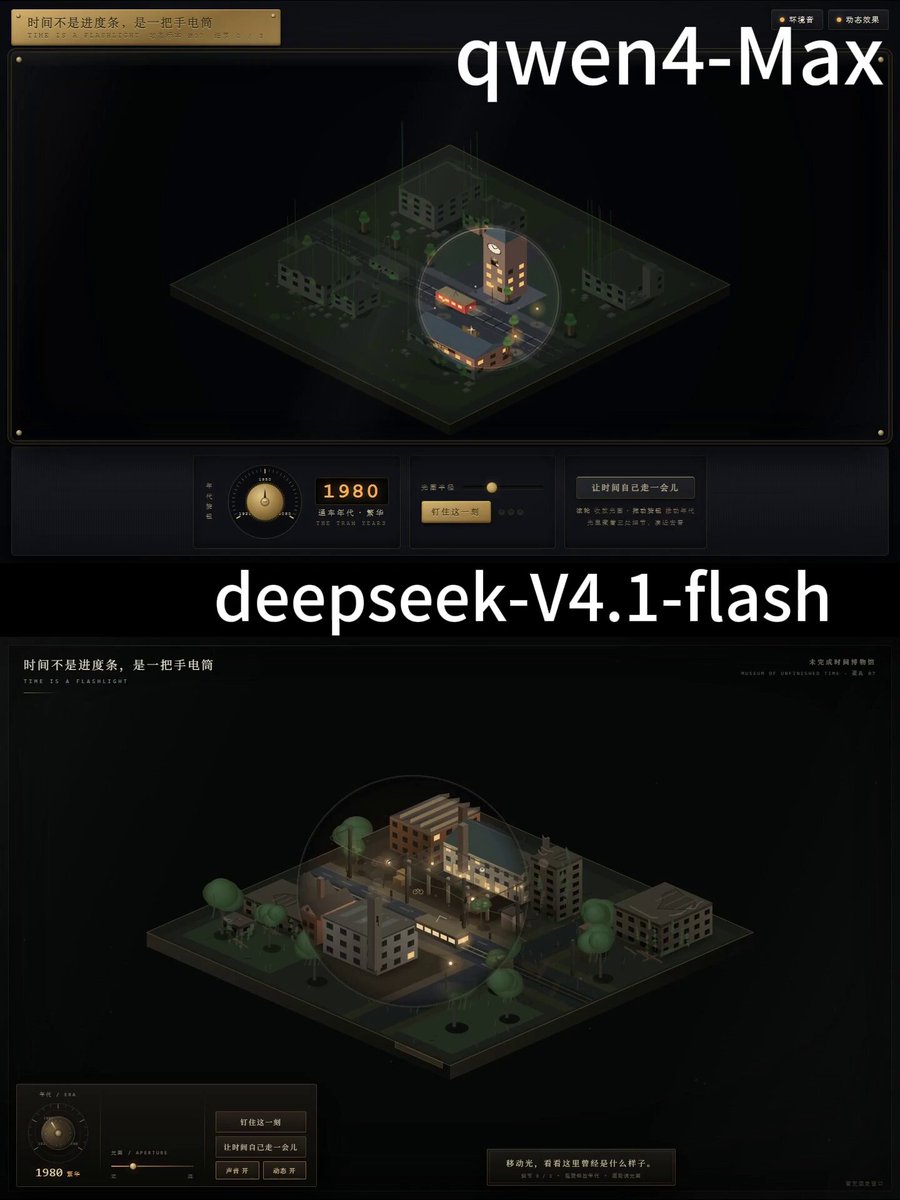
开发者 Densitylucky 给 Qwen4-Max 和 DeepSeek V4.1 Flash 相同的任务:制作一座封在展柜里的交互式微缩城市。
鼠标是一束「时间手电筒」。用户移动鼠标时,可以看到光圈内的城市在 1920、1980 或 2080 年的样子。
建筑在不同年代要保持位置对齐,用户还可以固定时间窗口,在同一幅地图上对比多个时代的变化。
两款模型都完成了光圈内建筑随年代变化的交互。Qwen4-Max 的演示还展示了同时固定多个年代窗口的功能。
作者记录的完成时间是:
| 模型 | 用时 |
|---|---|
| Qwen4-Max | 13 分 31 秒 |
| DeepSeek V4.1 Flash | 44 分 55 秒 |
Qwen4-Max 在这一轮任务中快了 31 分 24 秒。
不过,作者没有公布两款模型的完整推理设置、API 账单或逐项验收结果,因此不能把这一轮计时当作普遍的速度结论。
2. Arena 并排测试:Qwen4-Max 与 GPT、Claude 的前端设计差异
Arena 的 Peter Gostev 展示了一组模型生成的实际作品,包括体素罗马、3D 场景、小游戏和交互网页。
其中,赛车赛事页面的对照比较直观。
Qwen4-Max 将赛道、赛事数据和车手列表排列成紧凑的赛事控制台,页面信息密度较高。GPT-6.1 Sol 则给赛道图留出了更大的版面,视觉中心更集中。
两种设计都完成了页面的主要内容,但布局选择不同。
这个案例无法单独证明哪款模型更强,却可以帮助开发者判断哪种输出更符合自己的项目需求。
想直接比较成品,可以从视频 13:36 的网页设计部分开始,再看 15:47 的网页与可用性对照。
3. Simon Willison 测试:xhigh 比 high 慢了近 6 分钟
开发者 Simon Willison 使用 OpenRouter,让 Qwen4-Max 在不同推理档位下完成同一句提示词:
Generate an SVG of a pelican riding a bicycle任务要求模型生成一张骑自行车的鹈鹕 SVG 图像。
四种推理设置的结果如下:
| 推理设置 | 耗时 | 输出 Token(含推理) |
|---|---|---|
| 关闭推理 | 1 分 01 秒 | 3,766 |
| low | 1 分 31 秒 | 5,702 |
| high | 1 分 37 秒 | 6,362 |
| `xhigh` | 7 分 23 秒 | 26,295 |
xhigh 版本加入了更多细节,包括蓝绿色自行车、红围巾和露出尾巴的鱼。但它的耗时约为 high 的 4.5 倍,输出 Token 约为 4.1 倍。
Willison 也使用 Qwen3.8-Max 完成了同一道题。他整体更喜欢 Qwen4-Max 的输出,但只比较 xhigh 版本时,他反而更喜欢上一代生成的作品。
这个测试提醒开发者,推理档位并不是越高越好。增加推理 Token 可能改善细节,但也会增加延迟和费用,并不保证每次都得到更好的结果。
Qwen4-Max 比 Qwen3.8-Max 便宜多少?
Qwen4-Max 的变化除了性能提升,还有每次任务的平均成本下降。
Artificial Analysis 使用 xhigh 评测两代模型,得到以下结果:
| 指标 | Qwen3.8-Max | Qwen4-Max |
|---|---|---|
| 综合能力指数 | 34 | 43 |
| 平均任务成本 | US$10.02 | US$3.27 |
| 平均输出 Token/任务 | 约 17.1 万 | 约 10.5 万 |
按照这组测试,平均任务成本下降约 67%。
单价下降是一部分原因,Token 消耗减少也是重要因素。两代模型完成的是同一套评测,新模型在完成任务时平均使用了更少的输出 Token。
阿里自己的 Work360 测试也观察到类似趋势。
Qwen4-Max 得分从上一代的 47.74 提升至 52.69,平均任务成本由 US$4.43 降至 US$1.67,降幅约为 62%。
不过,Work360 是阿里公布的内部测试,与 Artificial Analysis 的任务集和评测条件不同,不能将两套成本数字直接混用。

对于真实开发任务,更适合记录的是一次通过验收的总费用,包括第一次生成、重新执行、修复错误和必要的人工干预。
Qwen4-Max 怎么用?在哪里可以试?
千问公布的入口包括 Qwen Studio、QwenWork 和 Qoder。
如果只想体验模型的文本与编程能力,可以先在官方产品中试用。如果需要把它接入自己的应用或 Agent 系统,可以通过阿里云百炼或 OpenRouter 调用 API。
- Qwen Studio · 在线体验千问模型
- QwenWork · 千问工作场景入口
- Qoder · AI 编程开发工具
- 阿里云百炼 · API,模型 ID 为
qwen4-max - OpenRouter · API,模型 ID 为
qwen/qwen4-max
正式版支持 OpenAI Chat Completions、Responses、Anthropic Messages 和 DashScope 接口,也支持工具调用、并行工具调用和 JSON 结构化输出。
此前的 qwen4-max-preview 属于预览型号,通过 Token Plan 提供;正式版 qwen4-max 已支持按量计费。使用 API 时,应确认选择的是正式版模型 ID。
Qwen4-Max API 价格
不同地域和部署范围的百炼 API 价格有所区别。
以下是截至 2026 年 11 月 16 日核对的公开标准价格,单位为每百万 Token:
| 百炼地域与部署范围 | 输入 | 输出 | 缓存命中 |
|---|---|---|---|
| 美国弗吉尼亚 · 全球部署 | US$1.413 | US$4.24 | US$0.071 |
| 新加坡 · 国际部署 | US$1.50 | US$4.50 | US$0.075 |
| 中国北京 · 中国内地部署 | ¥10 | ¥30 | ¥0.50 |
思考 Token 计入输出费用。表中缓存命中价格不等于缓存创建价格,显式缓存创建会另行计费。
与同部署范围的 Qwen3.8-Max 比较,Qwen4-Max 在弗吉尼亚的标准输入和输出单价各降低约 14.4%,在新加坡各降低 25%。
调用 API 时需要注意什么?
Qwen4-Max 支持最长 100 万 Token 上下文,适合输入长文档和大型任务背景。但能够接收长上下文,不代表模型必然能够准确引用其中每一处信息。
此外,推理档位会影响输出 Token、耗时和费用。开发者不应该直接把所有任务设成 xhigh。
如果通过百炼接入,先创建对应地域的 API Key,再按照该地域的 API 文档配置访问地址,将模型 ID 设置为 qwen4-max。
如果使用 OpenRouter,模型 ID 则是 qwen/qwen4-max,其模型页面还提供各档推理设置与具体计价说明。
Qwen4-Max 现在值得使用吗?
如果你主要做前端原型、交互网页或有明确验收条件的开发任务,Qwen4-Max 值得加入候选。
比较直接的方式,是拿一张自己熟悉的项目截图,让 Qwen4-Max 和当前使用的模型完成相同任务。先使用 high 推理设置,要求页面满足几项明确条件,例如布局与参考图一致、关键交互有效、窄屏能够正常使用。
之后记录首次通过验收所需的总时间、Token 消耗、重试次数和人工修改量,再决定是否使用更高的推理档位。
如果团队目前主要依靠 Opus 5.5 或 Kimi K3.1 Pro 处理代码库维护、复杂终端任务或长程 Agent 工作流,建议先在高频真实任务上复跑。独立评测中的终端编程和专业任务成绩,还不足以证明 Qwen4-Max 可以全面替代它们。
Qwen4-Max 的首发成绩已经说明,它在多个领域明显超过上一代,尤其是网页开发;API 单价和平均任务消耗也有所下降。至于能否替代现有旗舰模型,仍需要用具体任务的完成率、延迟和总成本来判断。
注:本文整理的是 Qwen4-Max 正式版于 2026 年 11 月 16 日发布时的首发结果。Arena 榜单属于动态排名,部分数据仍为初步结果。Artificial Analysis 和 Vals AI 为独立评测,阿里发布的 Work360、ProgramBench 等对照数据按照厂商披露口径呈现。开发者实测仅代表公开展示的相应任务,不等同于全面性能评估。