Qwen 4(Qwen4)는 Alibaba Qwen 팀의 차세대 대규모 언어 모델입니다. Qwen4-Max는 Qwen4 제품군에서 공식 출시된 첫 플래그십 모델입니다. 2026년 11월 16일 출시된 이 모델은 100만 토큰 컨텍스트 창을 지원하고 텍스트, 이미지, 동영상을 이해하며, 코드 생성, 도구 호출, 구조화된 출력을 통해 여러 단계의 작업을 수행할 수 있습니다.
Qwen4-Max는 Mixture-of-Experts(MoE) 아키텍처를 사용하며, 전체 파라미터는 약 2.4조 개, 토큰당 활성 파라미터는 710억 개입니다. 프리뷰 버전인 qwen4-max-preview는 11월 11일부터 제공되었습니다. 공식 출시와 함께 모델 ID qwen4-max를 사용하는 사용량 기반 API 과금이 도입되었습니다. Alibaba는 더 작은 Qwen4 모델의 가중치도 공개할 계획이라고 발표했습니다.
Qwen 공식 발표 · Alibaba Cloud Model Studio 문서
Qwen4-Max는 얼마나 강력할까요? Claude Opus 5.5와 경쟁할 수 있을까요?
출시 벤치마크를 보면 Qwen4-Max는 특히 웹 개발과 같은 일부 작업에서 주요 프런티어 모델과 경쟁할 수 있습니다. 그러나 전반적인 성능은 Claude Opus 5.5보다는 Kimi K3.1 Pro에 더 가깝습니다. 현재 공개된 결과만으로는 Opus 5.5를 완전히 대체할 모델로 보기는 어렵습니다.
Artificial Analysis의 독립적인 Intelligence Index에서 Qwen4-Max는 43점을 기록했습니다. Qwen3.8-Max의 34점에서 상승했으며 Kimi K3.1 Pro의 46점에 근접했습니다. Claude Opus 5.5는 59점을 기록했습니다.
웹 개발에서는 격차가 더 작습니다. Qwen4-Max는 1,750 Elo를 기록하며 WebDev Arena에서 처음 6위에 올랐고 Opus 5.5는 1,816 Elo로 2위를 기록했습니다.
이 결과를 보면 Qwen4-Max는 프런트엔드 개발용으로 평가해 볼 가치가 있습니다. 복잡한 저장소 단위의 엔지니어링, 장시간 실행되는 터미널 작업, 고난도 전문 추론에서는 이를 대체하기 전에 Opus 5.5, Kimi K3.1 Pro 및 다른 주요 모델과 계속 비교 테스트해야 합니다.
Artificial Analysis · WebDev Arena
Qwen4-Max 벤치마크: Qwen3.8-Max보다 얼마나 나아졌을까?
Qwen4-Max의 초기 평가는 웹 개발, 소프트웨어 엔지니어링, 에이전트 워크플로, 전문 지식, 멀티모달 이해를 다룹니다.
기관마다 사용하는 벤치마크 모음과 추론 설정이 다르므로 점수를 직접 비교해서는 안 됩니다.
다음 표에서는 Artificial Analysis, Arena, Vals AI의 독립적인 결과를 우선적으로 제시합니다. 세 기관 모두 공식 출시 버전을 평가했으며, 주로 xhigh 추론 설정을 사용했습니다.
| 벤치마크 | Qwen4-Max | 비교 대상 |
|---|---|---|
| Artificial Analysis Intelligence Index | 43 | Qwen3.8-Max: 34; Kimi K3.1 Pro: 46; Opus 5.5: 59 |
| WebDev Arena | 1,750 Elo, #6 | Qwen3.8-Max: 1,676; Opus 5.5: 1,816 |
| Image-to-WebDev | 1,674 Elo, #6 | Qwen3.8-Max: 1,639 |
| Vals Index v2.2 | 63.20%, #11/38 | Qwen3.8-Max: 59.05%; Kimi K3.1 Pro: 62.52% |
| Vibe Code Bench v1.1 | 86.66%; 애플리케이션 50개 중 21개가 모든 테스트 통과 | Qwen3.8-Max: 16/50 |
| Terminal-Bench 4.0 | 약 48.5% | Qwen3.8-Max: 38.9%; Kimi K3.1 Pro: 약 67% |
| AA-Briefcase v1.1 | 1,686 Elo | Qwen3.8-Max: 1,604; Opus 5.5: 1,801 |
| AutomationBench-AA | 약 73% | Qwen3.8-Max: 56%; Opus 5.5: 70% |
| Finance Agent v2.1 | 66.68% | Vals AI 기준 #8 |
| Tax Agent Bench | 40.35% | Qwen3.8-Max: 49.7% |
| Legal Research Bench | 41.35% | Qwen3.8-Max: 46.2% |
Arena 순위는 출시 초기 결과이며 더 많은 투표가 수집되면 바뀔 수 있습니다. Vals AI 순위는 당시 이용 가능한 모델 페이지 데이터를 반영하며, 리더보드 규모는 시간에 따라 달라질 수 있습니다.
Artificial Analysis 결과 · Vals AI 모델 페이지 · WebDev Arena 리더보드
웹 개발은 Qwen4-Max의 가장 강력한 분야 중 하나입니다
Qwen4-Max는 WebDev Arena에서 이전 모델보다 74 Elo 향상되었습니다. 또한 스크린샷을 기능하는 웹 페이지로 얼마나 잘 변환하는지 평가하는 Image-to-WebDev 벤치마크에서도 더 나은 성능을 보였습니다.
Vals AI는 두 세대의 모델을 웹 애플리케이션 개발 작업 50개로 테스트했습니다. Qwen4-Max는 애플리케이션 21개에서 모든 테스트를 통과했으며, Qwen3.8-Max는 16개였습니다.
두 평가 모두 프런트엔드 생성과 인터랙티브 애플리케이션 개발에서 의미 있는 개선을 보여 줍니다.
그러나 Qwen4-Max의 1,750 Elo와 Opus 5.5의 1,816 Elo 사이의 격차는 여전히 무시하기 어렵습니다. 시각적 품질, 기능적 정확성, 기존 프로젝트를 여러 차례 반복 수정하는 능력도 별도로 평가해야 합니다.
복잡한 코딩과 전문 작업에서는 여전히 약점을 보입니다
Terminal-Bench 4.0에서 Qwen4-Max는 약 48.5%를 기록했습니다. Qwen3.8-Max의 38.9%보다 향상되었지만 Kimi K3.1 Pro의 약 67%에는 미치지 못했습니다.
Alibaba가 공개한 소프트웨어 복제 벤치마크 ProgramBench에서 Qwen4-Max는 31.5점을 기록했고, Opus 5.5는 65.0점이었습니다.
Qwen4-Max는 일부 소프트웨어 엔지니어링 벤치마크에서 경쟁력 있는 성능을 보였지만, 이 결과는 복잡하고 장시간 이어지는 코딩 작업에서 여전히 상당한 격차가 있음을 보여 줍니다.
전문 분야 벤치마크에서도 결과는 엇갈립니다.
Vals AI는 Finance Agent v2.1에서 66.68%를 기록했다고 보고했습니다. 그러나 Tax Agent Bench 점수는 이전 세대의 49.7%에서 40.35%로 하락했고, Legal Research Bench도 46.2%에서 41.35%로 떨어졌습니다.
따라서 금융, 세무 또는 법률 업무에 AI 모델을 도입하려는 기업은 전체 지능 순위에만 의존하기보다 작업별 결과를 우선적으로 살펴봐야 합니다.
Vals AI 상세 결과 · Qwen이 공개한 벤치마크 비교

세 가지 실제 테스트: Qwen4-Max는 실제로 무엇을 만들 수 있을까?
벤치마크 점수를 넘어, 개발자들은 이미 공식 모델을 사용한 실행 로그와 작동 사례를 공개했습니다.
다음 세 가지 테스트는 웹 애플리케이션 생성, 모델 간 디자인 차이, 추론 설정이 속도와 토큰 사용량에 미치는 영향을 보여 줍니다.
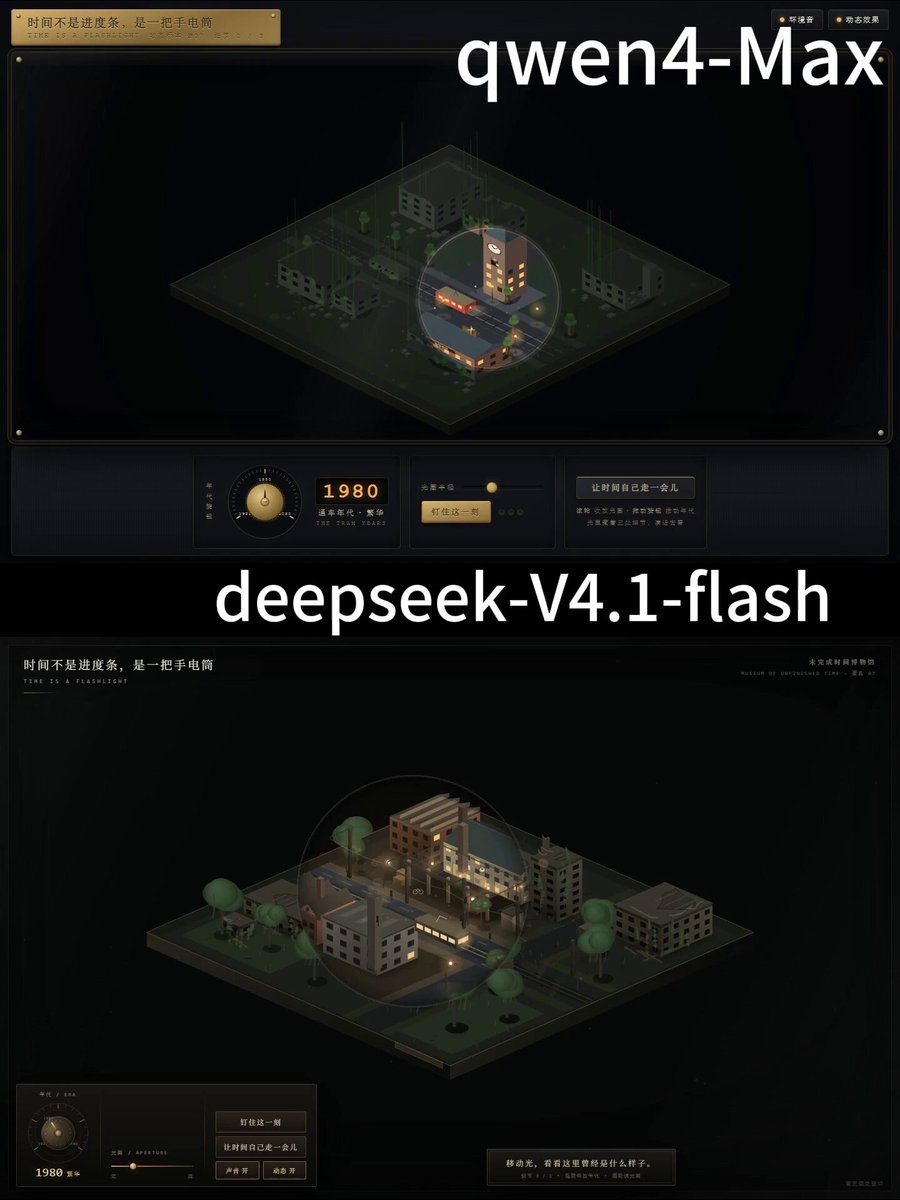
1. 동일한 웹 개발 작업: Qwen4-Max가 DeepSeek V4.1 Flash보다 31분 24초 먼저 완료
개발자 Densitylucky는 Qwen4-Max와 DeepSeek V4.1 Flash에 유리 케이스 안에 표시되는 인터랙티브 미니어처 도시를 만들라는 동일한 작업을 맡겼습니다.
마우스 커서는 '시간 손전등'처럼 작동합니다. 장면 위로 커서를 움직이면 도시의 각 부분이 1920년, 1980년 또는 2080년에 어떤 모습일지 보여 줍니다.
서로 다른 시대를 비교해도 건물의 위치가 맞아야 합니다. 또한 사용자는 여러 시간 구간을 고정하고 동일한 지도에서 서로 다른 시기를 비교할 수 있어야 합니다.
두 모델 모두 선택한 시대에 따라 건물이 바뀌는 작동하는 데모를 만들었습니다.
Qwen4-Max 데모에서는 여러 개의 고정된 시간 구간을 동시에 표시하는 기능도 확인할 수 있었습니다.
개발자가 보고한 완료 시간은 다음과 같습니다:
| 모델 | 완료 시간 |
|---|---|
| Qwen4-Max | 13분 31초 |
| DeepSeek V4.1 Flash | 44분 55초 |
이번 테스트에서 Qwen4-Max는 31분 24초 먼저 완료했습니다.
그러나 개발자는 두 모델의 전체 추론 설정, API 비용 또는 항목별 승인 테스트 결과를 공개하지 않았습니다. 따라서 이 시간만으로 일반적인 상대 속도를 판단해서는 안 됩니다.
2. Arena 나란히 비교 테스트: Qwen4-Max, GPT, Claude의 디자인 차이
Arena의 Peter Gostev는 복셀 스타일의 로마 도시, 3D 장면, 소규모 게임, 인터랙티브 웹사이트 등 모델이 생성한 프로젝트 모음을 공개했습니다.
특히 유용한 사례 중 하나는 레이싱 이벤트 대시보드입니다.
Qwen4-Max는 트랙, 레이스 통계, 드라이버 목록을 작고 정보 밀도 높은 제어 패널에 배치했습니다.
GPT-6.1 Sol은 트랙 시각화에 더 많은 공간을 할당해 이를 핵심 시각 요소로 만들었습니다.
두 디자인 모두 주요 요구사항을 충족했지만 레이아웃을 구성한 방식은 서로 달랐습니다.
이 비교만으로 어느 모델이든 모든 상황에서 더 낫다고 결론 내릴 수는 없습니다. 다만 개발자가 자신의 요구사항에 더 잘 맞는 모델의 디자인 선택을 평가하는 데는 도움이 됩니다.
결과를 직접 확인하려면 동영상의 13:36 웹사이트 디자인 부분부터 시작해 15:47 웹 사용성 비교 부분까지 이어서 확인하세요.
3. Simon Willison의 테스트: xhigh 설정은 high보다 거의 6분 더 오래 걸렸습니다
개발자 Simon Willison은 OpenRouter를 통해 네 가지 추론 설정과 동일한 프롬프트로 Qwen4-Max를 테스트했습니다:
Generate an SVG of a pelican riding a bicycle작업은 자전거를 타는 펠리컨의 SVG 일러스트를 생성하는 것이었습니다.
결과는 다음과 같습니다:
| 추론 설정 | 시간 | 출력 토큰(추론 포함) |
|---|---|---|
| 사용 안 함 | 1분 01초 | 3,766 |
| low | 1분 31초 | 5,702 |
| high | 1분 37초 | 6,362 |
| xhigh | 7분 23초 | 26,295 |
추론 설정을 xhigh로 지정한 결과에는 청록색 자전거, 빨간 스카프, 꼬리가 튀어나온 물고기 등 추가적인 시각적 세부사항이 포함되었습니다.
하지만 high 설정보다 약 4.5배 오래 걸렸고, 출력 토큰도 약 4.1배 더 많이 사용했습니다.
Willison은 같은 프롬프트로 Qwen3.8-Max도 테스트했습니다.
그는 대체로 Qwen4-Max의 결과를 더 높이 평가했지만, xhigh 출력만 비교했을 때는 이전 세대 모델이 만든 일러스트를 더 선호했습니다.
이 테스트는 추론 설정이 높다고 해서 항상 더 나은 것은 아닌 이유를 보여줍니다. 추론 토큰을 추가하면 세부 사항이 개선될 수 있지만, 매번 더 나은 결과를 보장하지 않는 동시에 지연 시간과 비용도 늘어납니다.
Qwen4-Max는 Qwen3.8-Max보다 얼마나 저렴한가?
Qwen4-Max는 성능 향상뿐 아니라 벤치마크 작업을 완료하는 평균 비용도 크게 낮췄습니다.
Artificial Analysis는 두 세대를 xhigh 추론 설정으로 평가하고 다음 결과를 보고했습니다:
| 측정 항목 | Qwen3.8-Max | Qwen4-Max |
|---|---|---|
| Intelligence Index | 34 | 43 |
| 작업당 평균 비용 | US$10.02 | US$3.27 |
| 작업당 평균 출력 토큰 | 약 171,000 | 약 105,000 |
이 벤치마크에서 작업당 평균 비용은 약 67% 감소했습니다.
API 가격 인하가 비용 감소의 일부를 설명합니다. 최신 모델은 동일한 벤치마크 모음을 완료하는 데 평균적으로 더 적은 출력 토큰도 사용했습니다.
Alibaba도 내부 Work360 평가에서 비슷한 추세를 확인했습니다.
Qwen4-Max는 점수를 47.74에서 52.69로 높였고, 작업당 평균 비용은 US$4.43에서 US$1.67로 낮아져 약 62% 감소했습니다.
하지만 Work360은 공급업체가 보고한 평가입니다. 작업, 구성, 가격 책정 가정이 Artificial Analysis에서 사용한 것과 다르므로 두 비용 수치를 합산해서는 안 됩니다.
Qwen Work360 비용 결과 · Work360 벤치마크 점수

실제 개발 워크플로에서는 초기 생성, 재시도, 디버깅, 필요한 사람의 개입을 포함해 승인된 결과에 도달하는 데 드는 총비용이 더 유용한 지표입니다.
Qwen4-Max 사용 방법: 어디에서 사용해 볼 수 있을까?
Alibaba는 Qwen4-Max에 액세스하는 방법으로 Qwen Studio, QwenWork, Qoder를 안내합니다.
텍스트 생성이나 코딩 기능을 간단히 사용해 보고 싶다면 공식 제품 중 하나로 시작하면 됩니다.
모델을 애플리케이션이나 에이전트 시스템에 통합해야 하는 개발자는 Alibaba Cloud Model Studio 또는 OpenRouter를 사용할 수 있습니다.
- Qwen Studio · 온라인에서 Qwen 모델 사용해 보기
- QwenWork · Qwen의 업무 중심 AI 경험
- Qoder · AI 기반 소프트웨어 개발
- Alibaba Cloud Model Studio · API 모델 ID:
qwen4-max - OpenRouter · API 모델 ID:
qwen/qwen4-max
공식 Qwen4-Max 릴리스는 OpenAI Chat Completions, Responses, Anthropic Messages 및 DashScope 인터페이스를 지원합니다.
또한 도구 호출, 병렬 도구 호출, 구조화된 JSON 출력을 지원합니다.
이전에 제공된 qwen4-max-preview 모델은 Token Plan을 통해 제공되었습니다. 공식 qwen4-max 모델은 이제 사용량 기반 API 결제를 지원합니다.
모델을 통합할 때는 프리뷰 모델이 아닌 공식 릴리스를 선택해야 합니다.
Qwen4-Max API 가격
Alibaba Cloud Model Studio의 가격은 배포 지역에 따라 달라집니다.
다음 표는 2026년 11월 16일에 확인한 공개 표준 요금을 보여줍니다. 모든 가격은 토큰 100만 개당 기준입니다.
| 지역 및 배포 범위 | 입력 | 출력 | 캐시 적중 |
|---|---|---|---|
| 미국 버지니아 — 글로벌 배포 | US$1.413 | US$4.24 | US$0.071 |
| 싱가포르 — 국제 배포 | US$1.50 | US$4.50 | US$0.075 |
| 베이징 — 중국 본토 배포 | ¥10 | ¥30 | ¥0.50 |
추론 토큰은 출력 토큰으로 과금됩니다.
위에 표시된 캐시 적중 가격은 캐시 생성 가격과 다릅니다. 캐시를 명시적으로 생성하면 별도로 과금될 수 있습니다.
같은 배포 지역의 Qwen3.8-Max와 비교하면 Qwen4-Max의 표준 입력 및 출력 토큰 가격은 버지니아에서 약 14.4%, 싱가포르에서 25% 낮습니다.
Alibaba Cloud 국제 가격 · 중국 본토 가격
API를 사용하기 전에 개발자가 알아야 할 사항은?
Qwen4-Max는 최대 100만 토큰의 컨텍스트 창을 지원하므로 긴 문서나 대규모 프로젝트 컨텍스트를 다루는 작업에 적합합니다.
하지만 긴 컨텍스트를 받아들일 수 있다고 해서 모델이 그 안의 모든 세부 사항을 정확하게 검색하거나 참조할 수 있다는 보장은 없습니다.
추론 설정은 출력 토큰 사용량, 지연 시간, 비용에도 영향을 줍니다. 개발자는 모든 작업에 자동으로 xhigh를 사용해서는 안 됩니다.
Alibaba Cloud Model Studio를 통해 Qwen4-Max를 통합하려면 적절한 지역에 API 키를 만들고, 해당 API 엔드포인트를 구성한 다음 모델 ID를 qwen4-max로 설정하세요.
OpenRouter를 사용할 때 모델 ID는 qwen/qwen4-max입니다. 모델 페이지에서는 추론 구성과 가격에 관한 정보도 제공합니다.
Qwen4-Max를 사용할 가치가 있을까?
작업에 프론트엔드 프로토타입, 인터랙티브 웹사이트 또는 명확한 승인 기준이 있는 개발 작업이 포함된다면, Qwen4-Max를 테스트해 볼 가치가 있습니다.
실용적인 평가는 잘 아는 프로젝트의 스크린샷을 가져와 Qwen4-Max와 현재 사용 중인 모델에 같은 작업을 맡기는 것입니다.
먼저 high 추론 설정으로 시작하고 몇 가지 구체적인 승인 기준을 정하세요:
- 레이아웃은 참조 화면과 최대한 비슷해야 합니다.
- 핵심 인터랙티브 기능이 올바르게 작동해야 합니다.
- 좁은 화면에서도 페이지를 사용할 수 있어야 합니다.
그런 다음 이러한 기준을 통과하는 데 필요한 총 시간, 토큰 사용량, 재시도 횟수, 수동 변경 사항을 기록하세요.
추가 비용이 의미 있는 개선으로 이어질 때만 추론 설정을 높이세요.
현재 팀이 저장소 유지 관리, 복잡한 터미널 작업 또는 장시간 실행되는 에이전트 워크플로에 Opus 5.5나 Kimi K3.1 Pro를 사용하고 있다면, 마이그레이션하기 전에 가장 자주 수행하는 실제 작업으로 Qwen4-Max를 테스트하세요.
터미널 프로그래밍과 전문 워크플로에 대한 독립적인 벤치마크 결과만으로는 아직 이 모델이 해당 모델들을 완전히 대체할 수 있다고 입증하기 어렵습니다.
출시 결과는 여러 영역, 특히 웹 개발에서 Qwen3.8-Max보다 크게 향상되었음을 보여줍니다. API 가격과 작업당 평균 비용도 낮아졌습니다.
Qwen4-Max가 기존 최첨단 모델을 대체해야 하는지는 결국 실제 워크로드에서의 작업 완료율, 지연 시간, 총비용에 달려 있습니다.
참고: 이 글은 2026년 11월 16일 공식 Qwen4-Max 출시를 전후해 공개된 초기 결과를 요약합니다. Arena 순위는 변동되며 일부 결과는 아직 예비적입니다. Artificial Analysis와 Vals AI는 독립적인 평가를 제공하고, Work360, ProgramBench 및 Alibaba가 공개한 기타 결과는 공급업체 보고 벤치마크로 표시되어 있습니다. 개별 개발자 테스트는 특정 작업에서의 성능을 보여주는 것이므로 종합적인 모델 평가로 간주해서는 안 됩니다.