Qwen 4(Qwen4)是阿里巴巴 Qwen 團隊推出的新一代大型語言模型。 Qwen4-Max 是 Qwen4 系列中首個正式發布的旗艦模型。 於 2026 年 11 月 16 日發布,支援 100 萬 token 的上下文視窗,能理解文字、圖片與影片,並透過程式碼生成、工具呼叫和結構化輸出執行多步驟任務。
Qwen4-Max 採用混合專家(MoE)架構,總參數量約 2.4 兆,每個 token 啟用 710 億個參數。其預覽版本qwen4-max-preview於 11 月 11 日開放使用。正式版本以模型 ID qwen4-max 導入按用量計費的 API。阿里巴巴也宣布計畫發布較小型 Qwen4 模型的權重。
Qwen 官方公告 · Alibaba Cloud Model Studio 文件
Qwen4-Max 的實力如何?它能與 Claude Opus 5.5 競爭嗎?
根據發布時的基準測試,Qwen4-Max 在某些任務上具備與頂尖前沿模型競爭的實力,尤其是在網頁開發方面。不過,它的整體表現更接近 Kimi K3.1 Pro,而非 Claude Opus 5.5。現有結果不足以支持將它視為 Opus 5.5 的完整替代品。
在 Artificial Analysis 的獨立 Intelligence Index 中,Qwen4-Max 得分 43,高於 Qwen3.8-Max 的 34 分,接近 Kimi K3.1 Pro 的 46 分。Claude Opus 5.5 得分 59 分。
在網頁開發方面,差距較小。Qwen4-Max 達到 1,750 Elo,在 WebDev Arena 初始排名第六;Opus 5.5 則為 1,816 Elo,排名第二。
這些結果顯示,Qwen4-Max 值得用於前端開發評估。至於複雜的程式庫層級工程、長時間執行的終端機任務,或要求較高的專業推理,在取代 Opus 5.5、Kimi K3.1 Pro 和其他頂尖模型之前,仍應先進行測試。
Artificial Analysis · WebDev Arena
Qwen4-Max 基準測試:它比 Qwen3.8-Max 好多少?
Qwen4-Max 的初步評估涵蓋網頁開發、軟體工程、代理程式工作流程、專業知識與多模態理解。
不同組織採用不同的基準測試套件與推理設定,因此不應直接比較它們的分數。
下表優先採用 Artificial Analysis、Arena 與 Vals AI 的獨立結果。這三個組織都發布了對正式版本的評估,主要使用 xhigh 推理設定。
| 基準測試 | Qwen4-Max | 比較結果 |
|---|---|---|
| Artificial Analysis Intelligence Index | 43 | Qwen3.8-Max:34;Kimi K3.1 Pro:46;Opus 5.5:59 |
| WebDev Arena | 1,750 Elo,第 6 名 | Qwen3.8-Max:1,676;Opus 5.5:1,816 |
| Image-to-WebDev | 1,674 Elo,第 6 名 | Qwen3.8-Max:1,639 |
| Vals Index v2.2 | 63.20%, #11/38 | Qwen3.8-Max:59.05%;Kimi K3.1 Pro:62.52% |
| Vibe Code Bench v1.1 | 86.66%;50 個應用程式中有 21 個通過所有測試 | Qwen3.8-Max:16/50 |
| Terminal-Bench 4.0 | 約 48.5% | Qwen3.8-Max:38.9%;Kimi K3.1 Pro:約 67% |
| AA-Briefcase v1.1 | 1,686 Elo | Qwen3.8-Max:1,604;Opus 5.5:1,801 |
| AutomationBench-AA | 約 73% | Qwen3.8-Max:56%;Opus 5.5:70% |
| Finance Agent v2.1 | 66.68% | 由 Vals AI 排名第 8 |
| Tax Agent Bench | 40.35% | Qwen3.8-Max:49.7% |
| Legal Research Bench | 41.35% | Qwen3.8-Max:46.2% |
Arena 排名是發布初期的結果,可能會隨著收集到更多票數而變動。Vals AI 排名反映當時可取得的模型頁面資料;排行榜規模可能隨時間改變。
Artificial Analysis 結果 · Vals AI 模型頁面 · WebDev Arena 排行榜
網頁開發是它最強的領域之一
Qwen4-Max 在 WebDev Arena 上比前一代提升了 74 Elo。在 Image-to-WebDev 基準測試中,它的表現也更好;該測試評估模型將截圖轉換成可運作網頁的能力。
Vals AI 以 50 項網頁應用程式開發任務測試了兩代模型。Qwen4-Max 在 21 個應用程式中通過所有測試,相較之下 Qwen3.8-Max 為 16 個。
兩項評估都顯示,前端生成與互動式應用程式開發有明顯進步。
不過,Qwen4-Max 的 1,750 Elo 與 Opus 5.5 的 1,816 Elo 之間仍有足以影響結果的明顯差距。視覺品質、功能正確性,以及多次迭代修改現有專案的能力,也應分開評估。
複雜的程式設計與專業任務仍較弱
在 Terminal-Bench 4.0 上,Qwen4-Max 得分約 48.5%,高於 Qwen3.8-Max 的 38.9%,但仍低於 Kimi K3.1 Pro 約 67% 的成績。
在阿里巴巴發布的 ProgramBench 軟體複製基準測試中,Qwen4-Max 得分 31.5,相較之下 Opus 5.5 為 65.0。
雖然 Qwen4-Max 在部分軟體工程基準測試中具備競爭力,但這項結果顯示,它在複雜且長時間的程式設計任務上仍有顯著差距。
專業領域的基準測試也呈現混合結果。
Vals AI 回報 Finance Agent v2.1 的得分為 66.68%。不過,Tax Agent Bench 的得分從前一代的 49.7% 降至 40.35%,Legal Research Bench 也從 46.2% 降至 41.35%。
因此,評估金融、稅務或法律工作的公司,應優先參考特定任務的結果,而不是完全依賴整體智慧排名。

三項實測:Qwen4-Max 實際能打造什麼?
除了基準測試分數,開發者也已發布使用正式模型的執行記錄與可運作範例。
以下三項測試展示網頁應用程式生成、模型之間的設計差異,以及推理設定對速度與 token 消耗的影響。
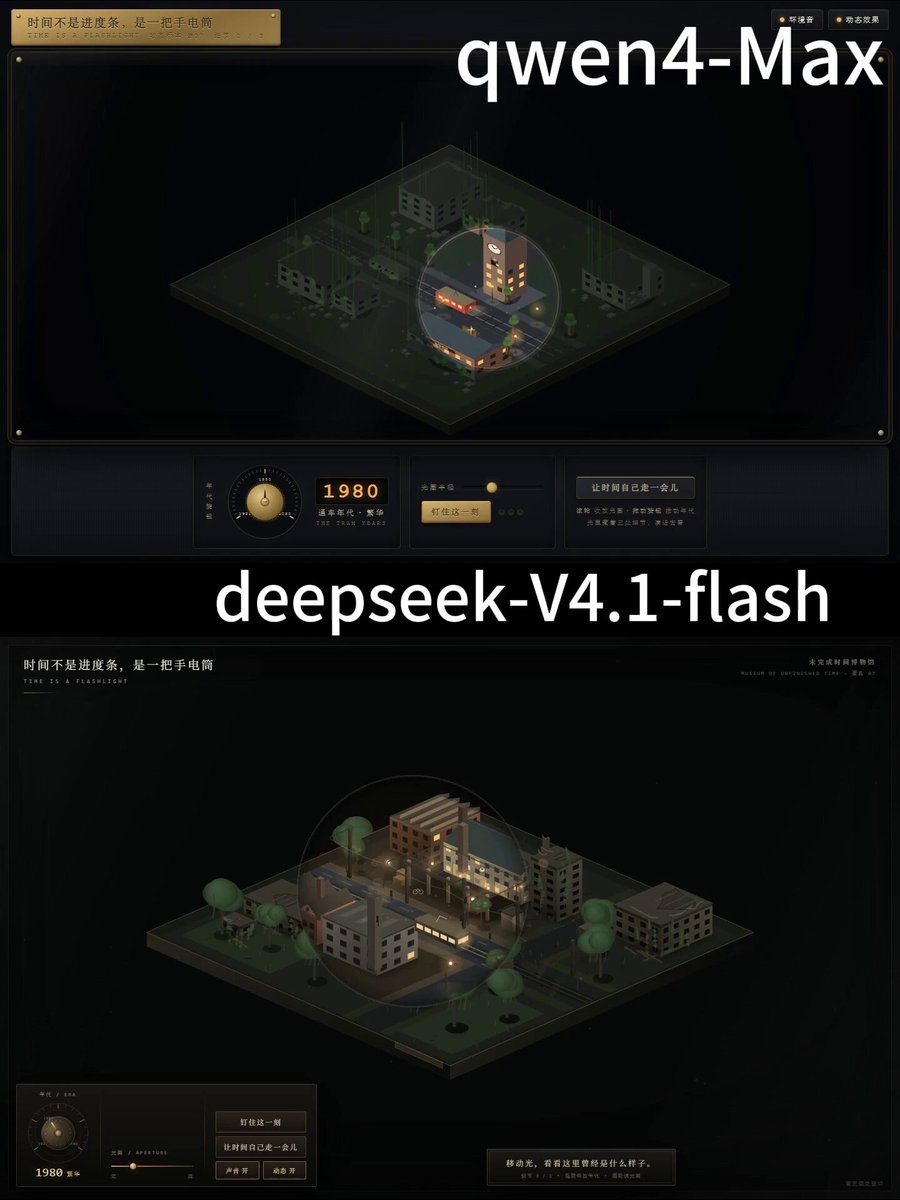
1. 相同網頁開發任務:Qwen4-Max 比 DeepSeek V4.1 Flash 提前 31 分 24 秒完成
開發者 Densitylucky 給 Qwen4-Max 與 DeepSeek V4.1 Flash 相同的任務:打造一座顯示在玻璃盒中的互動式迷你城市。
滑鼠游標就像一支「時間手電筒」。將游標移過場景,就能顯示城市不同區域在 1920 年、1980 年或 2080 年的樣貌。
建築物在不同年代之間必須保持對齊。使用者也必須能釘選多個時間視窗,並在同一張地圖上比較不同時期。
兩個模型都產生了可運作的展示,建築物會依照選定的年代變化。
Qwen4-Max 的展示還額外同時顯示了多個釘選的時間視窗。
開發者回報的完成時間如下:
| 模型 | 完成時間 |
|---|---|
| Qwen4-Max | 13 分 31 秒 |
| DeepSeek V4.1 Flash | 44 分 55 秒 |
Qwen4-Max 提前 31 分 24 秒 完成這項特定測試。
不過,開發者沒有公開任一模型的完整推理設定、API 成本或逐項驗收測試結果。這些時間不應被解讀為整體相對速度的衡量。
2. Arena 並排測試:Qwen4-Max、GPT 與 Claude 的設計差異
Arena 的 Peter Gostev 發布了一系列模型生成的專案,包括體素風格的羅馬城市、3D 場景、小型遊戲與互動式網站。
其中一個特別實用的範例是賽車活動儀表板。
Qwen4-Max 將賽道、比賽統計資料與車手清單安排在一個精簡且資訊密集的控制面板中。
GPT-6.1 Sol 為賽道視覺化配置更多空間,讓它成為主要的視覺元素。
兩種設計都滿足了主要要求,但版面配置決策有所不同。
這項比較無法證明任何一個模型在所有情況下都更好。不過,它能幫助開發者評估哪個模型的設計選擇更符合自己的需求。
若要直接查看結果,請先從影片中的 13:36 網站設計部分開始,接著繼續到 15:47 查看網頁易用性比較。
3. Simon Willison 的測試:xhigh 比 high 多花了近 6 分鐘
開發者 Simon Willison 透過 OpenRouter 使用四種推理設定測試 Qwen4-Max,並採用相同的提示詞:
Generate an SVG of a pelican riding a bicycle任務是生成一幅鵜鶘騎自行車的 SVG 插圖。
結果如下:
| 推理設定 | 時間 | 輸出 token(含推理) |
|---|---|---|
| 停用 | 1 分 01 秒 | 3,766 |
| low | 1 分 31 秒 | 5,702 |
| high | 1 分 37 秒 | 6,362 |
| xhigh | 7 分 23 秒 | 26,295 |
這次 xhigh 輸出包含更多視覺細節,例如藍綠色自行車、紅色圍巾,以及一條尾巴露在外面的魚。
不過,所需時間約為 high 的 4.5 倍,輸出 token 數量也約為 4.1 倍。
Willison 也使用相同的提示詞測試了 Qwen3.8-Max。
他整體而言更偏好 Qwen4-Max 的結果,但若只比較xhigh輸出,他更喜歡前一代模型產生的插圖。
這項測試說明,較高的推理設定不一定更好。增加推理 token 可能改善細節,但也會提高延遲與成本,且不保證每次都能帶來更好的結果。
Qwen4-Max 比 Qwen3.8-Max 便宜多少?
除了效能提升之外,Qwen4-Max 也大幅降低了完成基準測試任務的平均成本。
Artificial Analysis 使用xhigh推理設定評估兩代模型,並公布了以下結果:
| 指標 | Qwen3.8-Max | Qwen4-Max |
|---|---|---|
| Intelligence Index | 34 | 43 |
| 每項任務的平均成本 | US$10.02 | US$3.27 |
| 每項任務的平均輸出 token 數量 | 約 171,000 | 約 105,000 |
在這項基準測試中,每項任務的平均成本約下降了67%。
API 價格較低,是成本下降的部分原因。新模型完成相同的基準測試套件時,平均使用的輸出 token 也較少。
Alibaba 在內部的 Work360 評估中也觀察到類似趨勢。
Qwen4-Max 將分數從 47.74 提升至 52.69;每項任務的平均成本則從US$4.43 降至 US$1.67,約減少 62%。
不過,Work360 是由供應商公布的評估。它的任務、設定與定價假設都不同於 Artificial Analysis 所採用的條件,因此不應將這兩個成本數字合併比較。
Qwen Work360 成本結果 · Work360 基準測試分數

對實際開發流程而言,更有參考價值的指標,是達到可接受結果所需的總成本,包括初次生成、重試、除錯,以及必要的人工介入。
如何使用 Qwen4-Max:可以在哪裡試用?
Alibaba 列出 Qwen Studio、QwenWork 和 Qoder,作為存取 Qwen4 的方式。
如果你只是想試用它的文字生成或程式設計能力,可以先從其中一項官方產品開始。
需要將模型整合至應用程式或代理程式系統的開發者,可以使用 Alibaba Cloud Model Studio 或 OpenRouter。
- Qwen Studio · 線上試用 Qwen 模型
- QwenWork · Qwen 面向工作的 AI 體驗
- Qoder · AI 驅動的軟體開發
- Alibaba Cloud Model Studio · API 模型 ID:
qwen4-max - OpenRouter · API 模型 ID:
qwen/qwen4-max
Qwen4-Max 官方版本支援 OpenAI Chat Completions、Responses、Anthropic Messages 和 DashScope 介面。
它也支援工具呼叫、平行工具呼叫,以及結構化 JSON 輸出。
較早的qwen4-max-preview模型曾透過 Token Plan 提供。官方qwen4-max模型現在支援按用量計費的 API。
整合模型時,請確認選取的是正式版本,而不是預覽模型。
Qwen4-Max API 定價
Alibaba Cloud Model Studio 的價格會因部署區域而異。
下表顯示截至 2026 年 11 月 16 日查詢到的公布標準費率。所有價格均以每百萬 token 計算。
| 區域與部署範圍 | 輸入 | 輸出 | 快取命中 |
|---|---|---|---|
| 美國維吉尼亞州 — 全球部署 | US$1.413 | US$4.24 | US$0.071 |
| 新加坡 — 國際部署 | US$1.50 | US$4.50 | US$0.075 |
| 北京 — 中國大陸部署 | ¥10 | ¥30 | ¥0.50 |
推理 token 會按照輸出 token 計費。
上方顯示的快取命中價格,與快取建立價格不同。明確建立快取可能會另外計費。
與相同部署區域的 Qwen3.8-Max 相比,Qwen4-Max 的標準輸入與輸出 token 價格,在維吉尼亞州約低 14.4%,在新加坡約低 25%。
開發者在使用 API 前應該了解什麼?
Qwen4-Max 支援最高 100 萬 token 的上下文視窗,適合處理長篇文件或大量專案上下文的任務。
不過,能夠接受長上下文,不代表模型就能準確擷取或參照其中的每一項細節。
推理設定也會影響輸出 token 用量、延遲與成本。開發者不應在每項任務中都自動使用xhigh推理設定。
若要透過 Alibaba Cloud Model Studio 整合 Qwen4-Max,請為適用的區域建立 API 金鑰、設定相應的 API 端點,並將模型 ID 設為qwen4-max。
使用 OpenRouter 時,模型 ID 為qwen/qwen4-max。其模型頁面也提供推理設定與定價資訊。
Qwen4-Max 值得使用嗎?
如果你的工作涉及前端原型、互動式網站,或具有明確驗收標準的開發任務,Qwen4-Max 值得測試。
一種實用的評估方式,是從你熟悉的專案中擷取一張螢幕截圖,讓 Qwen4-Max 和你目前使用的模型執行相同任務。
先從high推理設定開始,並定義幾項具體的驗收標準:
- 版面配置應與參考畫面高度相似。
- 必要的互動功能必須正常運作。
- 頁面在窄螢幕上仍必須保持可用。
接著記錄通過這些檢查所需的總時間、token 用量、重試次數與手動修改。
只有在額外成本帶來有意義的改善時,才提高推理設定。
如果你的團隊目前依賴 Opus 5.5 或 Kimi K3.1 Pro 進行儲存庫維護、複雜的終端機操作,或長時間執行的代理程式工作流程,請先用最常見的實際任務測試 Qwen4-Max,再考慮遷移。
它在終端機程式設計與專業工作流程中的獨立基準測試結果,尚不足以證明它能完全取代這些模型。
發布結果顯示,Qwen4-Max 在多個面向都較 Qwen3.8-Max 有大幅改善,尤其是在網頁開發方面。API 價格與每項任務的平均成本也有所下降。
Qwen4-Max 是否應取代現有的前沿模型,最終取決於你實際工作負載下的任務完成率、延遲與總成本。
注意:本文整理了官方 Qwen4-Max 於 2026 年 11 月 16 日發布前後公布的初步結果。Arena 排名會動態變化,部分結果仍屬初步資料。Artificial Analysis 和 Vals AI 提供獨立評估;Work360、ProgramBench 以及 Alibaba 公布的其他結果,均標示為供應商公布的基準測試。個別開發者測試只展示模型在特定任務上的效能,不應視為完整的模型評估。