Qwen 4(Qwen4)は、AlibabaのQwenチームが開発した次世代の大規模言語モデルです。 Qwen4-Maxは、Qwen4ファミリーで初めて正式リリースされたフラッグシップモデルです。 2026年11月16日にリリースされ、100万トークンのコンテキストウィンドウに対応しています。テキスト、画像、動画を理解し、コード生成、ツール呼び出し、構造化出力によって複数ステップのタスクを実行できます。
Qwen4-Maxは、Mixture-of-Experts(MoE)アーキテクチャを採用し、総パラメータ数は約2.4兆、トークンごとのアクティブパラメータ数は710億です。プレビュー版のqwen4-max-previewは11月11日に利用可能になりました。正式リリースでは、モデルIDqwen4-maxによる従量制のAPI課金が導入されました。Alibabaは、より小型のQwen4モデルの重みを公開する計画も発表しています。
Qwen公式発表 · Alibaba Cloud Model Studioのドキュメント
Qwen4-Maxはどれほど強力?Claude Opus 5.5に対抗できる?
ローンチ時のベンチマークによると、Qwen4-Maxは特定のタスク、特にウェブ開発で主要な最先端モデルと競争できる水準です。ただし、総合性能はClaude Opus 5.5よりもKimi K3.1 Proに近い結果でした。公開されている結果から、Opus 5.5を完全に置き換えられるとは言えません。
Artificial Analysisの独立したIntelligence Indexでは、Qwen4-Maxのスコアは43となり、Qwen3.8-Maxの34から上昇しました。Kimi K3.1 Proの46に近い一方、Claude Opus 5.5は59でした。
ウェブ開発では差が縮まります。Qwen4-MaxはWebDev Arenaで1,750 Eloを獲得し、当初は6位でした。これに対し、Opus 5.5は1,816 Eloで2位でした。
これらの結果から、Qwen4-Maxはフロントエンド開発向けに評価する価値があります。ただし、複雑なリポジトリ単位の開発、長時間実行するターミナルタスク、高度な専門的推論では、置き換えを判断する前にOpus 5.5、Kimi K3.1 Pro、その他の主要モデルとも比較テストすべきです。
Artificial Analysis · WebDev Arena
Qwen4-Maxのベンチマーク:Qwen3.8-Maxよりどれほど優れている?
Qwen4-Maxの初期評価は、ウェブ開発、ソフトウェアエンジニアリング、エージェントのワークフロー、専門知識、マルチモーダル理解を対象としています。
組織によって使用するベンチマーク群や推論設定が異なるため、スコアを直接比較することはできません。
以下の表では、Artificial Analysis、Arena、Vals AIによる独立した結果を優先しています。3組織はいずれも正式リリース版を評価しており、主にxhigh推論設定を使用しています。
| ベンチマーク | Qwen4-Max | 比較対象 |
|---|---|---|
| Artificial Analysis Intelligence Index | 43 | Qwen3.8-Max: 34;Kimi K3.1 Pro: 46;Opus 5.5: 59 |
| WebDev Arena | 1,750 Elo、#6 | Qwen3.8-Max: 1,676;Opus 5.5: 1,816 |
| Image-to-WebDev | 1,674 Elo、#6 | Qwen3.8-Max: 1,639 |
| Vals Index v2.2 | 63.20%, #11/38 | Qwen3.8-Max: 59.05%;Kimi K3.1 Pro: 62.52% |
| Vibe Code Bench v1.1 | 86.66%;50アプリ中21件が全テストに合格 | Qwen3.8-Max: 16/50 |
| Terminal-Bench 4.0 | 約48.5% | Qwen3.8-Max: 38.9%;Kimi K3.1 Pro: 約67% |
| AA-Briefcase v1.1 | 1,686 Elo | Qwen3.8-Max: 1,604;Opus 5.5: 1,801 |
| AutomationBench-AA | 約73% | Qwen3.8-Max: 56%;Opus 5.5: 70% |
| Finance Agent v2.1 | 66.68% | Vals AIで#8 |
| Tax Agent Bench | 40.35% | Qwen3.8-Max: 49.7% |
| Legal Research Bench | 41.35% | Qwen3.8-Max: 46.2% |
Arenaのランキングはローンチ時点の暫定結果であり、投票が増えるにつれて変わる可能性があります。Vals AIのランキングは公開されているモデルページのデータを反映しており、リーダーボードの規模は時間とともに変動する場合があります。
Artificial Analysisの結果 · Vals AIのモデルページ · WebDev Arenaのリーダーボード
ウェブ開発は最も得意な分野の一つ
Qwen4-MaxはWebDev Arenaで前世代モデルを74 Elo上回りました。また、スクリーンショットを機能するウェブページに変換する能力を評価するImage-to-WebDevベンチマークでも、より良い結果を出しました。
Vals AIは、50件のウェブアプリ開発タスクで両世代をテストしました。Qwen4-Maxは21アプリで全テストに合格し、Qwen3.8-Maxは16アプリでした。
どちらの評価も、フロントエンド生成とインタラクティブなアプリ開発に意味のある改善があることを示しています。
ただし、Qwen4-Maxの1,750 EloとOpus 5.5の1,816 Eloの差は、依然として無視できない大きさです。視覚的な品質、機能的な正確さ、既存プロジェクトを複数回の反復で変更する能力も、別途評価する必要があります。
複雑なコーディングや専門的なタスクでは依然として弱い
Terminal-Bench 4.0では、Qwen4-Maxのスコアは約48.5%でした。Qwen3.8-Maxの38.9%から改善したものの、Kimi K3.1 Proの約67%には及びません。
Alibabaが公開したソフトウェア再現ベンチマークProgramBenchでは、Qwen4-Maxが31.5、Opus 5.5が65.0でした。
Qwen4-Maxは一部のソフトウェアエンジニアリングベンチマークで競争力を示していますが、この結果は、複雑で長時間に及ぶコーディングタスクには依然として大きな差があることを示しています。
専門分野のベンチマークでも、結果は一様ではありません。
Vals AIによると、Finance Agent v2.1のスコアは66.68%でした。一方、Tax Agent Benchは前世代の49.7%から40.35%に、Legal Research Benchは46.2%から41.35%に低下しました。
したがって、金融、税務、法務向けにAIモデルを評価する企業は、総合的な知能ランキングだけに頼らず、タスク固有の結果を優先すべきです。
Vals AIの詳細な結果 · Qwenが公開したベンチマーク比較

3つの実環境テスト:Qwen4-Maxは実際に何を構築できる?
ベンチマークスコアだけでなく、開発者たちはすでに公式モデルを使った実行ログや動作例を公開しています。
以下の3つのテストでは、ウェブアプリ生成、モデル間のデザインの違い、推論設定が速度とトークン消費量に与える影響を紹介します。
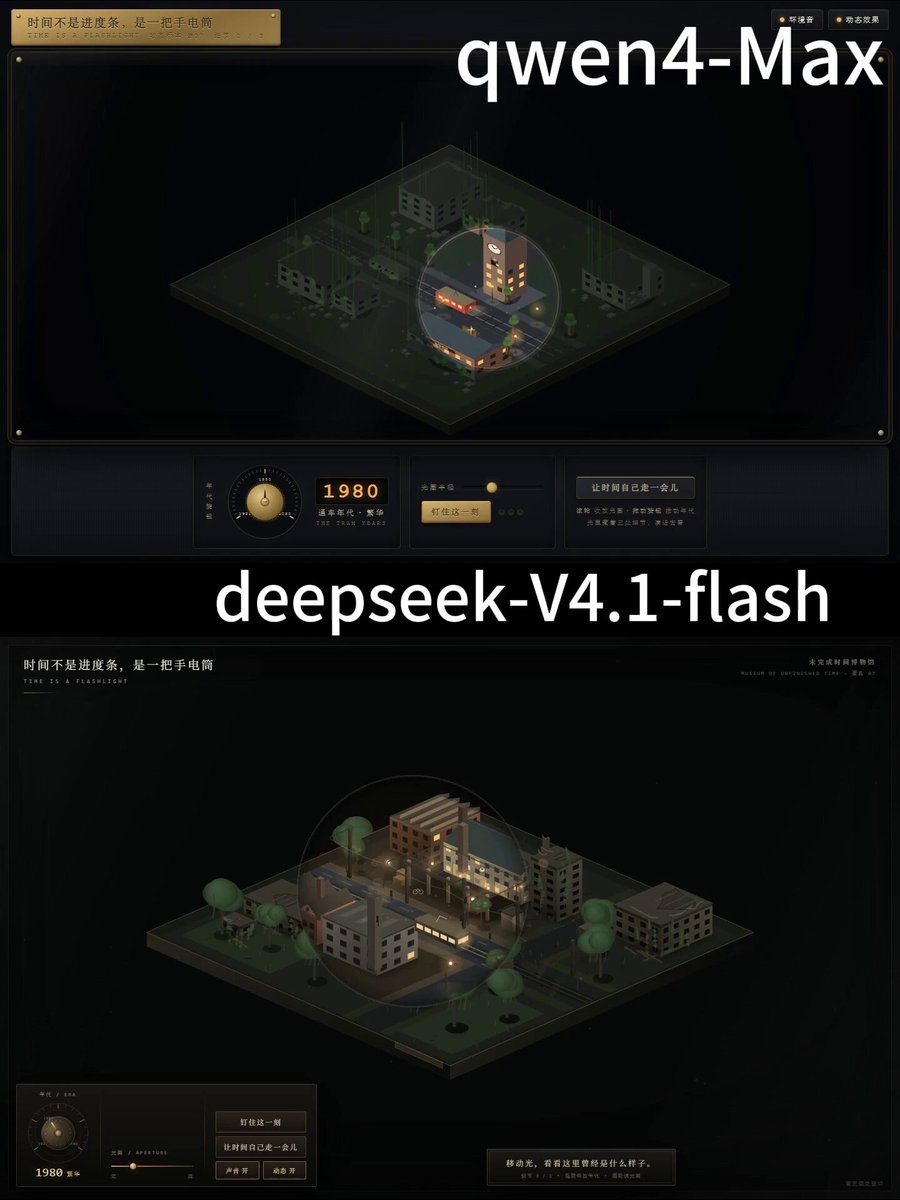
1. 同じウェブ開発タスク:Qwen4-MaxはDeepSeek V4.1 Flashより31分24秒速く完了
開発者のDensityluckyは、Qwen4-MaxとDeepSeek V4.1 Flashに同じタスクを与えました。それは、ガラスケースの中に表示されるインタラクティブなミニチュア都市を構築することです。
マウスカーソルは「時間の懐中電灯」として機能します。シーン上を動かすと、都市のさまざまな部分が1920年、1980年、2080年にどう見えるかが表示されます。
異なる時代でも建物の位置関係は揃っていなければなりません。また、複数の時間帯を固定し、同じ地図上で異なる時期を比較できる必要があります。
両モデルとも、選択した時代に応じて建物が変化する動作デモを生成しました。
Qwen4-Maxのデモではさらに、複数の固定した時間帯を同時に表示できました。
開発者が報告した完了時間は次のとおりです。
| モデル | 完了時間 |
|---|---|
| Qwen4-Max | 13分31秒 |
| DeepSeek V4.1 Flash | 44分55秒 |
このテストでは、Qwen4-Maxは31分24秒早く完了しました。
ただし、開発者はどちらのモデルについても、推論設定の詳細、APIコスト、項目別の受け入れテスト結果をすべて明らかにしていません。これらの所要時間を、一般的な相対速度の指標と解釈すべきではありません。
2. Arenaの並列テスト:Qwen4-Max、GPT、Claudeのデザインの違い
ArenaのPeter Gostevは、ボクセル風のローマ都市、3Dシーン、小規模なゲーム、インタラクティブなウェブサイトなど、モデルが生成したプロジェクト集を公開しました。
特に参考になる例が、レースイベントのダッシュボードです。
Qwen4-Maxは、コース、レース統計、ドライバー一覧を、コンパクトで情報量の多いコントロールパネルに配置しました。
GPT-6.1 Solはコースの可視化により広いスペースを割り当て、中心的なビジュアル要素にしました。
どちらのデザインも主な要件を満たしていましたが、レイアウトの判断は異なっていました。
この比較から、どちらかのモデルがあらゆる場面で優れているとは言えません。ただし、開発者が自分の要件にどちらのモデルのデザイン判断がより合うかを評価する助けにはなります。
結果を直接確認するには、まず13:36のウェブサイトデザインの動画から始め、次に15:47のウェブユーザビリティ比較へ進んでください。
3. Simon Willisonのテスト:xhighはhighより6分近く長くかかった
開発者のSimon Willisonは、OpenRouterを通じてQwen4-Maxを4つの推論設定と同じプロンプトでテストしました。
Generate an SVG of a pelican riding a bicycleタスクは、自転車に乗るペリカンのSVGイラストを生成することでした。
結果は次のとおりです。
| 推論設定 | 時間 | 出力トークン(推論を含む) |
|---|---|---|
| 無効 | 1分01秒 | 3,766 |
| low | 1分31秒 | 5,702 |
| high | 1分37秒 | 6,362 |
| xhigh | 7分23秒 | 26,295 |
そのxhigh出力には、青緑色の自転車、赤いスカーフ、尾が外に出ている魚など、追加の視覚的ディテールが含まれていました。
ただし、highと比べて約4.5倍の時間がかかり、出力トークンも約4.1倍消費しました。
Willison氏は同じプロンプトでQwen3.8-Maxもテストしました。
全体的にはQwen4-Maxの結果を高く評価しましたが、xhighの出力だけを比較すると、前世代モデルが生成したイラストを選びました。
このテストは、より高い推論設定が必ずしも優れているわけではない理由を示しています。推論トークンを追加すると細部が改善することはありますが、毎回より良い結果が保証されるわけではなく、レイテンシとコストも増加します。
Qwen4-MaxはQwen3.8-Maxよりどれだけ安い?
性能が向上しただけでなく、Qwen4-Maxはベンチマークタスクの完了にかかる平均コストも大幅に削減します。
Artificial Analysisは、両世代をxhigh推論設定で評価し、次の結果を報告しました。
| 指標 | Qwen3.8-Max | Qwen4-Max |
|---|---|---|
| Intelligence Index | 34 | 43 |
| タスクあたりの平均コスト | US$10.02 | US$3.27 |
| タスクあたりの平均出力トークン数 | 約171,000 | 約105,000 |
このベンチマークでは、タスクあたりの平均コストが約67%減少しました。
この削減の一部は、API価格の低下によるものです。新しいモデルは、同じベンチマーク一式を完了するために使用した出力トークンの平均数も少なくなっています。
Alibabaは、自社のWork360評価でも同様の傾向を確認しています。
Qwen4-Maxはスコアを47.74から52.69に向上させ、タスクあたりの平均コストをUS$4.43からUS$1.67へと、約62%削減しました。
ただし、Work360はベンダーが報告した評価です。使用したタスク、設定、価格前提がArtificial Analysisとは異なるため、2つのコスト値を合算すべきではありません。
Qwen Work360のコスト結果 · Work360のベンチマークスコア

実際の開発ワークフローでは、初回生成、再試行、デバッグ、必要な人手による介入を含め、受け入れ可能な結果に到達するまでの総コストのほうが有用な指標です。
Qwen4-Maxの使い方:どこで試せる?
Alibabaは、Qwen4にアクセスする方法としてQwen Studio、QwenWork、Qoderを挙げています。
テキスト生成やコーディング機能を気軽に試したいだけなら、公式製品のいずれかから始められます。
モデルをアプリケーションやエージェントシステムに統合したい開発者は、Alibaba Cloud Model StudioまたはOpenRouterを利用できます。
- Qwen Studio · オンラインでQwenモデルを試す
- QwenWork · Qwenの業務向けAI体験
- Qoder · AIを活用したソフトウェア開発
- Alibaba Cloud Model Studio · APIモデルID:
qwen4-max - OpenRouter · APIモデルID:
qwen/qwen4-max
公式のQwen4-Maxリリースは、OpenAI Chat Completions、Responses、Anthropic Messages、DashScopeの各インターフェースに対応しています。
ツール呼び出し、並列ツール呼び出し、構造化JSON出力にも対応しています。
以前のqwen4-max-previewモデルはToken Planで提供されていました。公式のqwen4-maxモデルは現在、従量制のAPI課金に対応しています。
モデルを統合する際は、プレビューモデルではなく公式リリースを選択していることを確認してください。
Alibaba Cloudのドキュメント · プレビューモデルのドキュメント
Qwen4-Max API料金
Alibaba Cloud Model Studioの料金は、デプロイ地域によって異なります。
次の表は、2026年11月16日時点で確認した公開標準料金を示しています。すべての料金は100万トークンあたりです。
| 地域とデプロイ範囲 | 入力 | 出力 | キャッシュヒット |
|---|---|---|---|
| 米国バージニア — グローバルデプロイ | US$1.413 | US$4.24 | US$0.071 |
| シンガポール — 国際デプロイ | US$1.50 | US$4.50 | US$0.075 |
| 北京 — 中国本土デプロイ | ¥10 | ¥30 | ¥0.50 |
推論トークンは出力トークンとして課金されます。
上記のキャッシュヒット料金は、キャッシュ作成料金とは異なります。明示的なキャッシュ作成には別途料金が発生する場合があります。
同じデプロイ地域のQwen3.8-Maxと比較すると、Qwen4-Maxの標準入力・出力トークン料金は、バージニアで約14.4%、シンガポールで25%低くなっています。
APIを使う前に開発者が知っておくべきこと
Qwen4-Maxは最大100万トークンのコンテキストウィンドウに対応しており、長い文書や大量のプロジェクトコンテキストを扱うタスクに適しています。
ただし、長いコンテキストを受け入れられることは、その中のすべての詳細をモデルが正確に取得・参照できることを保証するものではありません。
推論設定は、出力トークンの使用量、レイテンシ、コストにも影響します。開発者はすべてのタスクでxhighを自動的に使うべきではありません。
Alibaba Cloud Model Studio経由でQwen4-Maxを統合するには、適切な地域のAPIキーを作成し、対応するAPIエンドポイントを設定して、モデルIDをqwen4-maxに設定してください。
OpenRouterを使う場合、モデルIDはqwen/qwen4-maxです。モデルページには、推論設定と料金に関する情報も掲載されています。
Qwen4-Maxは使う価値がある?
フロントエンドのプロトタイプ、インタラクティブなウェブサイト、または明確な受け入れ基準のある開発タスクに取り組んでいるなら、Qwen4-Maxを試す価値があります。
実用的な評価方法は、よく知っているプロジェクトのスクリーンショットを用意し、Qwen4-Maxと現在使っているモデルに同じタスクを与えることです。
まずhigh推論設定から始め、具体的な受け入れ基準をいくつか定めます。
- レイアウトがリファレンスに近いこと。
- 主要なインタラクティブ機能が正しく動作すること。
- 狭い画面でもページが使いやすいこと。
次に、それらのチェックに合格するために必要だった合計時間、トークン消費量、再試行回数、手動変更を記録します。
追加コストによって意味のある改善が得られる場合にのみ、推論設定を上げてください。
チームが現在、リポジトリの保守、複雑なターミナル操作、長時間実行するエージェントワークフローでOpus 5.5またはKimi K3.1 Proに依存しているなら、移行前に、最も頻繁に行う実際のタスクでQwen4-Maxをテストしてください。
ターミナルプログラミングや専門的なワークフローにおける独立ベンチマークの結果だけでは、これらのモデルを完全に置き換えられるとはまだ言えません。
今回のリリース結果は、複数の領域、特にウェブ開発でQwen3.8-Maxを大幅に上回る改善を示しています。API料金とタスクあたりの平均コストも低下しました。
Qwen4-Maxが既存の最先端モデルを置き換えるべきかどうかは、最終的には実際のワークロードにおけるタスク完了率、レイテンシ、総コストによって決まります。
注:この記事は、2026年11月16日の公式Qwen4-Maxリリース前後に公開された初期結果をまとめたものです。Arenaのランキングは変動し、一部の結果はまだ暫定的です。Artificial AnalysisとVals AIは独立した評価を提供しています。一方、Work360、ProgramBench、その他Alibabaが公開した結果は、ベンダー報告のベンチマークとして識別しています。個々の開発者テストは特定のタスクにおける性能を示すものであり、モデルの包括的な評価とみなすべきではありません。